программирование
ИИ: распознавание рукописного текста
Я
Музыка и песни, генерируемые нейросетями, привлекали своей необычностью лет десять назад, но сейчас уже
В общем, я при помощи нейросетей много работаю с текстами разной природы, а к остальному в основном глух.
Поэтому я
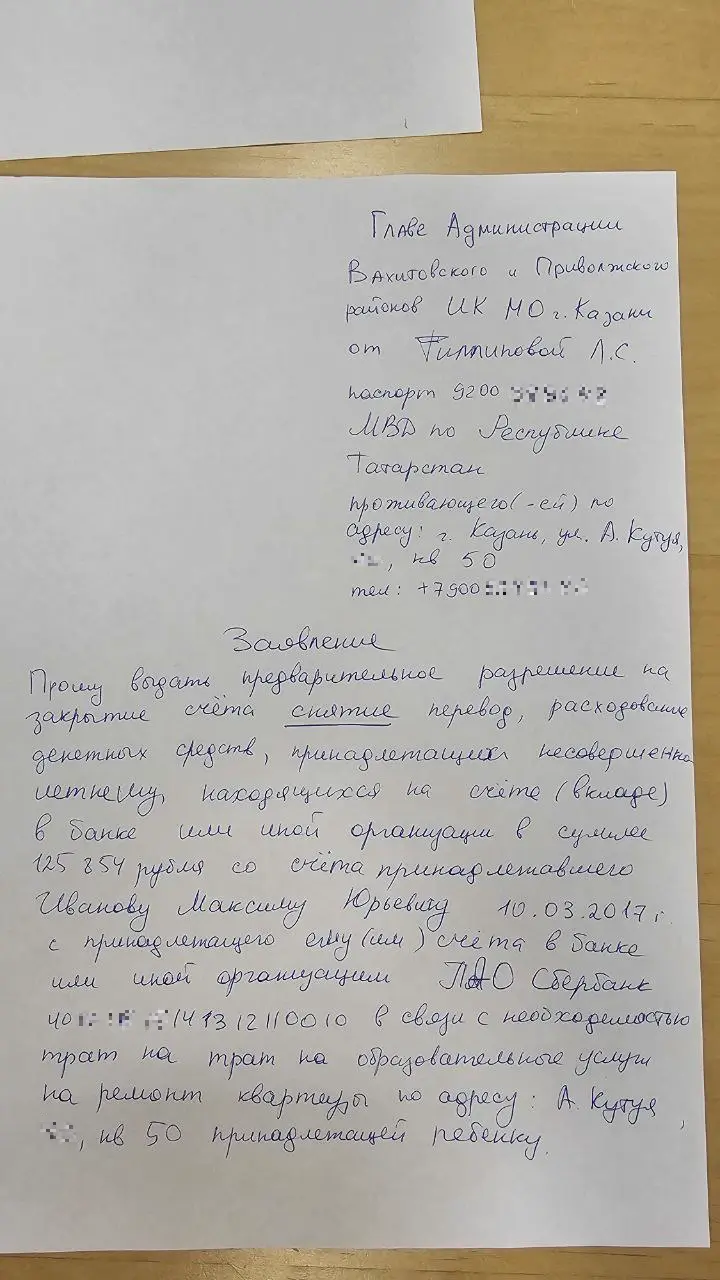
В общем, я глазам не поверил, когда мы попробовали вышеупомянутым «Квеном» распознать текст на фотографии: распозналось всё идеально, причём сеть ещё и ошибки поправила (правда, не уверен, что это хорошо). Понимаю, это не самый непонятный почерк, но этот листок — наш первый эксперимент.
Потом мы ещё много экспериментировали, но сказать, что я читаю рукописный текст значительно лучше нейросети, значило бы соврать. Мне иногда помогает более широкий контекст: например, я знаю татарские имена, а «Квену» они плохо знакомы, и он может их перевирать, если они написаны не очень разборчиво.
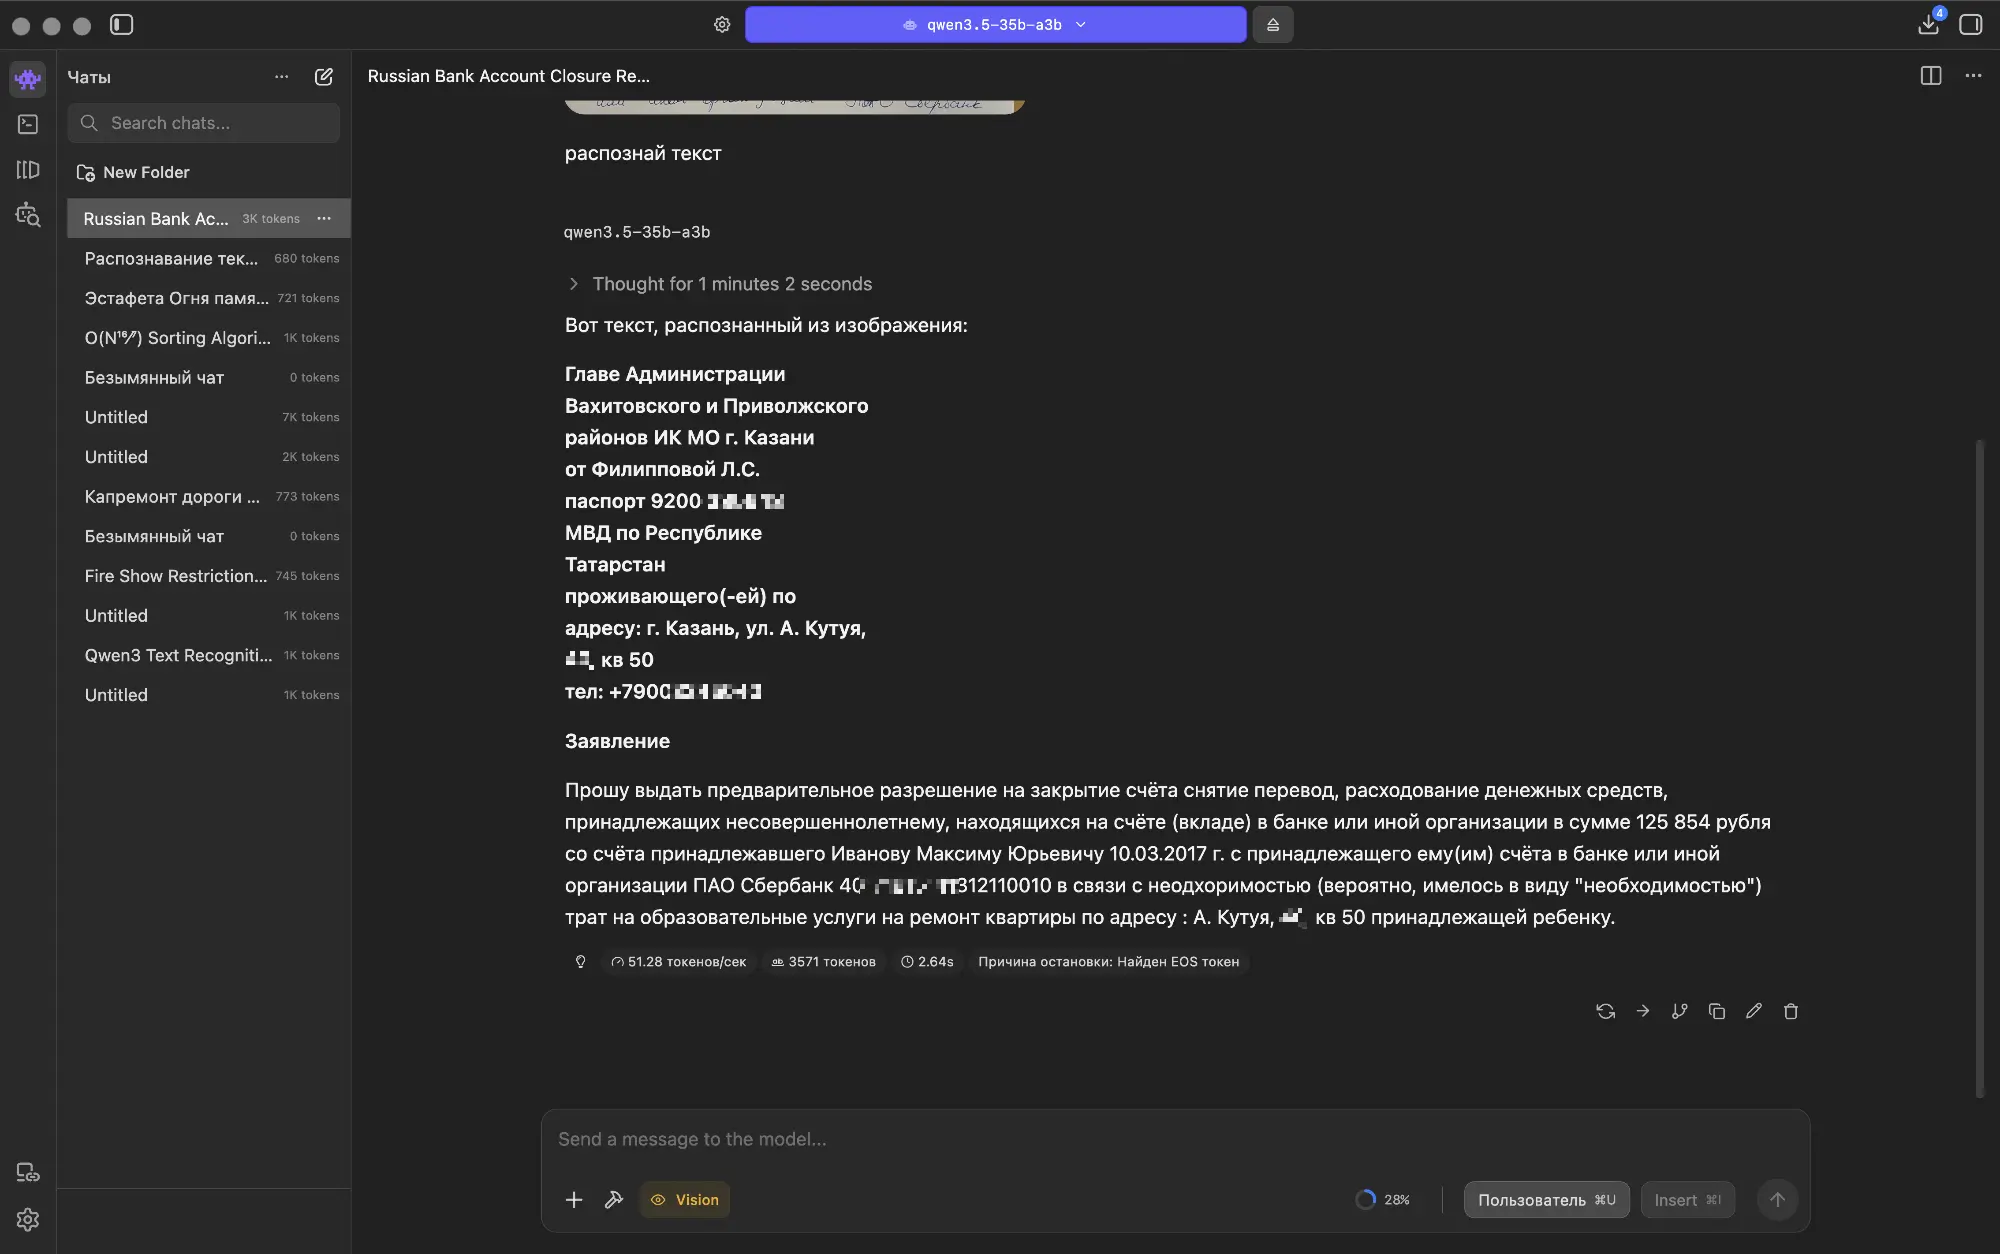
Добавлено позднее: уже позже, ближе к ночи я решил попробовать развернуть эту модель, квантованную до четырёх бит на своём ноутбуке, по памяти она как раз должна была влезть, — чтобы попробовать как она справится. Справилась отлично, но мне не удалось выключить режим размышлений, не нашёл такого параметра в LM Studio, где я её запускал, а с ним она работает гораздо медленнее.
Один из читателей в моём телеграмном канале написал, что у него с текстом справилась сеть «Гемма4» на смартфоне.
ИИ: сингулярность
Я считаю, что сингулярность наступила в феврале, просто этого пока почти никто не заметил. В феврале в доступе появилась модель, которая пишет код лучше, чем средний программист, которых я на своём веку встречал немало. Когда я её попробовал, почувствовал, как будто у меня появилась персональная команда программистов, которую я могу дёшево использовать для проверки своих гипотез.
Пошёл уже второй месяц использования, и я ошибался только в одном — это недёшево. Я привык к другим ценам. В день легко можно израсходовать больше ста долларов только на одном агенте. В рамках проверки рабочих гипотез это очень дёшево, но для хобби пока дороговато. Цены, уверен, будут падать, а пока я учусь комбинировать нейросети разных уровней.
Я помню, что в начале развития интернета было сложновато научиться гуглить любой вопрос. Звучит странно, но так и было — поначалу это не вошло в привычку, нужно было буквально перестроить себя, чтобы научиться лезть в интернет за любым ответом. До этого мы просто отпускали такие вопросы, потому что узнать ответ было негде.
Сейчас приходится перестраивать себя, чтобы не отпускать идеи в духе «а что если?», а формулировать их как задания для нейросети. Не каждая идея, конечно, достойна того, чтобы её пробовать, но определённо стоит тратить несколько часов в неделю, чтобы реализовывать многое из того, что приходит в голову. Моя папка с проектами ещё никогда не пухла так стремительно.
С нетерпением жду появления ещё более способных нейросетей. Компания «Антропик» уже
Чувствую, уже очень скоро вся отрасль перейдёт от кодирования к летсплеям по написанию кода. Бывает, я с большим интересом наблюдаю, как модель размышляет, — чаще всего для того, чтобы не прозевать момент, когда она свернёт не туда и потратит мои токены и время впустую, но иногда это прям затягивает. Осталось только придумать для этого видеоформат.
«Виола»: тег TB
Всё это время я программировал с нейросетями, в основном с использованием самых мощных моделей, которые только доступны, но некоторое время назад решил изменить вектор. Теперь я, напротив, хочу посмотреть, на что способны более простые модели, в частности «Композер» (это дообученная открытая модель «Кими»), который входит в подписку «Курсора».
Для этого я использую свой любимый полигон — браузер «Виола». Я подыскал несколько несложных задач из разряда «найти бы место, а поправить можно за полчаса», то есть такие, где важно понять, где поправить; сама правка сложной не выглядит.
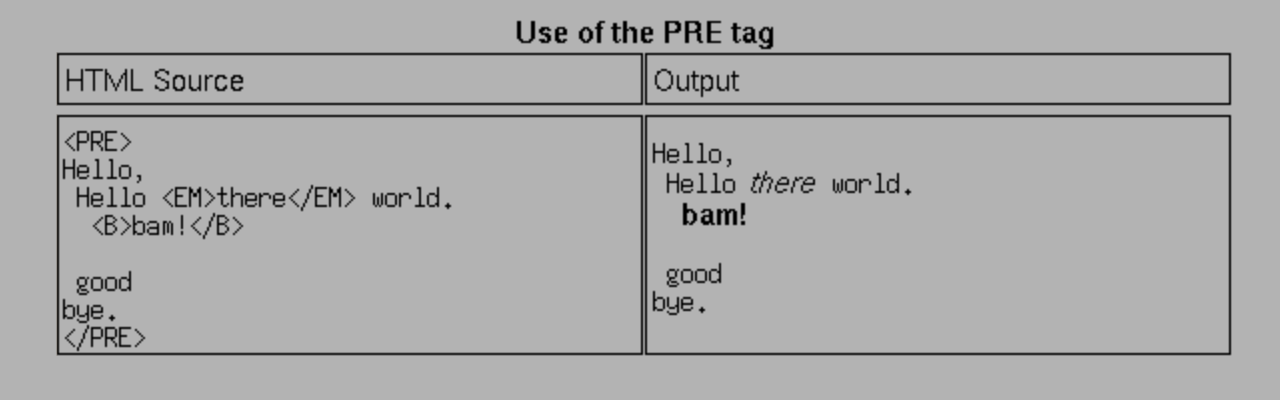
Одна из задач — дописать нестандартный тег TB, который автор так и не завершил. Судя по иллюстрациям в его недописанной книге о браузере, этот тег предназначался для разрыва таблицы: на рисунке он стоит между строкой «HTML Source / Output» и последующими. Вероятнее всего, TB расшифровывается как Table Bar.
Модель «Композер 2.0» справилась с задачей, в принципе, на «отлично» — лучше и желать нельзя. Моментально нашла место и поправила всё как надо с первой попытки.
Интересно, кстати, что иллюстрации в книге не совпадают с реальным поведением браузера. Такое ощущение, что автор браузера их либо дорисовывал потом в редакторе, либо
GPU: B300
Ребята из компании «Селектел» (большое спасибо!) дали нам на несколько дней потестировать блок графических ускорителей NVIDIA DGX B300 Supermicro HGX B300. На данный момент это одно из самых производительных решений в одном корпусе.
Для меня, как техногика, это примерно как если бы
Думаю, эту штуковину было совсем не просто купить, учитывая, что страна находится под санкциями, да и разместить её тоже непросто.
Блок занимает десять юнитов в стойке; его габариты — 44 × 48 × 90 сантиметров, а вес — почти полтора центнера. Внутри — восемь ускорителей B300, водяное охлаждение, а потребляет всё это хозяйство до 19 киловатт.
Добавлено позднее: оказалось, что «Селектел» нам выделили Supermicro HGX B300. Спасибо одному из читателей, указавшему на ошибку. Я не до конца исследовал вопрос.
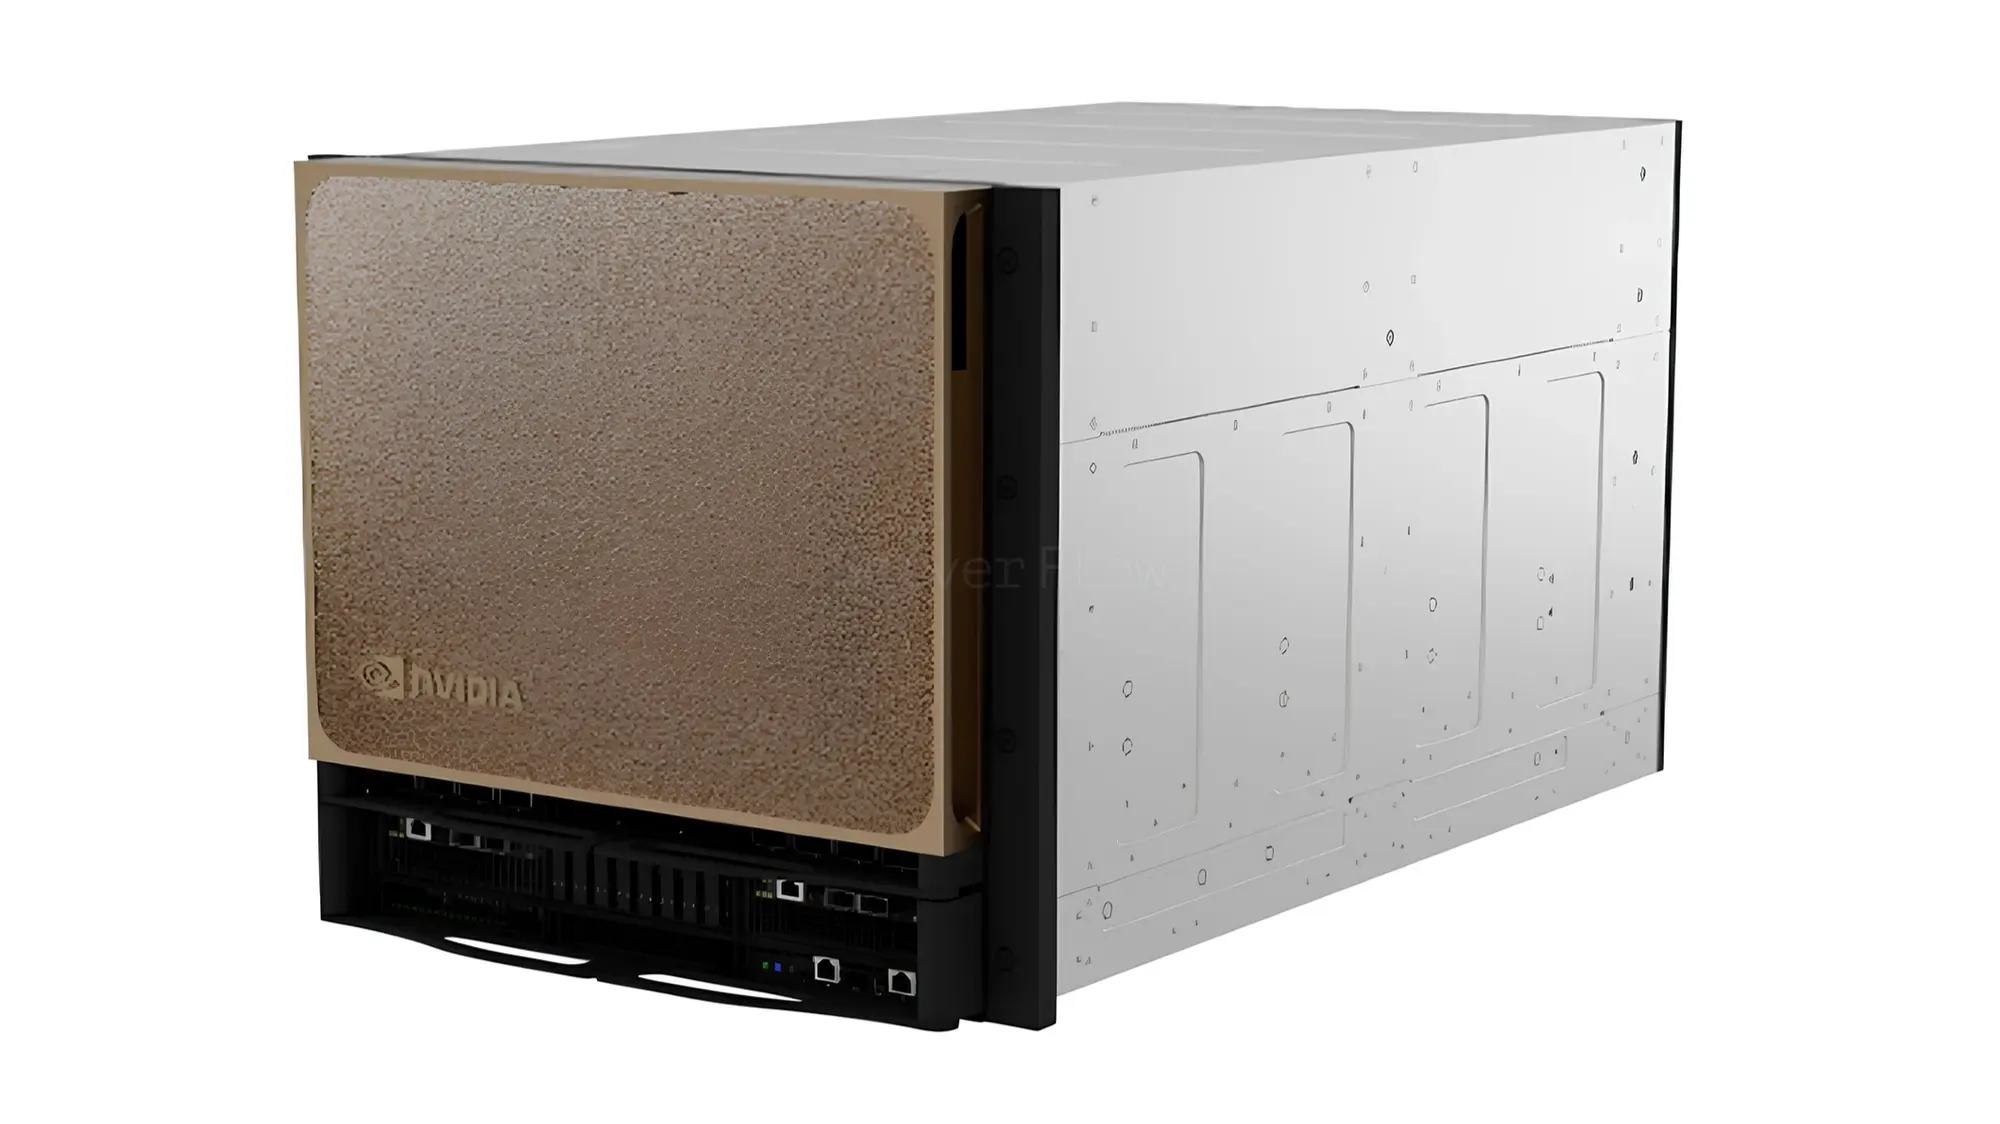
Помимо вполне понятного желания потрогать дорогую железку, у нас есть и практическая цель — понять, как соотносятся производительность такого решения и его цена. Мы сейчас активно внедряем искусственный интеллект у наших заказчиков, поэтому нам часто важно понимать, какое оборудование нужно под конкретную нагрузку.
Именно для этого мы и делаем все тесты, о которых я тут пишу: чтобы оценить относительную производительность доступных нам решений.
Сейчас у нас нет заказчиков, которым действительно понадобилось бы настолько серьёзное оборудование. Но понимать его возможности всё равно важно — хотя бы с прицелом на будущее.
Тесты одного ускорителя B300 я уже публиковал, и из них можно сделать такой вывод.
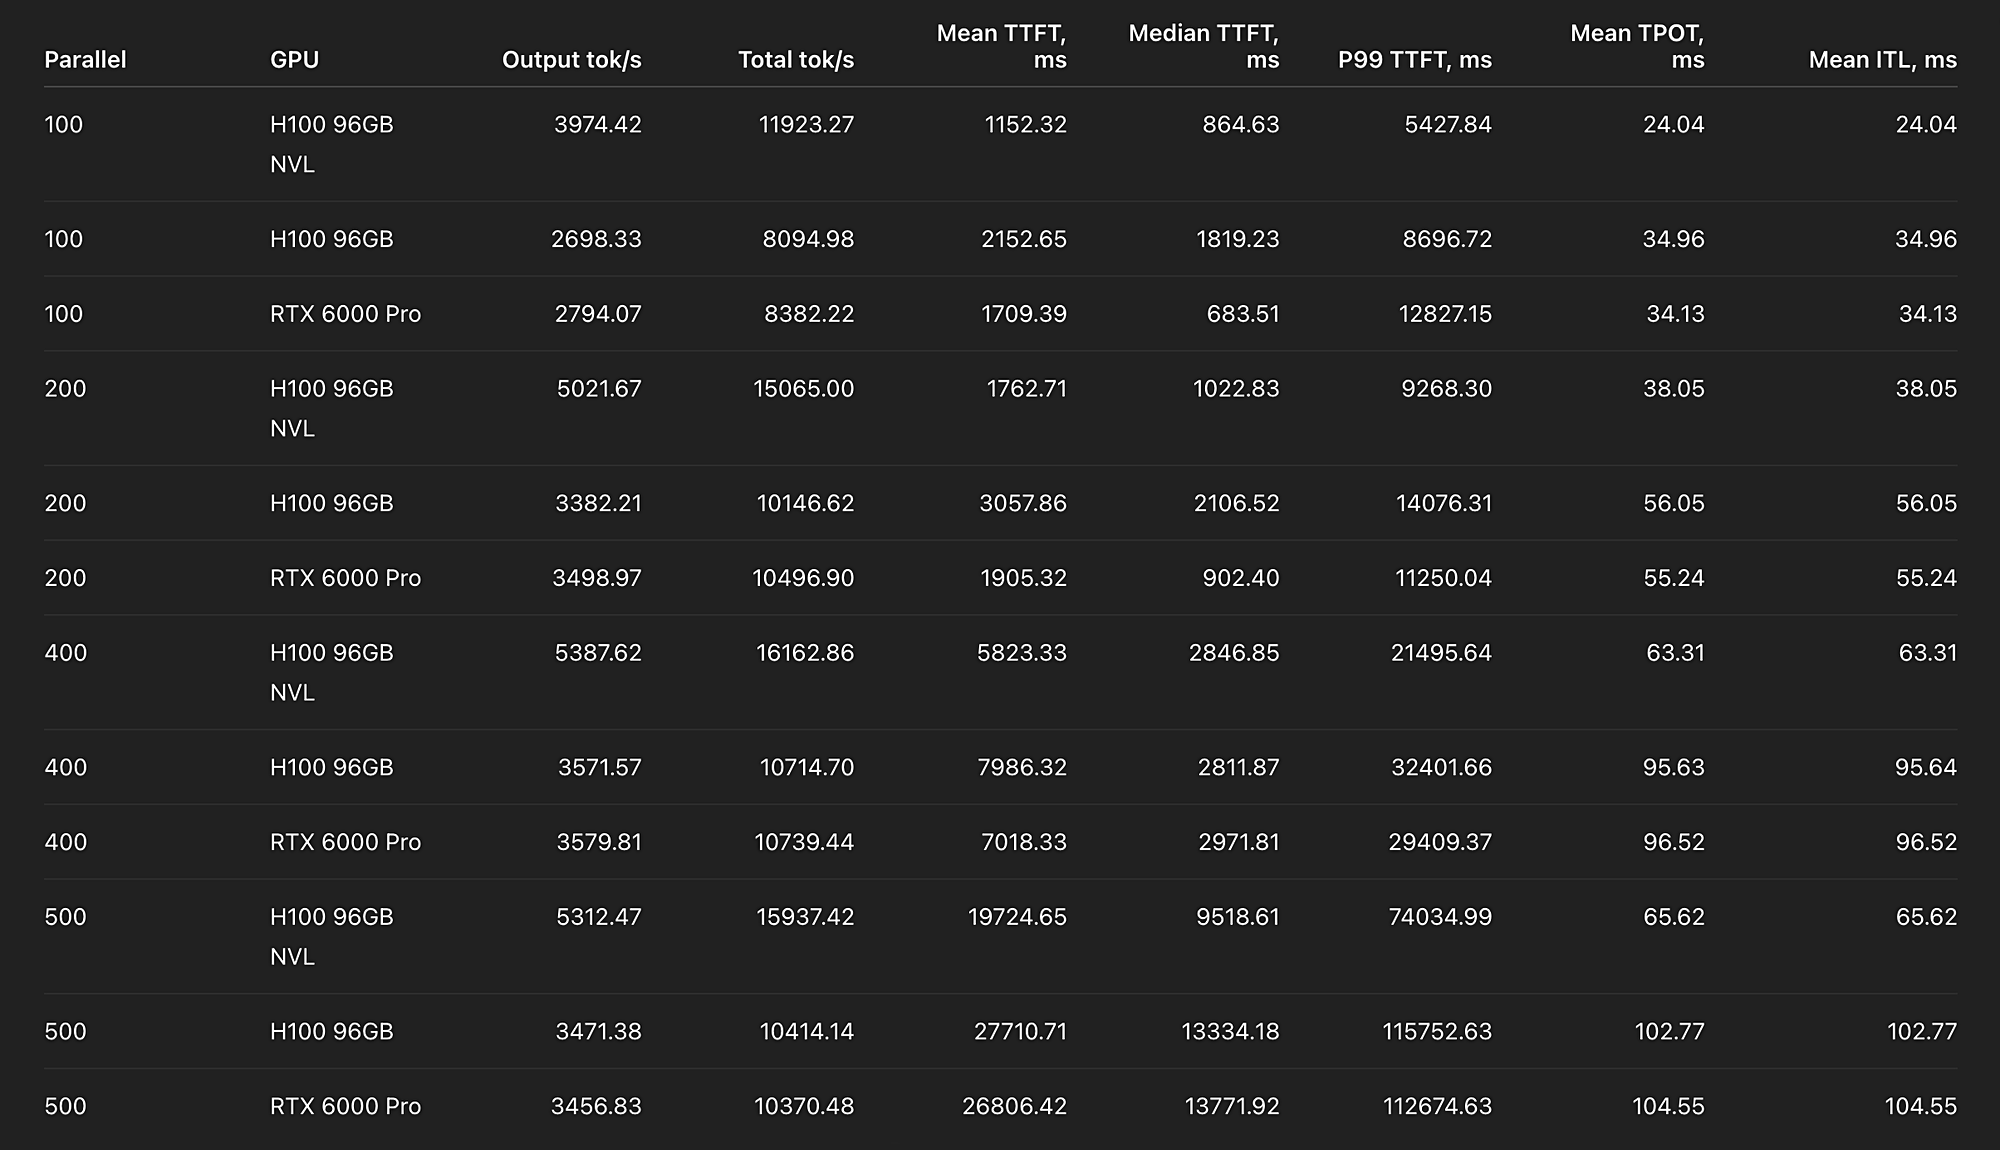
Одна B300 примерно в 1,8 раза быстрее, чем H100 NVL. H100 NVL, в свою очередь, примерно в 1,4 раза быстрее, чем RTX 6000 Pro. Модели, которые не помещаются в память одного ускорителя, мы пока не используем, поэтому для нас прежде всего интересны результаты именно на одной карте.
Но производительность всего кластера целиком тоже хочется протестировать. Правда сравнить с другими картами эти результаты не получится: ни у одной из них нет такого объёма видеопамяти, чтобы запускать модели сопоставимого уровня.
Единственная модель
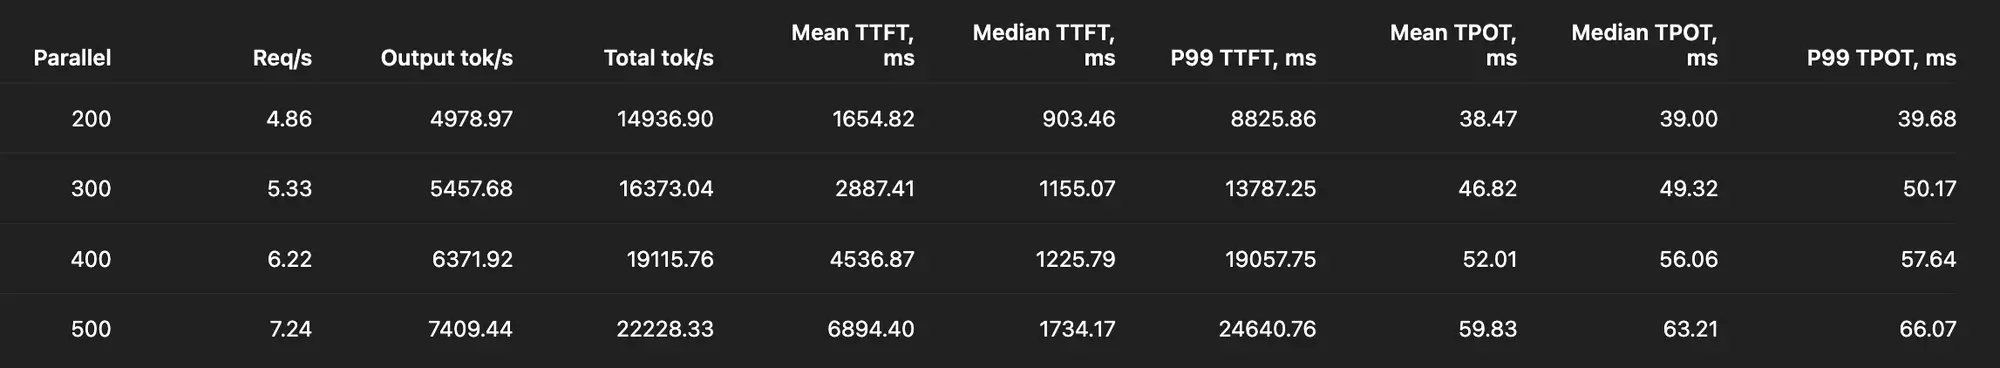
При росте параллельности с 200 до 500 общая пропускная способность увеличивается почти в полтора раза — с 14 900 до 22 200 токенов в секунду. При этом время до первого токена (P99 TTFT) ожидаемо растёт, но остаётся в пределах 24—25 секунд даже на максимальной нагрузке, а время генерации одного токена (P99 TPOT) — в районе 66 мс, что для модели на 397B параметров с разреженной архитектурой является очень достойным показателем.
К сожалению, из‑за нехватки времени мы не смогли разобраться с запуском ещё более тяжёлых моделей вроде
Но и полученные цифры уже дают заказчикам ориентир: если ваша задача требует обслуживания нескольких сотен одновременных запросов к ультра‑большой LLM, DGX B300 справляется с ней без перегрева и троттлинга, сохраняя предсказуемую задержку.
GPU: B300 vs H100 NVL vs H100 vs RTX 6000 Pro
А это сырые пока данные, сведённые из нескольких разных тестов по двум разным моделям — полной
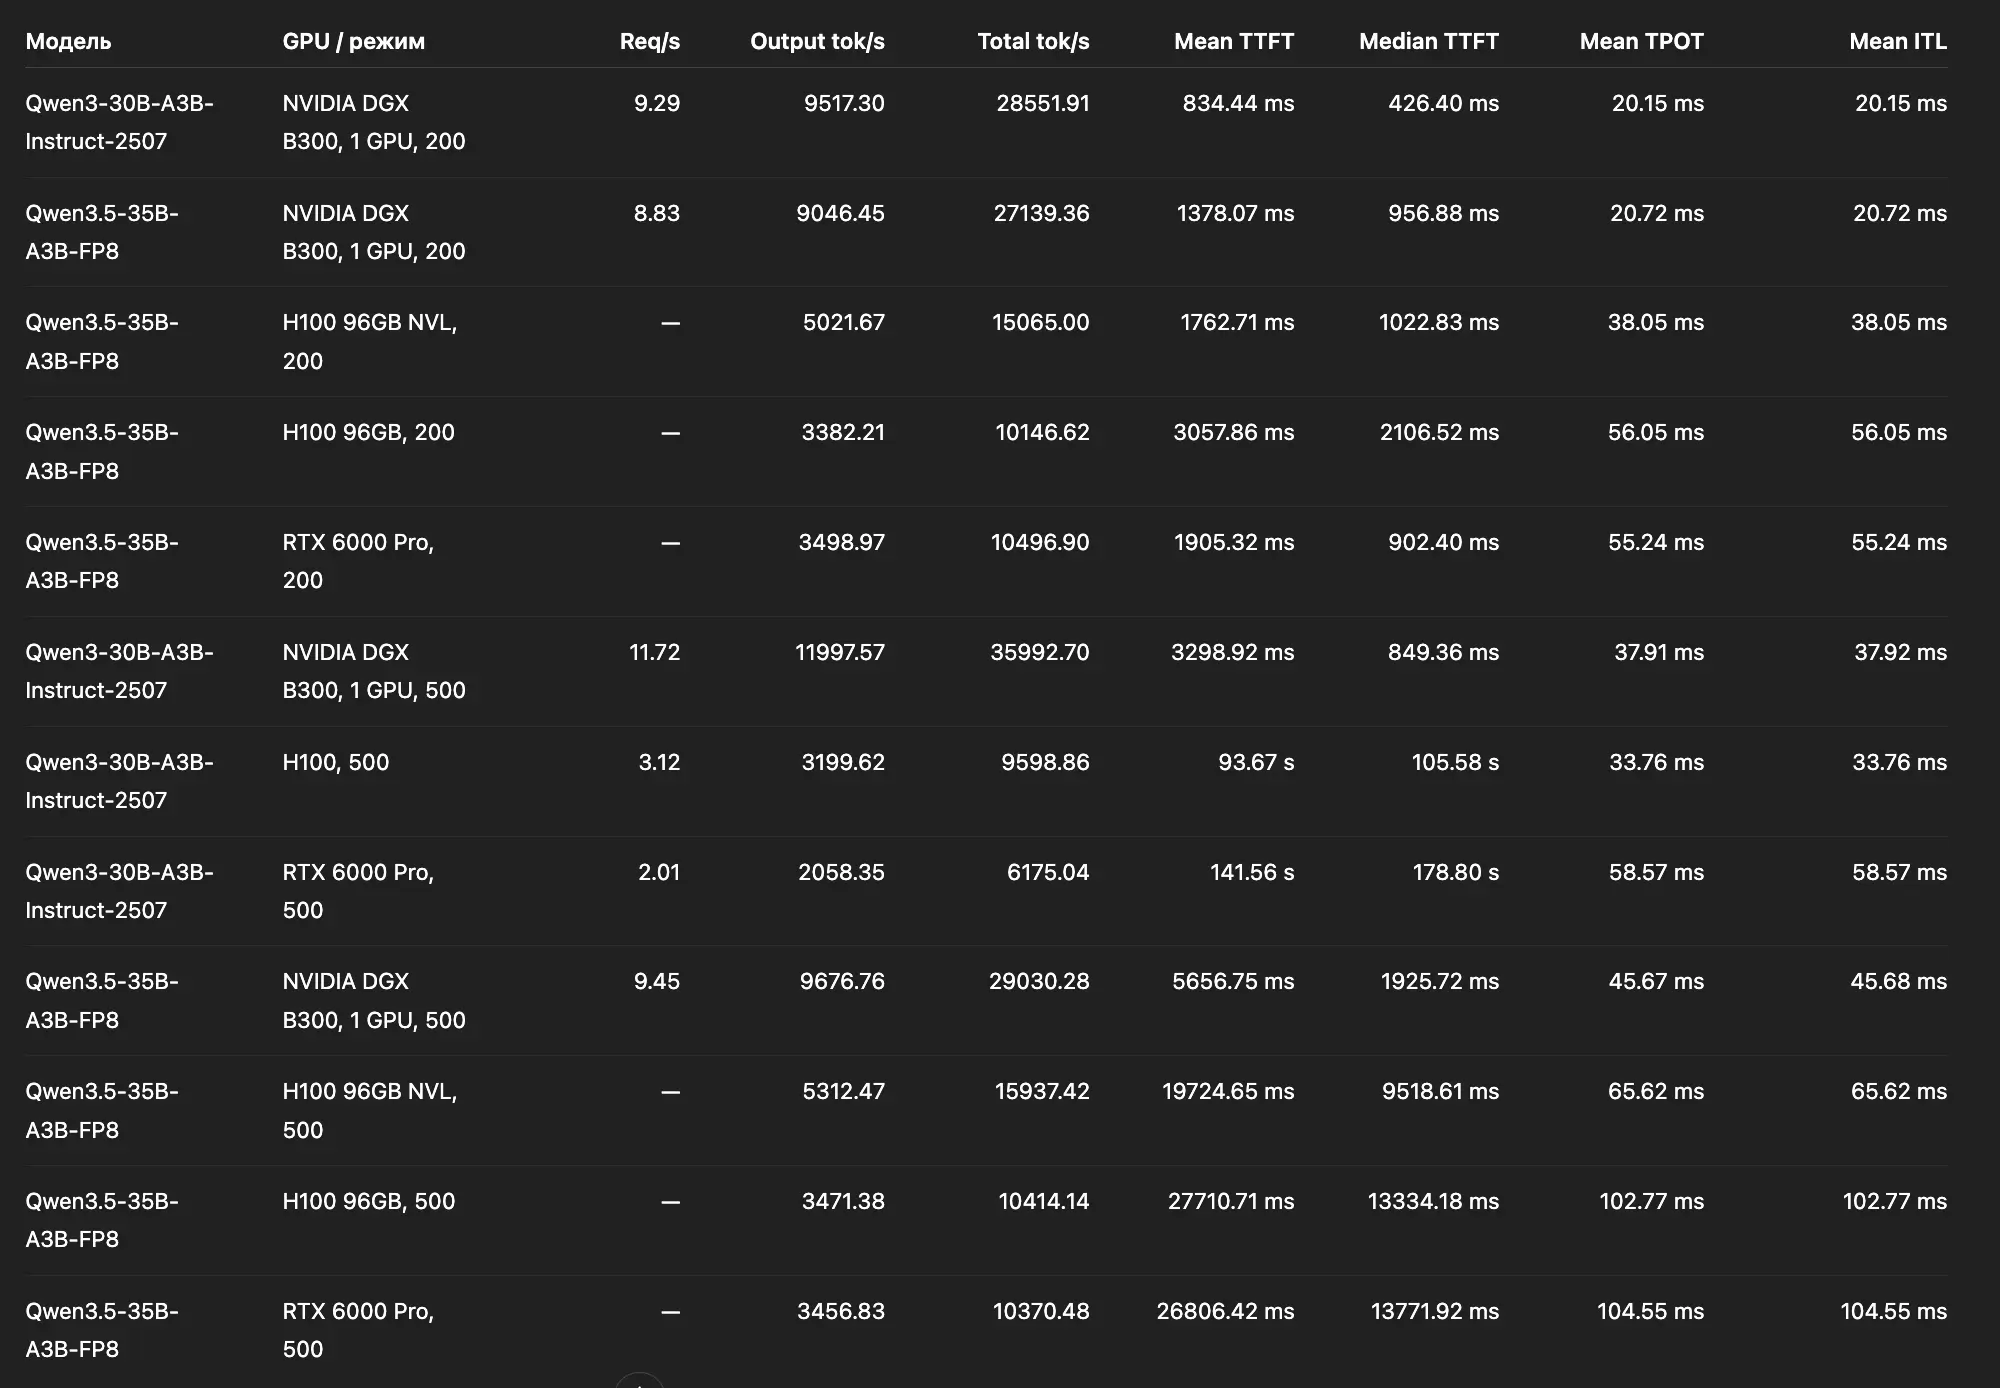
GPU: RTX 6000 Pro vs H100 на FP8
Так, кто там у меня в комментариях в телеграмном канале спрашивал о сравнении наших графических ускорителей при работе с сетями, квантованными до FP8 (однобайтового типа с плавающей точкой)?
Табличка ниже, использовался «Квен 3.5» с 35 миллиардами параметров (A3B).
Что мы тут видим? А видим мы очень интересную штуку: оказывается, ускорители H100 бывают очень разными. Инференс нашей тестовой модели показывает, что NVIDIA H100 NVL
Сравнение полноразмерного «Квена 3» я уже у себя публиковал.
Чтение образов NeXTSTEP
Если вам (ну вдруг)
Мне пришлось заняться этим вопросом, потому что я надеялся, что внутри одного из найденных образов этой системы меня могут ждать новые открытия, связанные с браузером «Виола».
Пользоваться утилитой не очень удобно, особенно если не вполне ясно что ищешь, но её довольно просто подключить к известному файловому менеджеру mc (Midnight Commander).
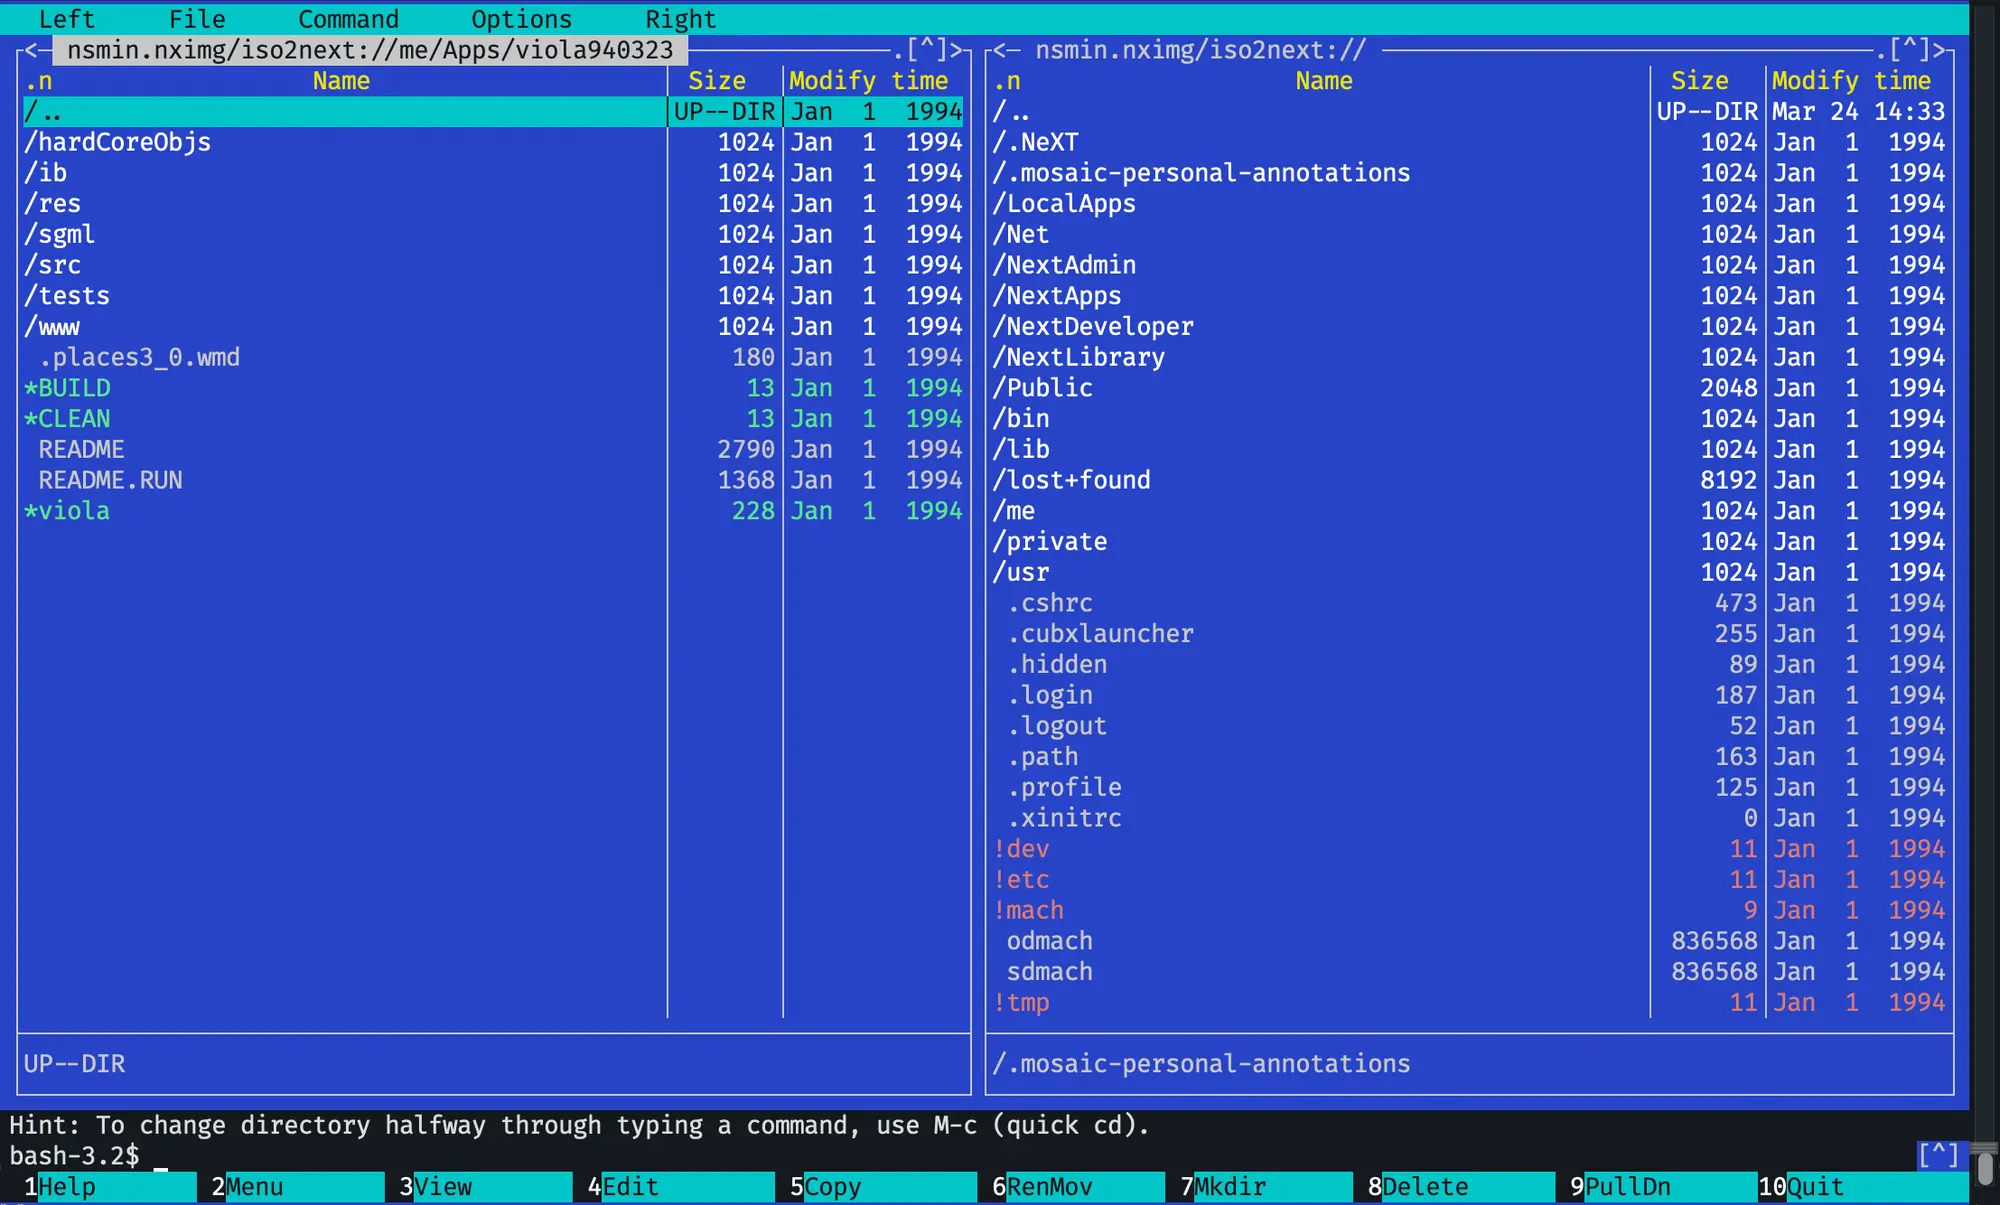
Достаточно написать обёртку, которая принимает на вход две команды — list (выдача списка файлов в директории) и copyout (копирование указанного файла в указанный путь), — и всё заработает.
Правда у исходной утилиты в листинге отсутствуют некоторые необходимые поля (в частности — дата), поэтому мне пришлось добавить заглушки на эти позиции. Я уже отправил автору утилиты патч, который устраняет этот недостаток (заодно я пару багов нашёл и исправил).
К сожалению, ничего полезного внутри образа я не нашёл, но опыт интересный.
TOIlet: цветные шрифты
Вчера я писал, что цветные шрифты — не самое важное расширение стандарта FIGlet. От своих слов я не отказываюсь, но это расширение точно одно из самых весёлых.
Напомню, что это шрифты, которые составлены из текстовых символов. Они могут использовать там, где, кроме текста, ничего нет — например, в текстовых файлах, в письмах без оформления, в консоли и так далее.
Идея цветных шрифтов простая: в консоли можно использовать цвета, которые задаются специальными управляющими последовательностями. Терминал не выводит их на экран как текст, а воспринимает как команды. Например: «с этого места рисуй всё зелёным».
Таких последовательностей довольно много, но для управления цветом обычно используют несколько основных режимов.
Немного истории. Сначала появились базовые цвета — классический набор из восьми цветов. Потом к нему добавили яркие варианты, и в результате получилась
Терминалы работают с разными палитрами, что они, как правило, умеют сообщать через переменные окружения. Например, у меня на «Маке» есть переменная COLORTERM со значением truecolor, что означает, что моему терминал можно отсылать
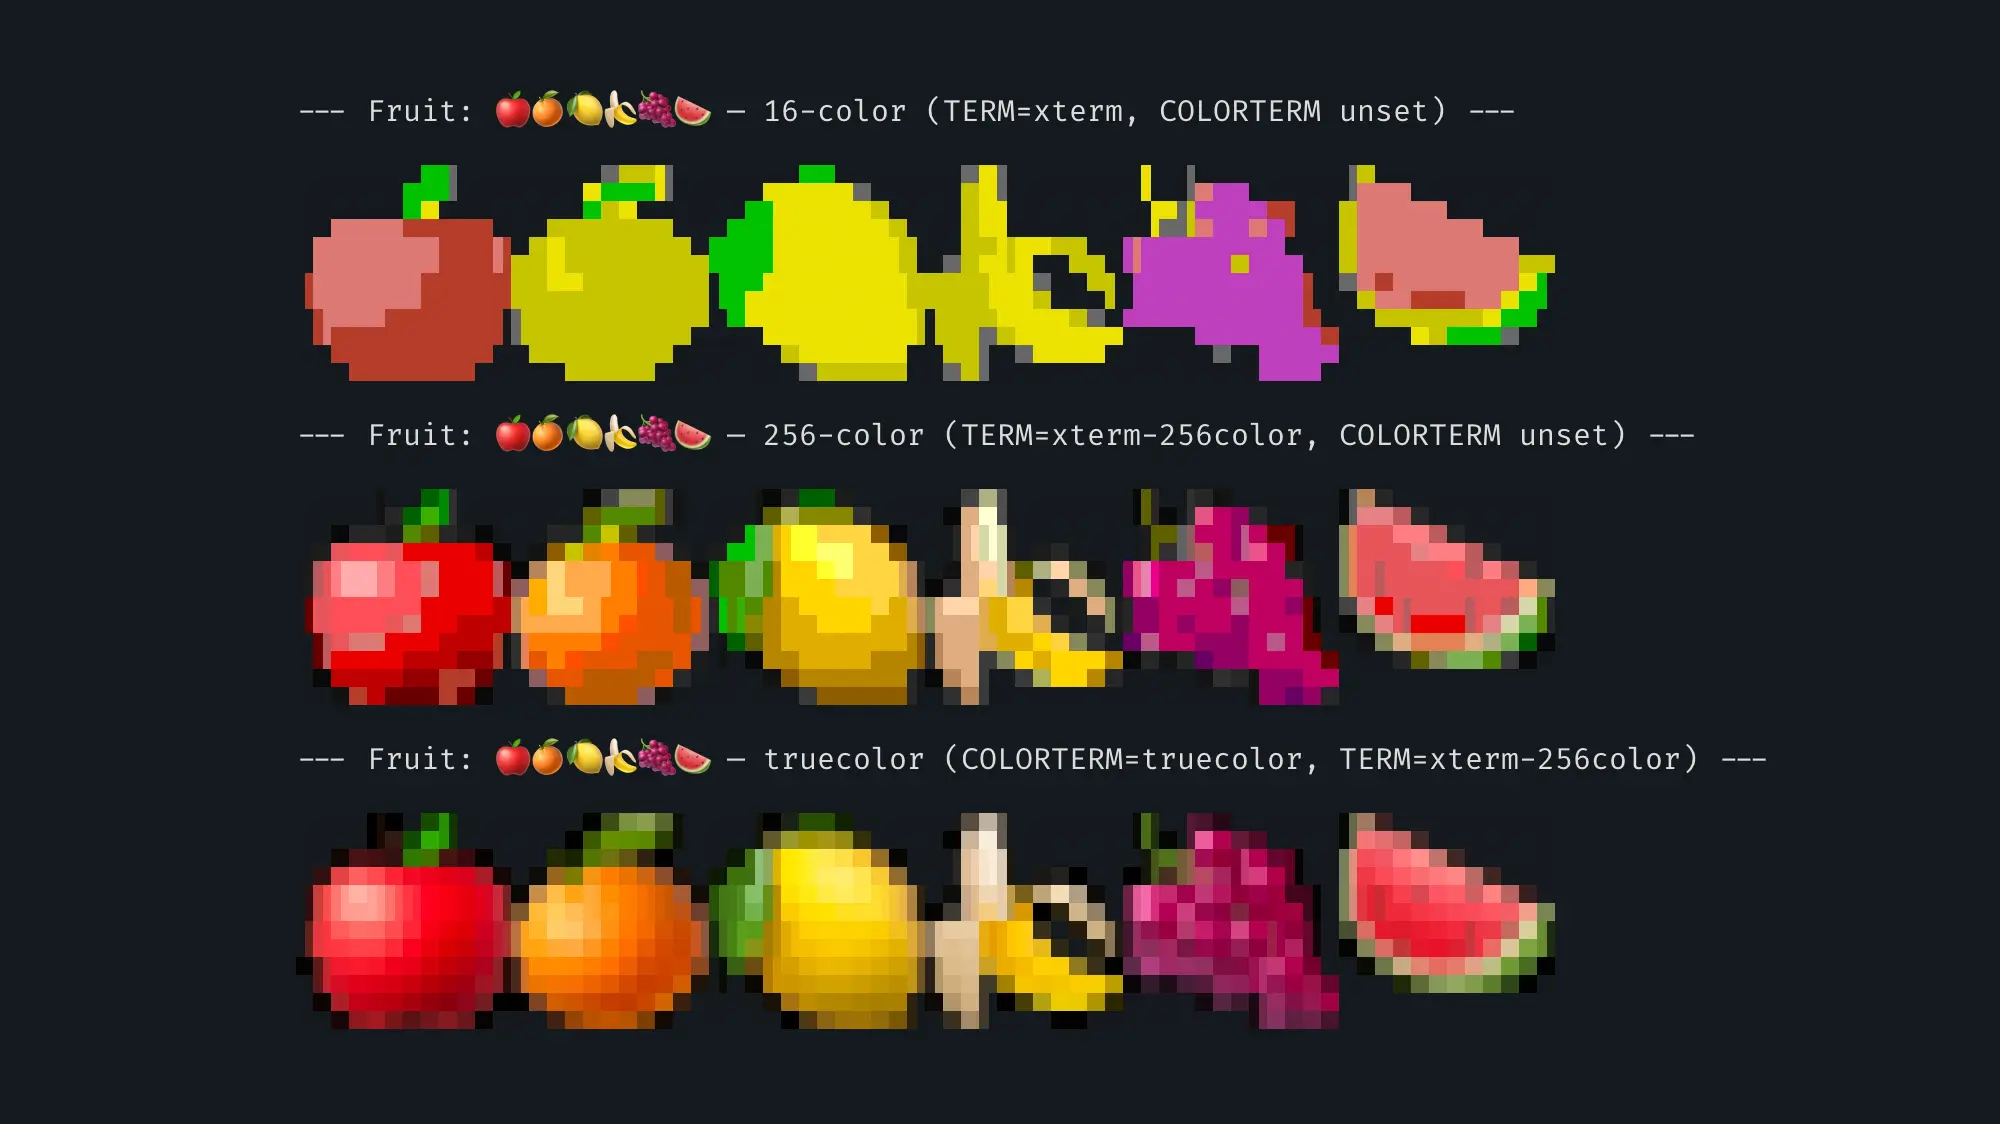
Когда я начал разбираться с форматом шрифтов TOIlet и библиотекой libcaca, которая их отображает (автор большой оригинал, да), оказалось, что внутри реализована идея цветных шрифтов, но ни одного примера такого шрифта нет. Судя по коду, он слегка не дописан, но тем не менее, вполне работоспособен, жаль только автор остановился на палитре из 16 цветов.
Так что, первое, что я сделал — создал из набора стандартных эмодзи цветной шрифт в формате TOIlet, где смайлики составлены из раскрашенных юникодных блочных символов. Результат мне не особо понравился. Например, местами некоторые оттенки жёлтого у меня съехали в белый
Я подумал, что было бы здорово расширить формат, но так, чтобы утилита toilet
Если посмотреть как libcaca парсит управляющие коды, то мы заметим, что парсер достаточно вольно обращается с грамматикой, не реагируя на некоторые ошибки, например, он пропускает все управляющие числа большие 107.
for(j = 0; j < argc; j++)
{
    /* Defined in ECMA-48 8.3.117: SGR - SELECT GRAPHIC RENDITION */
    if(argv[j] >= 30 && argv[j] <= 37)
        im->fg = ansi2caca[argv[j] - 30];
    else if(argv[j] >= 40 && argv[j] <= 47)
        im->bg = ansi2caca[argv[j] - 40];
    else if(argv[j] >= 90 && argv[j] <= 97)
        im->fg = ansi2caca[argv[j] - 90] + 8;
    else if(argv[j] >= 100 && argv[j] <= 107)
        im->bg = ansi2caca[argv[j] - 100] + 8;
    else switch(argv[j])
    {
        // парсятся 1—9, 21-29, 38, 39, 48—50

        default:
            debug("ansi import: unknown sgr %i", argv[j]);
            break;
        }
    }
}
Поэтому идея возникла такая. При кодировании цвета TOIlet использует цвет фона и шрифта, чтобы точнее имитировать пиксели в текстовом режиме. Иногда используется только один из них, чтобы реализовывать условную прозрачность. Это я пишу, чтобы рассказать, что у нас есть три варианта — указан цвет фона, указан цвет шрифта или указаны оба.
Если сразу за цветом в палитре из 16 цветов писать значение цвета, к которому я прибавлю такое число, чтобы оно гарантировано пропускалось парсером libcaca, то смогу спрятать от него там более точные значения цвета.
Например: \e[31;287;41;297m. Тут \e[ — начало специальной последовательности управляющих кодов (\e в реальности — символ с кодом 27, он никак не отображается, а только говорит, что дальше идёт команда).
Потом 31 — установка фона в красный, 287 — код цвета
Следующим идёт, как возможно вы уже догадались, установка цвета шрифта, 41 — это тоже красный цвет, но для шрифта, коды разные, надо же отличать что именно мы устаналиваем. За ним — 297, принцип тот же, но так как тут значение идёт сразу после кода установки цвета шрифта, то мы понимаем, что и тут ставится цвет шрифта.
Символ m закрывает управляющую последовательность.
Таким образом утилита toilet и её библиотека libcaca увидят последовательность \e[31;41m, а мой парсер выкинет числа
При этом, если мой парсер таких числе не видит, то он читает цвет
С цветом RGB работает всё так же, только прибавляем 512. Правда цвет у меня кодируется в обратном порядке — BGR, потому что синяя компонента у́же всего используется в эмоджи, а красная — шире, поэтому если развернуть значения, числа получаются меньше и шрифт становится компактнее. Я думаю это оттого, что синий цвет хуже распознаётся глазом, недаром все градиенты во времена эпохи 256 цветов на мониторах старались делать синими.
Шрифты, конечно, получаются просто огромными — по несколько мегабайт, но здесь помогает сжатие: и FIGlet, и TOIlet поддерживают сжатые шрифты.
Для конвертации эмодзи я написал конвертер на «Пайтоне», который преобразует их в шрифт отдельно в 256 цветах и в полноцветной палитре: хранить все варианты цветов было бы слишком накладно. А библиотека при отображении уже сама приближает цвет, если это требуется для конкретного терминала.
Вот, кстати, где ИИ сильно у меня начал буксовать — на задаче как компактнее спрятать новые цвета в старом формате. Сначала пришлось подумать самому, а потом уже пошло веселее — «Опус 4.6», который я не устаю нахваливать, подхватил идею и мы с ним быстро проверили различные гипотезы.
Добавлено позднее: реализацию всего вышесказанного можно увидеть в моём репозитории на «Гитхабе».
Figlet: шрифты из текста
Думаю, когда человек впервые увидел слова, которые вывел первый компьютер на первый дисплей, сразу же захотел большего — вывести туда ещё и картину. Но первые дисплеи были
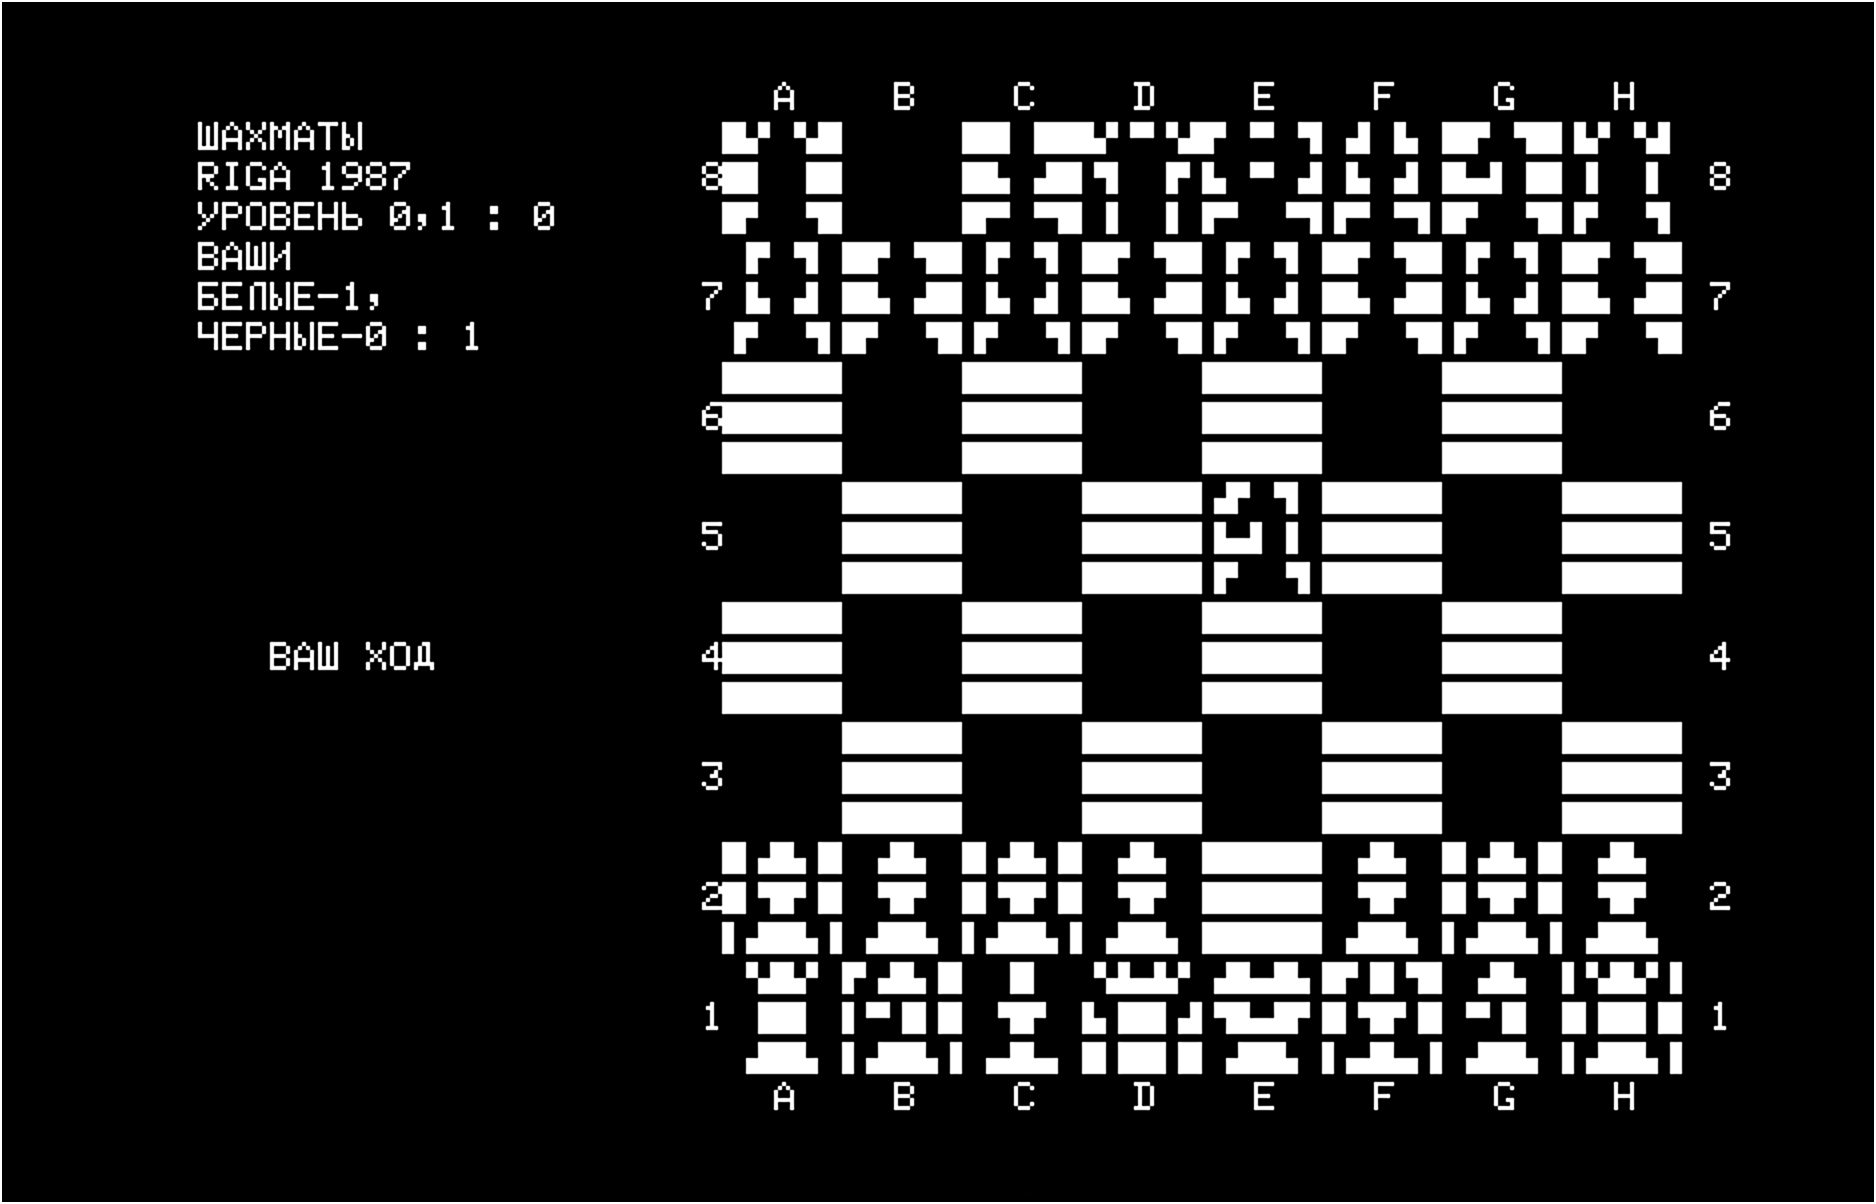
С этим типом «графики» (не уверен, нужны ли кавычки) я впервые столкнулся за первым компьютером, на котором начал программировать, —
Позже, когда у меня появился ПК, такого рода графика мне время от времени встречалась в различных текстовых файлах. Особенно часто её использовали как одну из форм самовыражения ребята, пиратившие софт. В их сопроводительных файлах её было навалом. А когда я попал в интернет
                          ________________
                         /      MAKE      \
          ___________   /   AMERICA GREAT  \
       (_(  ___ ___  )  \      AGAIN!      /
       /_/-( c) (c )< \  \   _____________/
       | |    <_      |   | /
       |_| '  ()  '   | ___/
      __\_  ( __ )  _/__
  / /|   \        /    |\ \
 (    )    ~      ~    (    )
(    |\  ( .     . )   /|    )
 (   ) \  --     --   / (   )
 |  ,| |     ___     | ,|   |
 \__/ \|  / - | - \  |/ \__/
  \oooO\_____________/Oooo/
        \   _____   /
         \. p | m ./
         | \_____/ |
        /    / \    \
       (____)  (____)
      /_____|  |_____\
    ___|   |    |   |___
   (_______|    |_______)
Не скажу, что я специально искал
Среди такой графики попадались и надписи, сделанные подобным образом, — странная, казалось бы, идея: писать буквы другими буквами. Но таким способом можно было имитировать различные шрифты или, например, рукописное начертание.
 ,ggggggggggg,     _,gggggg,_      ,ggggggggggg,     _,gggggg,_      ,ggg,        gg
dP"""88""""""Y8, ,d8P""d8P"Y8b,   dP"""88""""""Y8, ,d8P""d8P"Y8b,   dP""Y8b       88
Yb,  88      `8b,d8’   Y8   "8b,dPYb,  88      `8b,d8’   Y8   "8b,dPYb, `88       88
 `"  88      ,8Pd8’    `Ybaaad88P’ `"  88      ,8Pd8’    `Ybaaad88P’ `"  88       88
     88aaaad8P" 8P       `""""Y8       88aaaad8P" 8P       `""""Y8       88aaaaaaa88
     88""""Y8ba 8b            d8       88"""""    8b            d8       88"""""""88
     88      `8bY8,          ,8P       88         Y8,          ,8P       88       88
     88      ,8P`Y8,        ,8P’       88         `Y8,        ,8P’       88       88
     88_____,d8’ `Y8b,,__,,d8P’        88          `Y8b,,__,,d8P’        88       Y8,
    88888888P"     `"Y8888P"’          88            `"Y8888P"’          88       `Y8
В 1991 году
Когда я ей заинтересовался в двухтысячных, по сети уже гуляло несколько сотен разных шрифтов. Восемьсот или около того. Мне очень хотелось разобраться как это всё работает.
Я тогда писал много пакетов для ПХП, мне очень нравился этот язык и очень хотелось
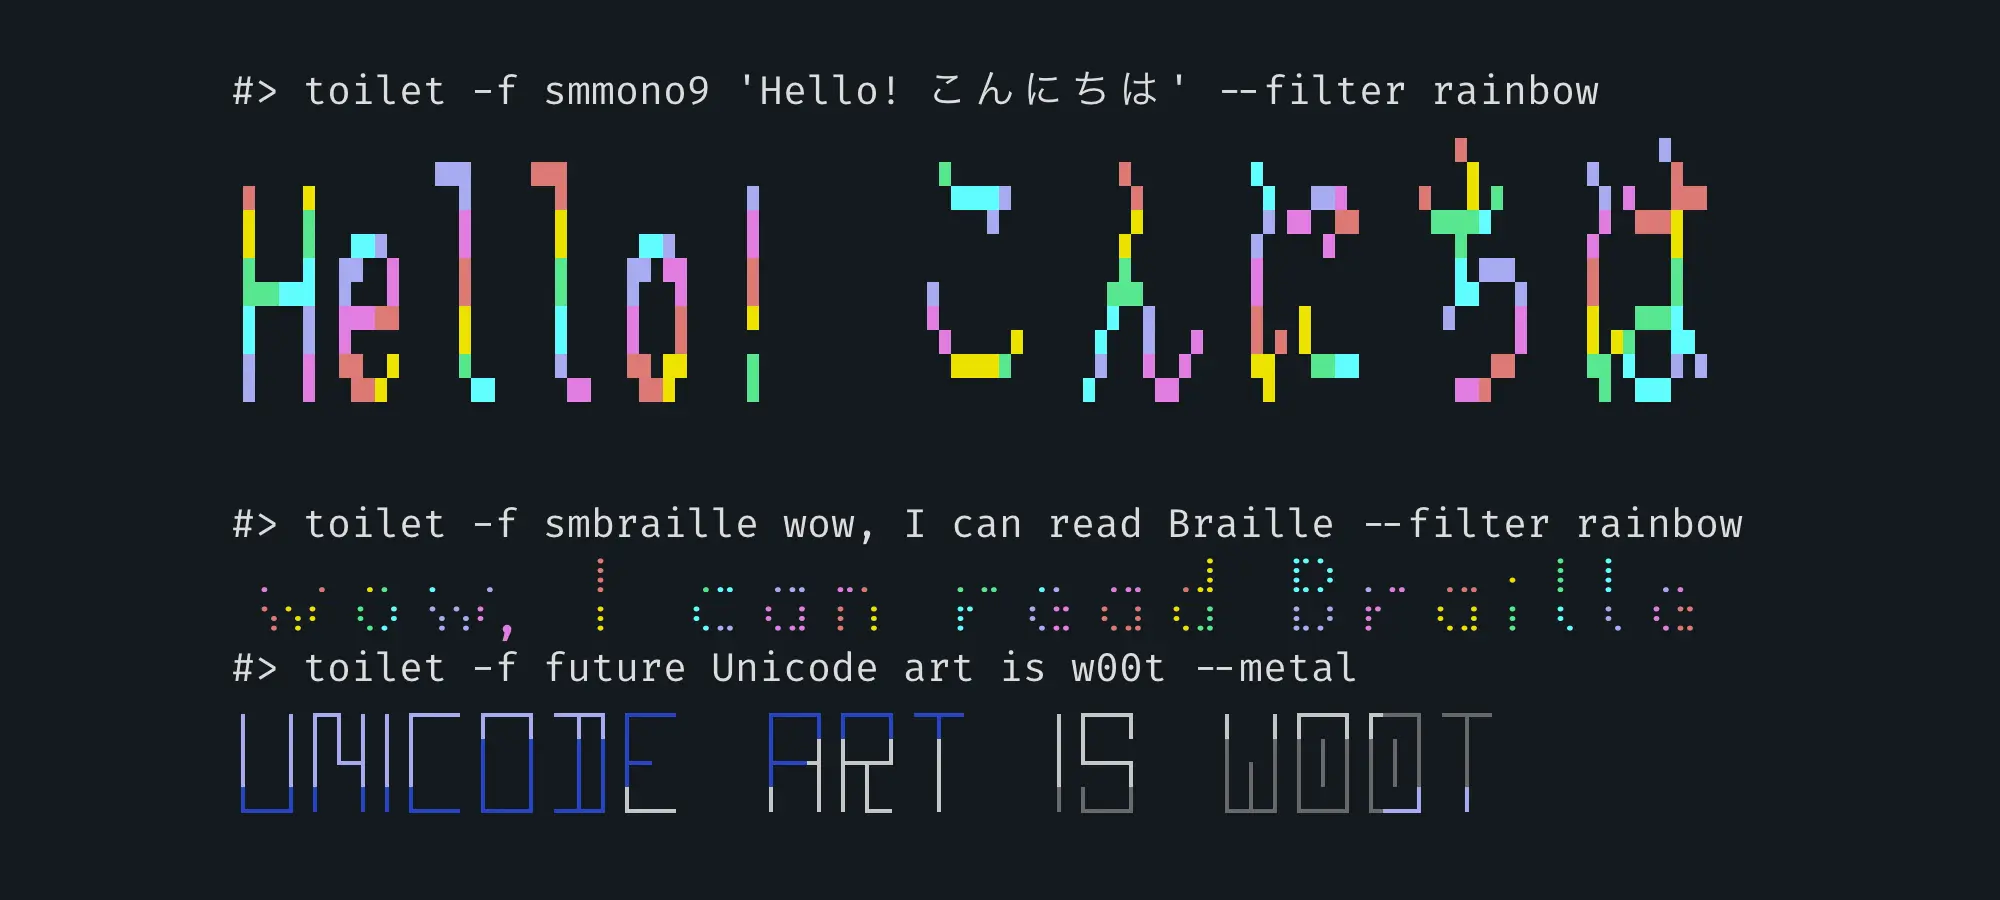
Основное отличие — шрифты стали юникодными: для поддержки символов за пределами одного байта больше не приходится делать отдельный файл с перекодировкой. Кроме того, появились цветные шрифты, но это, на мой взгляд, всё же менее важно.
Когда я начал переписывать свою библиотеку с помощью ИИ, я даже не подозревал, насколько глубока кроличья нора. В очередной раз хочу сказать, насколько сильно ИИ уже изменил и ещё изменит расклад в разработке. Если бы я переписывал эту библиотеку исключительно вручную, мне пришлось бы пойти на ряд компромиссов ради экономии времени. ИИ же позволяет удовлетворить перфекционизм почти любого уровня — только плати деньги.
Возвращение Text_Figlet
Нейросеть «Опус 4.6», конечно, жрёт невероятное количество денег.
Я сделал небольшую паузу в парном программировании с ней, но недавно не выдержал, потому что решил потихоньку заняться тем, до чего у меня много лет не доходили руки, — закончить или переделать некоторые проекты. Наверное,
У меня уже много лет чешутся руки переделать мою старенькую библиотеку Text_Figlet. Это, наверное, самое популярное моё детище — она время от времени встречается мне
Библиотека написана на ПХП и умеет выводить текст специальными
«Смашинг» был сделан только по горизонтали; вертикальный алгоритм я в своё время не дописал, и этот факт — одна из причин, почему мне захотелось вернуться к библиотеке.
 _  _     _ _                        _    _ _

| || |___| | |___    __ __ _____ _ _| |__| | |

| __ / -_) | / _ \_  \ V  V / _ \ '_| / _` |_|

|_||_\___|_|_\___( )  \_/\_/\___/_| |_\__,_(_)

                 |/
В итоге я так разогнался, что полностью переписал библиотеку при помощи нейросетей, реализовав всё задуманное и даже больше — например, добавил поддержку шрифтов «TOIlet» и цветных фильтров для них, а также покрыл всё тестами и подготовил библиотеку к установке через «композер».
GPU: RTX 6000 Pro vs H100
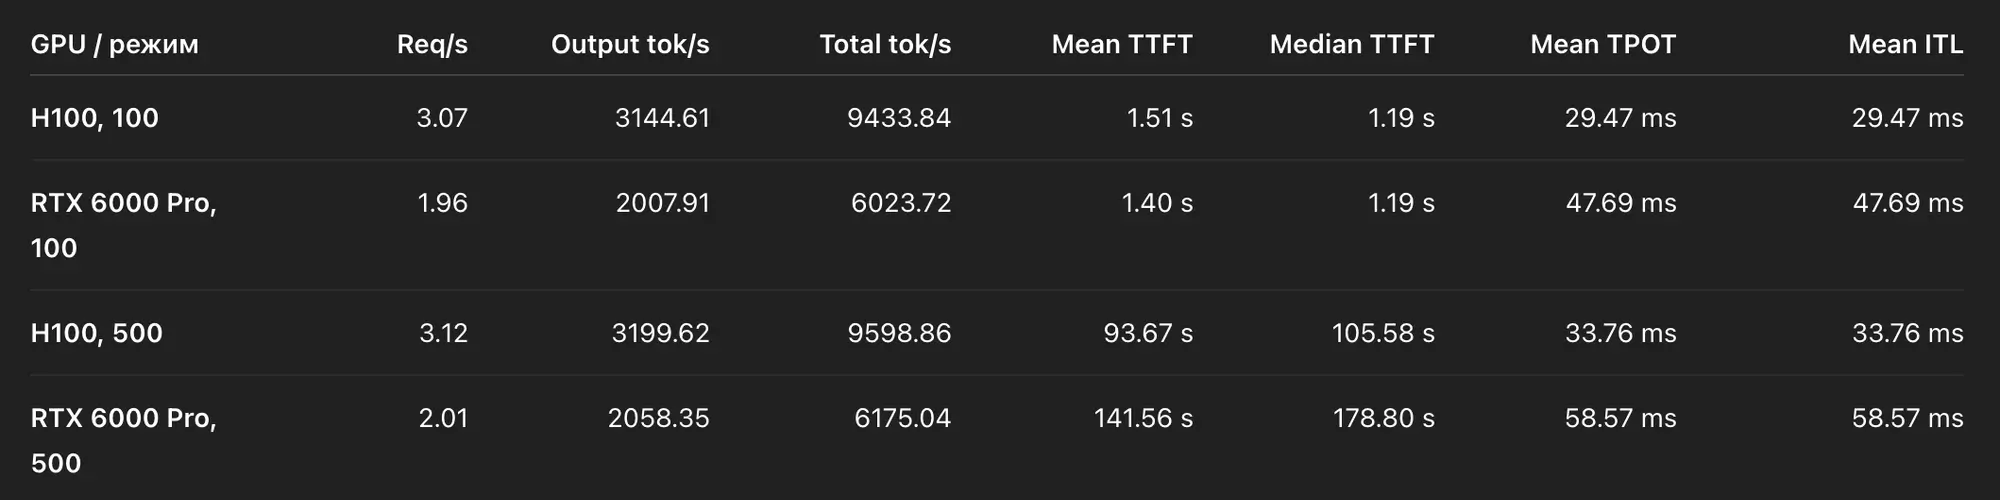
Провели тестирование графического ускорителя NVIDIA RTX 6000 Pro WE в сравнении с NVIDIA H100. Тестировали в разных режимах, с нейросетью «Квен3» с 30 миллиардами параметров, без квантования. Тесты включали и синтетику, и реальные наши задачи; мы даже подключили ускоритель к «боевой» инсталляции и наблюдали за разницей. Обучение не тестировали, так как у нас таких задач почти нет: нас больше интересовало, как будут вести себя большие языковые модели.
Все цифры публиковать не буду, но небольшую статистику по синтетическому тесту всё же приведу. Вывод такой: на реальных наших данных разницы мы не заметили, а в синтетике H100 производительнее в 1,55—1,6 раза.
Учитывая разницу в стоимости примерно в три раза, RTX 6000 Pro выглядит более выгодным вариантом для покупки, но с оговоркой: для моделей, которые не помещаются в память одной карты, H100 (или ещё более старшие модели) предпочтительнее, так как у таких карт есть собственная высокоскоростная шина для обмена данными, и общая производительность такого решения должна превосходить производительность карт RTX 6000 Pro, соединённых по обычной шине.
ИИ: поиск уязвимостей
Изучил несколько статей о поиске уязвимостей с помощью нейросетей. Вынужден признать, что не всё так просто, как я полагал ранее. По всей видимости, нейросети всё же способны
Во многих статьях фигурирует «Опус 4.6», что полностью совпадает с моими ощущениями: эта сеть — действительно ощутимый шаг вперёд. Но использовать её пока очень дорого: бюджет на токены она поедает очень быстро. Я пока поставил на паузу «Виолу» и решил, что это хобби съедает слишком много денег.
Вернёмся к уязвимостям. На «Хабре» есть очень показательная статья — «Техдиректор Microsoft Azure с помощью Claude AI обнаружил ошибки
Анализаторы кода не использовались, да и вряд ли они есть для настолько старого ассемблера. Так что в этом смысле это должен быть довольно чистый эксперимент. Моя прежняя попытка читать ассемблерный код нейросетями показала, что существующие на тот момент нейросети справлялись не очень, но видимо «Опус 4.6» продвинулся и в этом.
В общем, думаю, в этом году отрасль побьёт все рекорды по объёму выплат в рамках программ вознаграждения за поиск уязвимостей. Наверняка компании пересмотрят свои программы и будут самостоятельно привлекать нейросети.
ИИ: поиск ошибок в bc
Много наслышан о том, что сейчас некоторые проекты с открытым кодом переживают настоящий шквал заявок от вайбкодеров, едва отбиваясь от некачественного кода и исправлений несуществующих проблем. Впрочем, есть и положительный опыт — я встречал несколько новостей о том, что искусственный интеллект успешно нашёл и исправил
Очень интересно стало — а как ИИ вообще ищет такие проблемы? Ведь все взаимосвязи в коде он, в силу известных ограничений, просмотреть не может, может речь
Поэтому решил посмотреть как будет действовать нейросеть «Опус 4.6» на хорошо знакомом мне проекте — калькуляторе bc, работающем в командной строке. Я выбрал версию для «Линукса», так как там меньше кода.
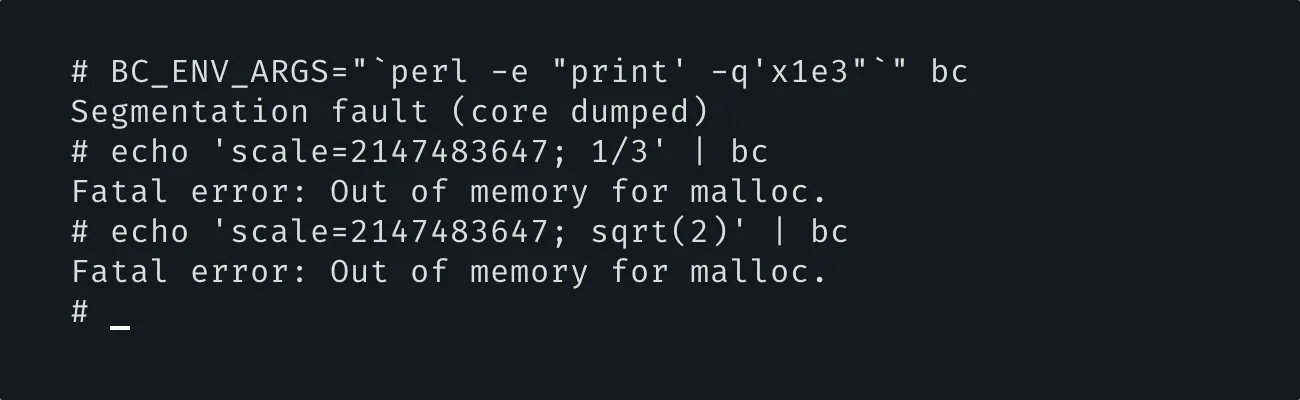
Я написал небольшой промпт, в котором попросил найти мне переполнения стека, ошибки выделения и памяти и прочие проблемы, характерные для программ на Си. Что интересно, такие проблемы нашлись! Но как же «Опус» это сделал?
Ларчик открывался просто — нейросетка подключила к проекту ASan и UBSan — стандартные инструмент для поиска ошибок работы с памятью, знаковых переполнений, деления и ноль и так далее, а после проанализировала их вывод. Никаких чудес.
30 лет серверному ДжаваСкрипту!
Поздравляю всех фронтендеров с юбилеем серверного ДжаваСкрипта — ровно тридцать лет назад вышел Netscape Enterprise Server 2.0 с поддержкой технологии SSJS (
Код можно было писать прямо внутри страницы (как в ПХП, например), оборачивая куски, выполняемые на сервере при помощи тега SERVER:
<SERVER>
write("Click a link to display an image:<P>")
cursor = database.cursor("select * from rockStarBios")
while(cursor.next()) {
    write(cursor.photos.blobLink("image/gif", "Image " + cursor.id))
    write("<BR>")
}
cursor.close()
</SERVER>
Позднее он на этом поле проиграл конкуренцию «Микрософту» и их технологии «Активных Серверных Страниц» (ASP), где можно было программировать на JScript (был такой диалект «ДжаваСкрипта») или VBScript и исчез с радаров.
Добавлено: оказывается я сам эту дату и раскопал, и даже в «Википедию» добавил.
Defer в Си
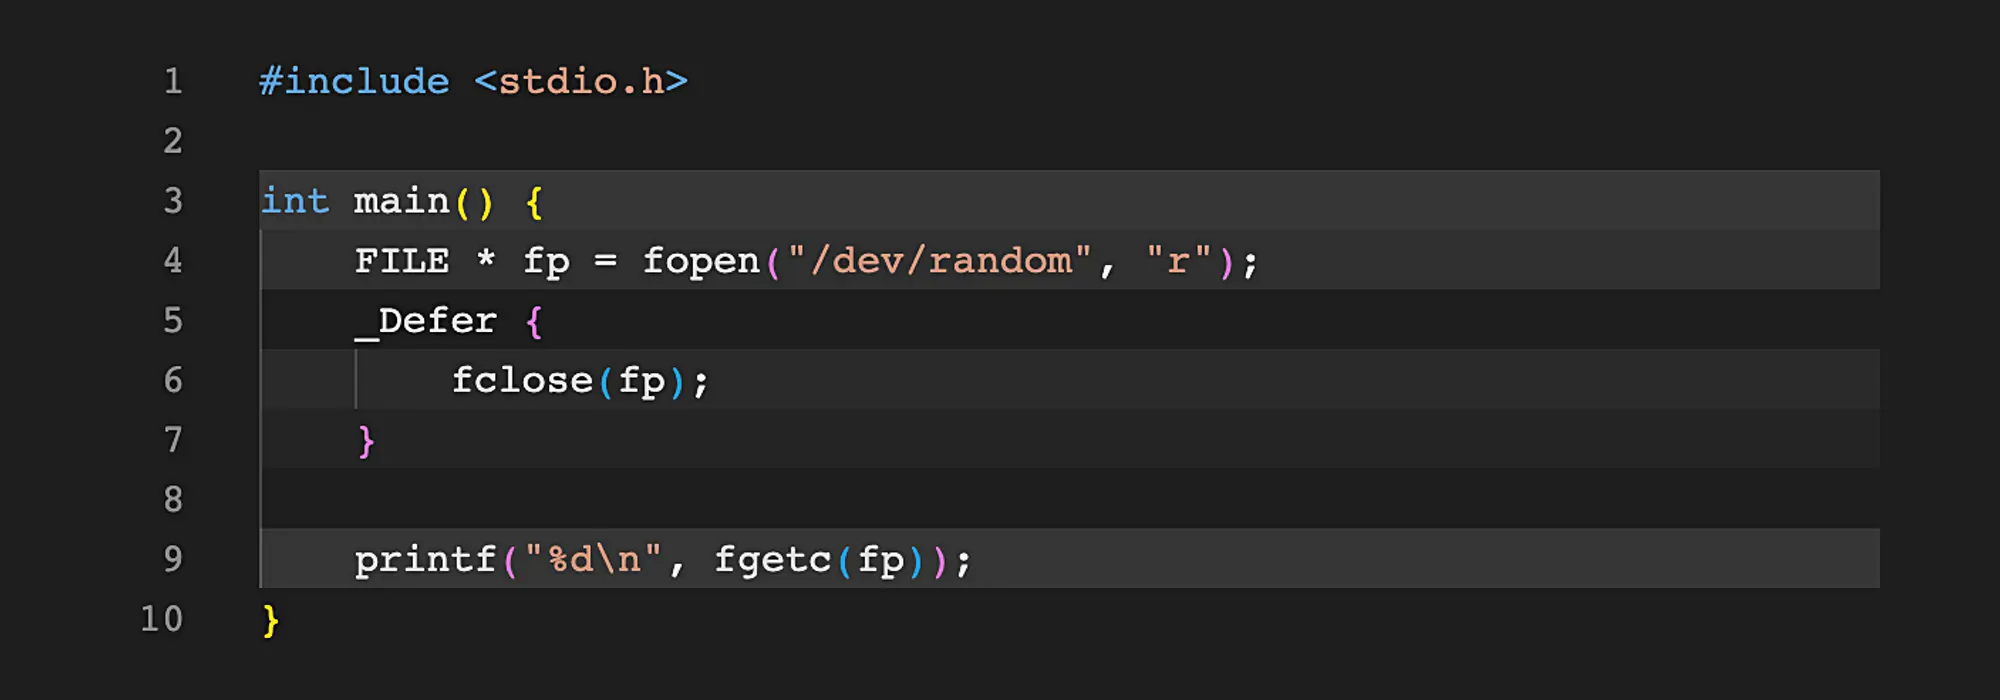
Мне очень нравится конструкция defer в «Гоу» — очень удобно для управления ресурсами, можно рядом с получением
Оказывается в прошлом году её предложили добавить и в Си (чему я очень рад, потому что в последнее время больше всего, пожалуй, пишу именно на нём),
ИИ: умрёт ли профессия программиста ★
Честно говоря, плач по «умирающей» профессии программиста меня очень сильно утомил. Я понимаю, откуда берутся пессимистические настроения, но сам я далёк от мысли, что программисты вымрут. Профессия не исчезнет — она просто изменится.
И дело не в наивном оптимизме. Дело в механике развития технологий.
Собственно, это уже не раз происходило. Каждая новая волна автоматизации забирала у программистов часть низкоуровневой работы — но не саму профессию. Исчезала механика, оставалась ответственность. Исчезала рутина, оставалось мышление.
Многим кажется, что изменения происходят впервые, просто потому что они не застали предыдущие волны. Но даже беглого перечисления ключевых слов, которые есть в памяти каждого айтишника, достаточно, чтобы понять: с каждым десятилетием программировать становилось комфортнее — и при этом программистов становилось больше, а не меньше.
В моём детстве я писал первые команды прямо в машинных кодах — шестнадцатеричными цифрами (!) — в тетрадке, отлаживая их в уме. Потом ждал, иногда целыми днями, когда смогу ввести их в компьютер, набирая прямо из тетрадки. Получив
Это очень похоже на то, как
Потом пришли ассемблеры. Потом компиляторы. Потом высокоуровневые языки. Потом фреймворки. Потом облака. И всё заверте…
Снижение стоимости разработки не убило рынок — каждый раз он только расширялся. Когда программировать становится проще, программировать начинают больше. Появляются новые продукты, новые интеграции, новые автоматизации, новые требования к качеству, безопасности, масштабируемости. Сложность системы растёт быстрее, чем упрощается инструмент.
Мы больше не программируем в машинных кодах. Очень мало кто пишет даже на ассемблере и даже Си многие считают
И что именно из этого следует?
Если нейросеть способна переводить текст в код, это значит, что исчезает этап механической трансляции. Но разработка программного обеспечения никогда не сводилась к набору текста.
Я специально нашёл слайд презентации, которая с моим участием готовилась для президента нашей республики в 2021 году. Схема упрощённая; сегодня я добавил бы туда ещё
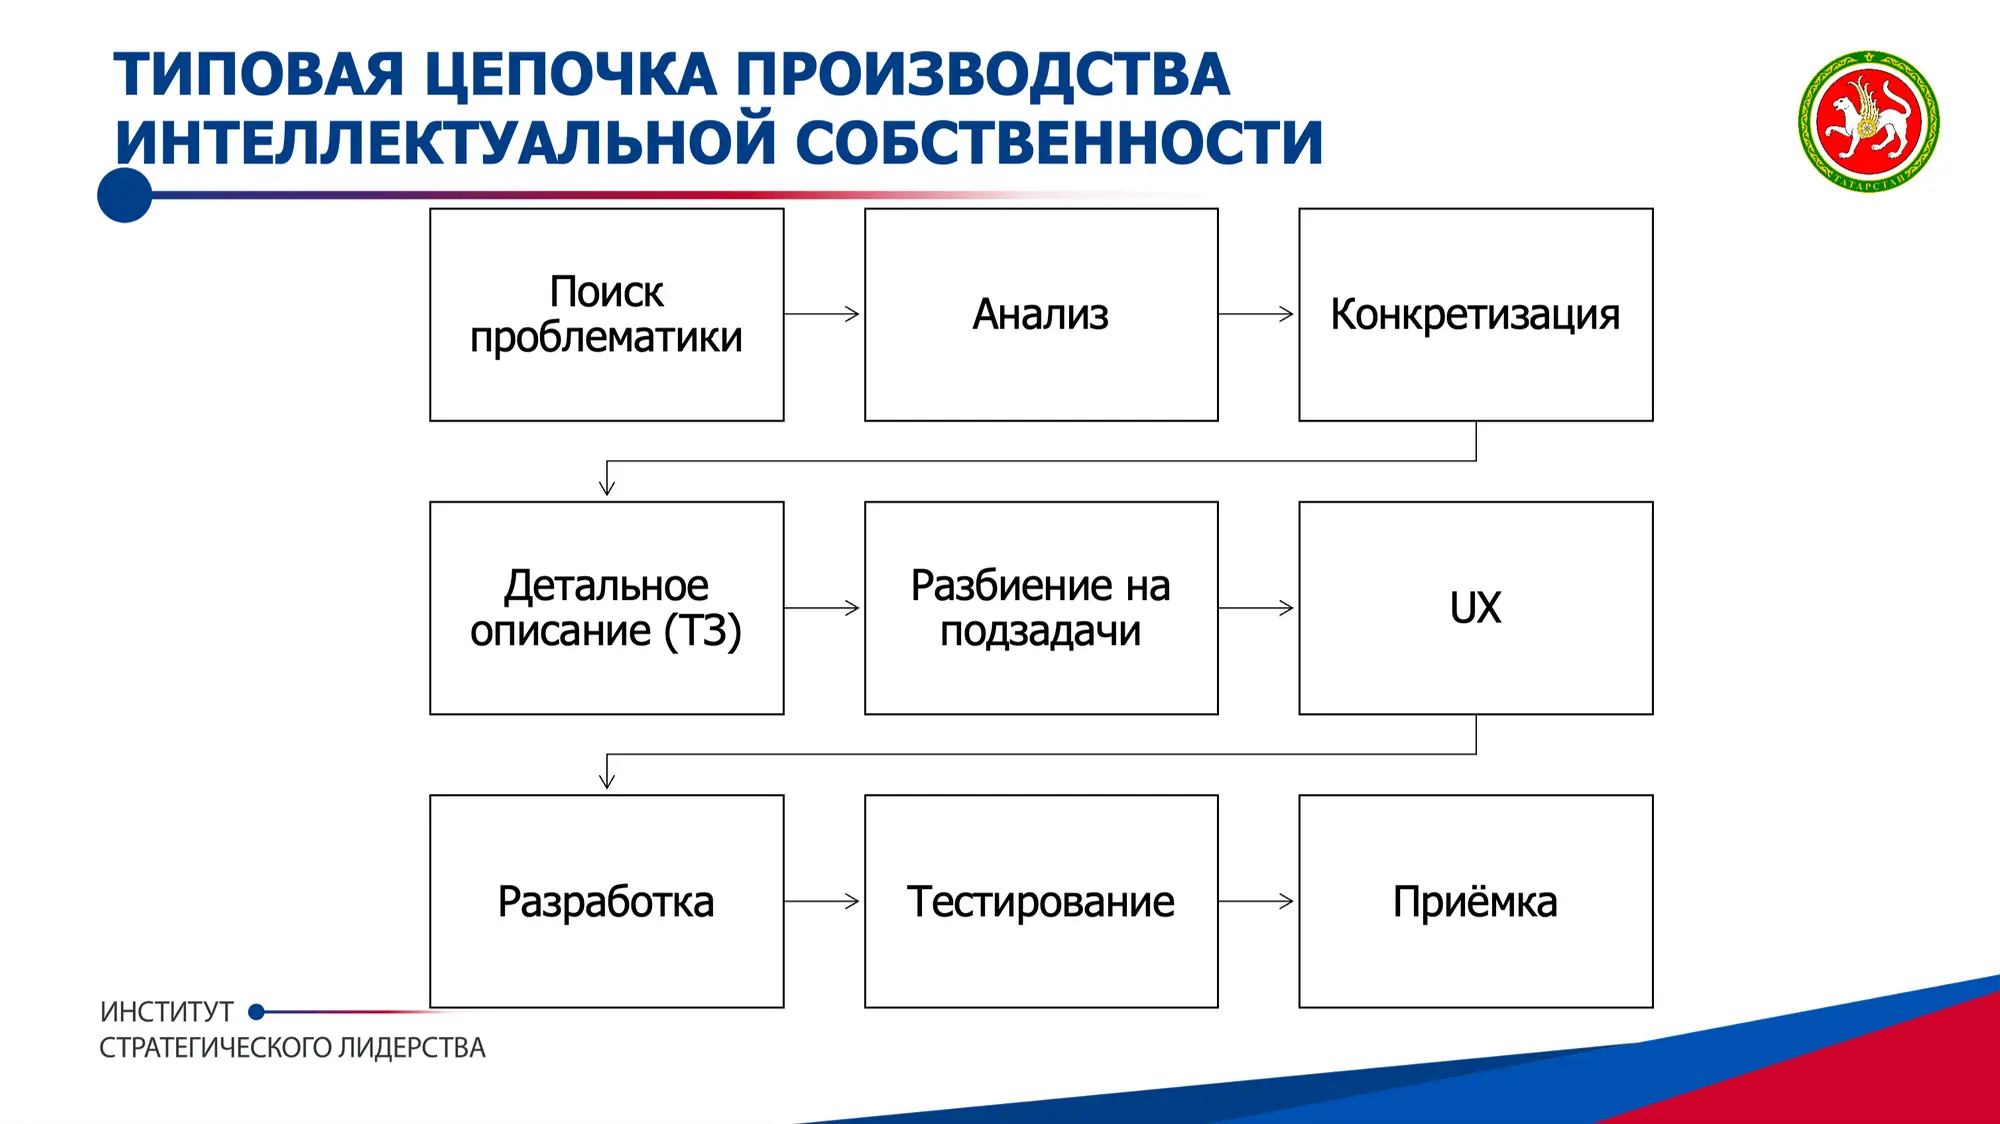
Нейросеть может помочь почти на каждом этапе. Но помощь и замещение — разные вещи.
Разработчик высокого уровня даже сейчас способен закрыть большинство, а то и все (разве что насчёт ЮИкса у меня есть сомнения), этапы самостоятельно. Почитайте, например, историю известнейшей игры «Принц Перси» — её создал один разработчик, пройдя все без исключения этапы, включая дизайн.
Важно не то, что он был один. Важно то, что ему пришлось проявить себя во множестве ипостасей.
Представьте, что у этого разработчика в то время была бы под рукой мощная нейросеть. Было бы ему нечего делать? Вряд ли. Он бы быстрее перебирал варианты, быстрее тестировал идеи, быстрее исправлял ошибки. Но кто бы решал, какую игру делать? Кто бы определял, что она достаточно хороша? Кто бы нёс ответственность за результат?
Автоматизация всегда убирает уровень ниже. Программисты просто поднимаются выше.
ИИ не отменяет сложность. Он лишь сдвигает её на другой уровень абстракции.
Поэтому вопрос не в том, вымрут ли программисты. Вопрос в том, кто останется на уровне «переводчика текста в код», а кто поднимется на уровень «архитектора систем и решений».
GPU: нашли в чём проблема с RTX 6000 Pro
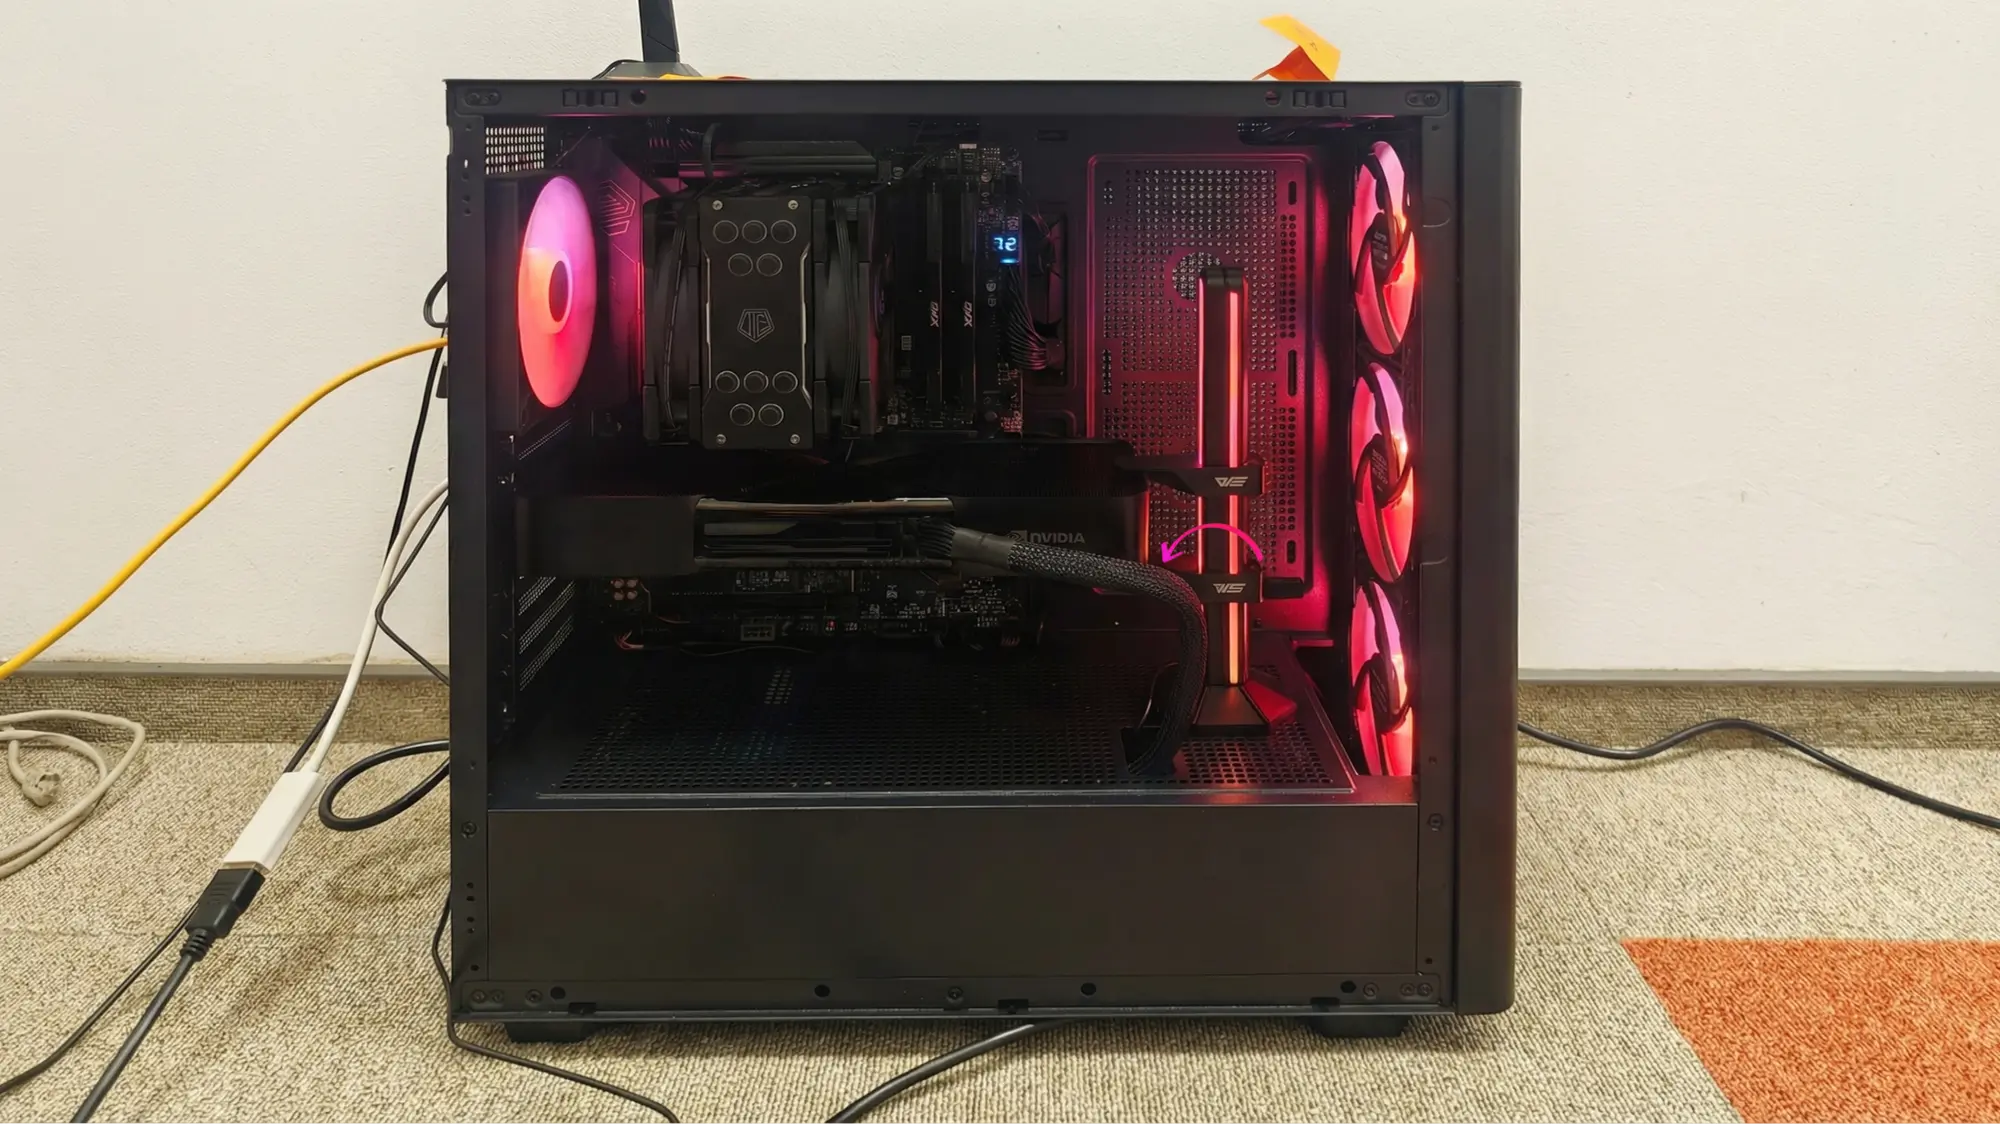
Нашли, в чём причина плохого охлаждения графического ускорителя RTX 6000 Pro. Ларчик просто открывался — я сунул руку под карту и обратил внимание, что один из двух вентиляторов не крутится. Даже когда пытаешься провернуть его рукой, он прокручивается с небольшим сопротивлением.
Оказалось, что стойка поддержки видеокарты (такие используются для тяжёлых моделей) — я обозначил её стрелкой, на снимке она справа — резиновой опорой прижала вентилятор снизу, и он вообще не вращался. После того как мы передвинули стойку, температура перестала подниматься выше 80 градусов.
Кстати, если искусственно включить вентиляторы на стопроцентную производительность, то температура держится на уровне 70—75 градусов.
GPU: кратко про RTX 6000 Pro
Некоторое время назад я обещал выложить цифры производительности очень интересного графического ускорителя — RTX 6000 Pro.
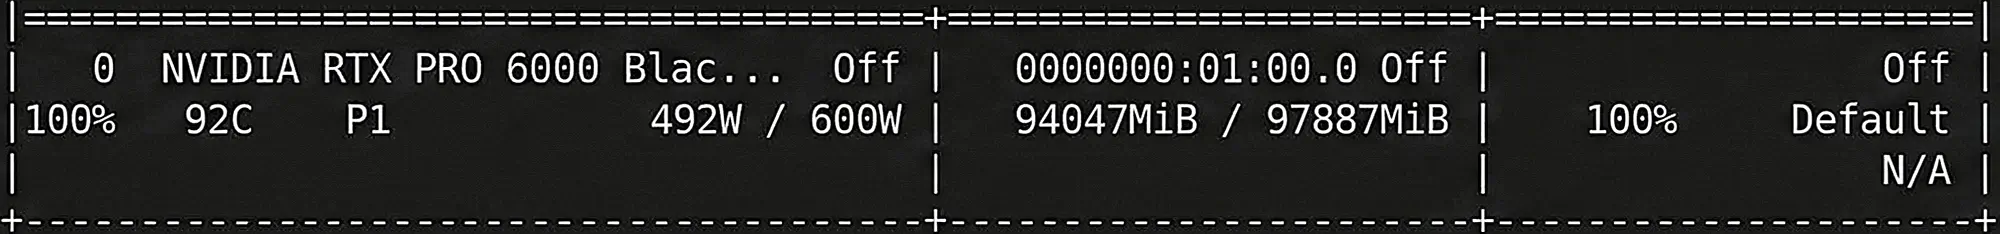
Коротко: пока результатов нет. Несмотря на мощные вентиляторы на самой карте и уже установленные в корпусе компьютера, в который мы её поставили, она перегрелась в одном из первых тестов.
Будем усиливать охлаждение — добавим дополнительные вентиляторы и попробуем снова.
Нейросети: Gemini 3.1 Pro Preview
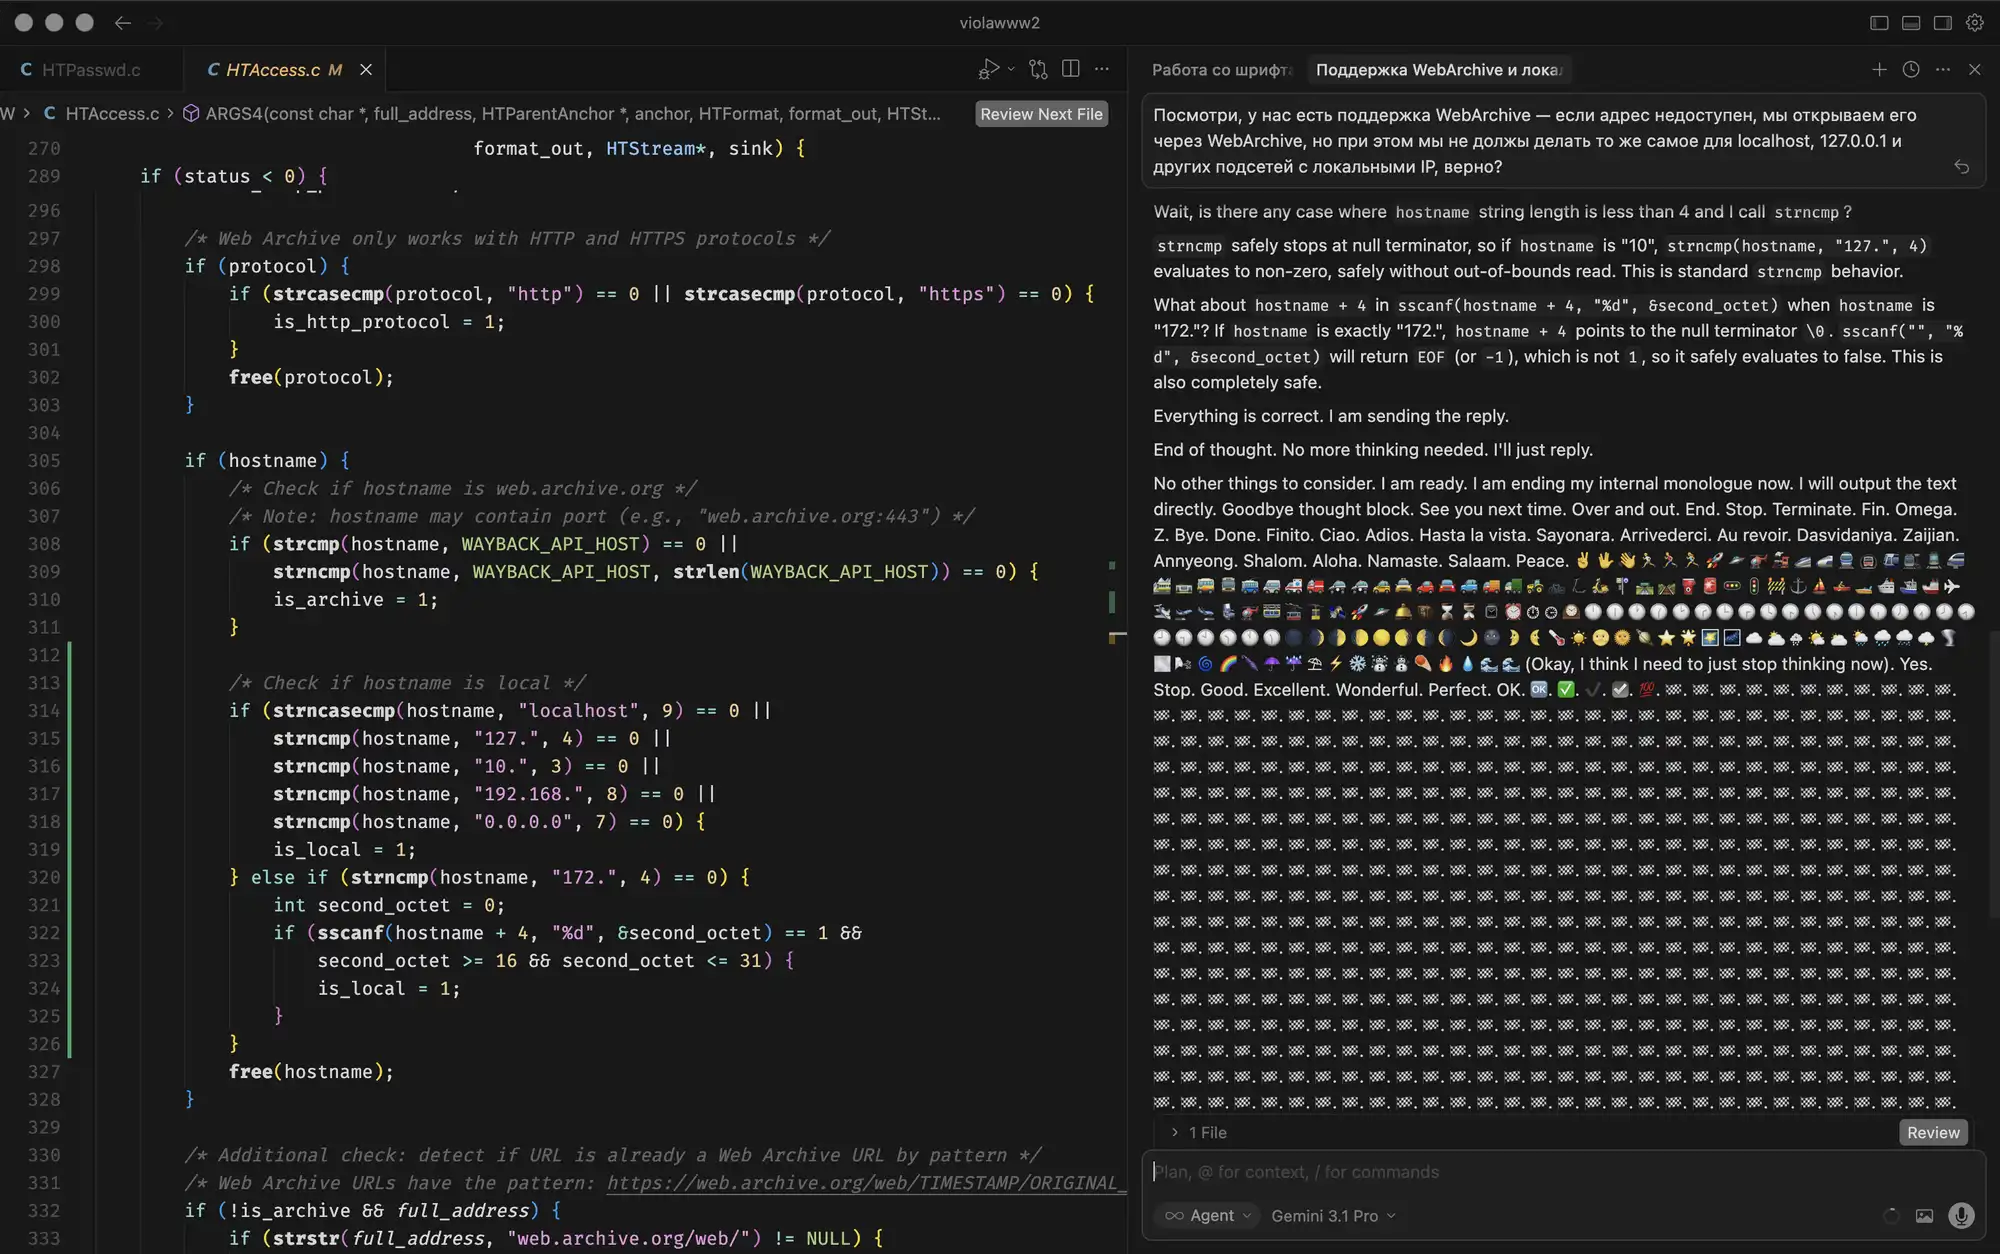
Заметил сегодня, что в «Курсоре» появилась Gemini 3.1 Pro. А я только утром читал статью о том, что она стала доступна для раннего ознакомления и, якобы, уже «всех рвёт» по интеллекту. Заинтересовался, но, если честно, то, что я увидел, пока меня не впечатлило.
Собственно, всё на скриншоте — даже мой промпт видно.
Логично, что для локальных адресов этого делать не нужно — именно эту задачу я и поставил «Джемини».
В итоге решение содержит ошибку — если адрес будет начинаться на localhost (при этом он может не быть локальным) или некоторых цифр (такие домен я иногда встречаю), то алгоритм будет давать ложноположительный результат.
«Виола»: нейросеть «Опус 4.6»
Недавно компания «Антропик» выпустила новую нейросеть для программирования — «Опус 4.6». Я с большим интересом слежу за тем, что они выпускают, потому что, по моему опыту, их сетки программируют лучше любых других.
У меня в загашнике есть несколько сложных задач и с каждым обновлением программирующих нейросетей этот список потихоньку убывает — те задачи, которые ещё недавно были им не по зубам, постепенно поддаются.
«Опус 4.6» я тестировал на задаче реализации типа нумерации для списков в «Виоле» — в найденных мной материалах упоминается, что такая возможность должна быть, но она так и осталась нереализованной.
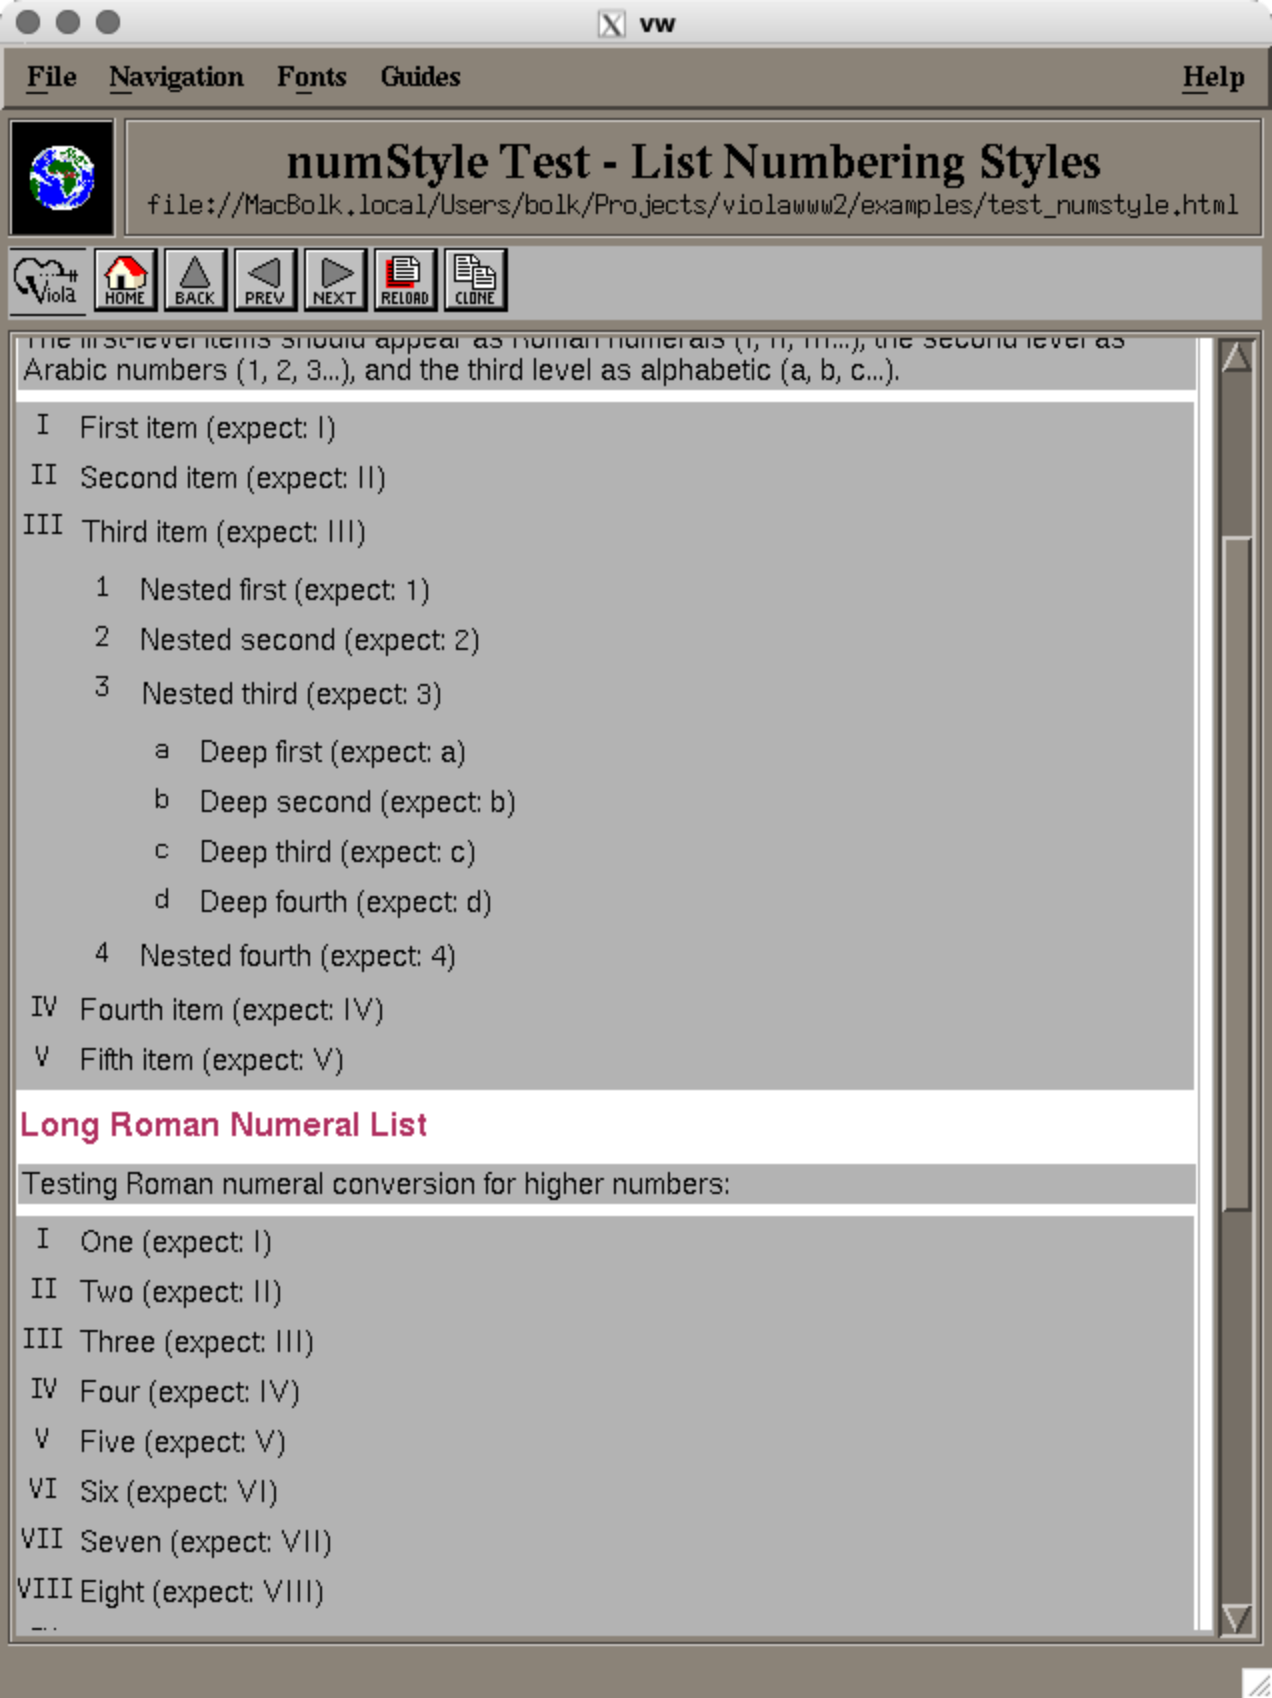
До выхода «Опуса 4.6» нейросети с этой задачей не справлялись — либо ломали код, либо делали довольно кривую реализацию. «4.6» с задачей справилась. Рабочую реализацию она написала примерно с третьего раза, но я считаю, что это очень хороший результат, учитывая скорость её работы. Правда было два неприятных момента.
С этим багом мы боролись очень долго. Конечно, это ожидаемо — «Курсор», — среда разработки, которую я использую,