ИИ: распознавание рукописного текста

Я как-то, сильно увлёкшись программирующими нейросетками, не слишком приглядывался к другим направлениям, или, как сейчас принято говорить, «модальностям». Одно время было интересно, как и всем, наблюдать, как сети генерируют картинки, но сейчас я к этому отношусь очень утилитарно и использую их в основном для обработки фотографий. А сгенерированные картинки просто удручают своей стилистической однообразностью.

Музыка и песни, генерируемые нейросетями, привлекали своей необычностью лет десять назад, но сейчас уже как-то не интересны. Видео меня тоже как-то не поражают, видимо, потому что 95-й процентиль всего, что попадается на глаза, — трижды переваренный кал.

В общем, я при помощи нейросетей много работаю с текстами разной природы, а к остальному в основном глух.

Поэтому я как-то пропустил, что небольшая по нынешним временам сетка — «Квен 3.5» с 35 миллиардами параметров, квантованных до FP8, — оказывается, прекрасно распознаёт русский рукописный текст. Я просто не изучал, на что способны современные мультимодальные нейросети!

Я-то думал, что весь нейросеточный мир, помешанный на английском и говорящий в основном на китайском, с рукописным русским научится справляться ещё не скоро.

В общем, я глазам не поверил, когда мы попробовали вышеупомянутым «Квеном» распознать текст на фотографии: распозналось всё идеально, причём сеть ещё и ошибки поправила (правда, не уверен, что это хорошо). Понимаю, это не самый непонятный почерк, но этот листок — наш первый эксперимент.

Потом мы ещё много экспериментировали, но сказать, что я читаю рукописный текст значительно лучше нейросети, значило бы соврать. Мне иногда помогает более широкий контекст: например, я знаю татарские имена, а «Квену» они плохо знакомы, и он может их перевирать, если они написаны не очень разборчиво.
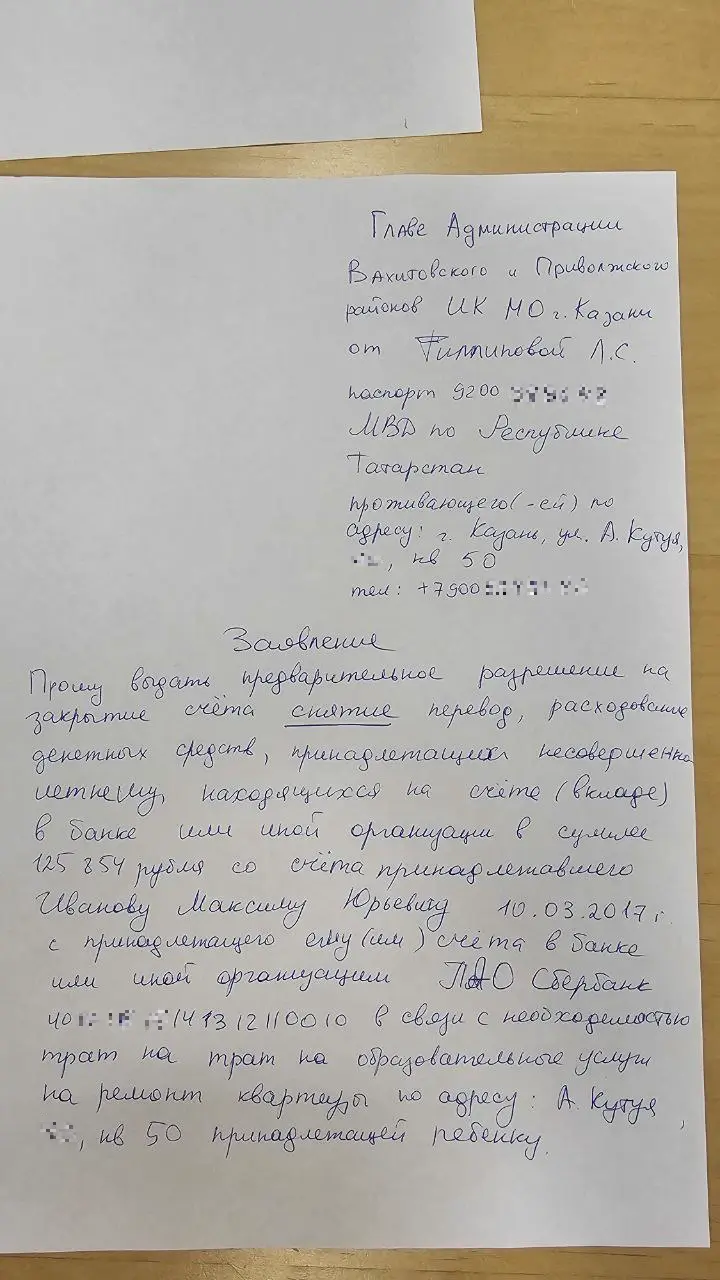
В общем-то удивительно, что нейросеть, которую можно запустить даже на некоторых современных ноутбуках, уверенно читает даже слово «шиншилла», записанное рукописным письмом.

Заявление от Филипповой Л.С. о снятии 125 854 руб. со счёта несовершеннолетнего Иванова М.Ю. на ремонт квартиры.
Данные не реальные, этот текст написала от балды одна из наших сотрудниц, но я всё равно на всякий случая закрасил некоторые данные

Добавлено позднее: уже позже, ближе к ночи я решил попробовать развернуть эту модель, квантованную до четырёх бит на своём ноутбуке, по памяти она как раз должна была влезть, — чтобы попробовать как она справится. Справилась отлично, но мне не удалось выключить режим размышлений, не нашёл такого параметра в LM Studio, где я её запускал, а с ним она работает гораздо медленнее.

Один из читателей в моём телеграмном канале написал, что у него с текстом справилась сеть «Гемма4» на смартфоне.
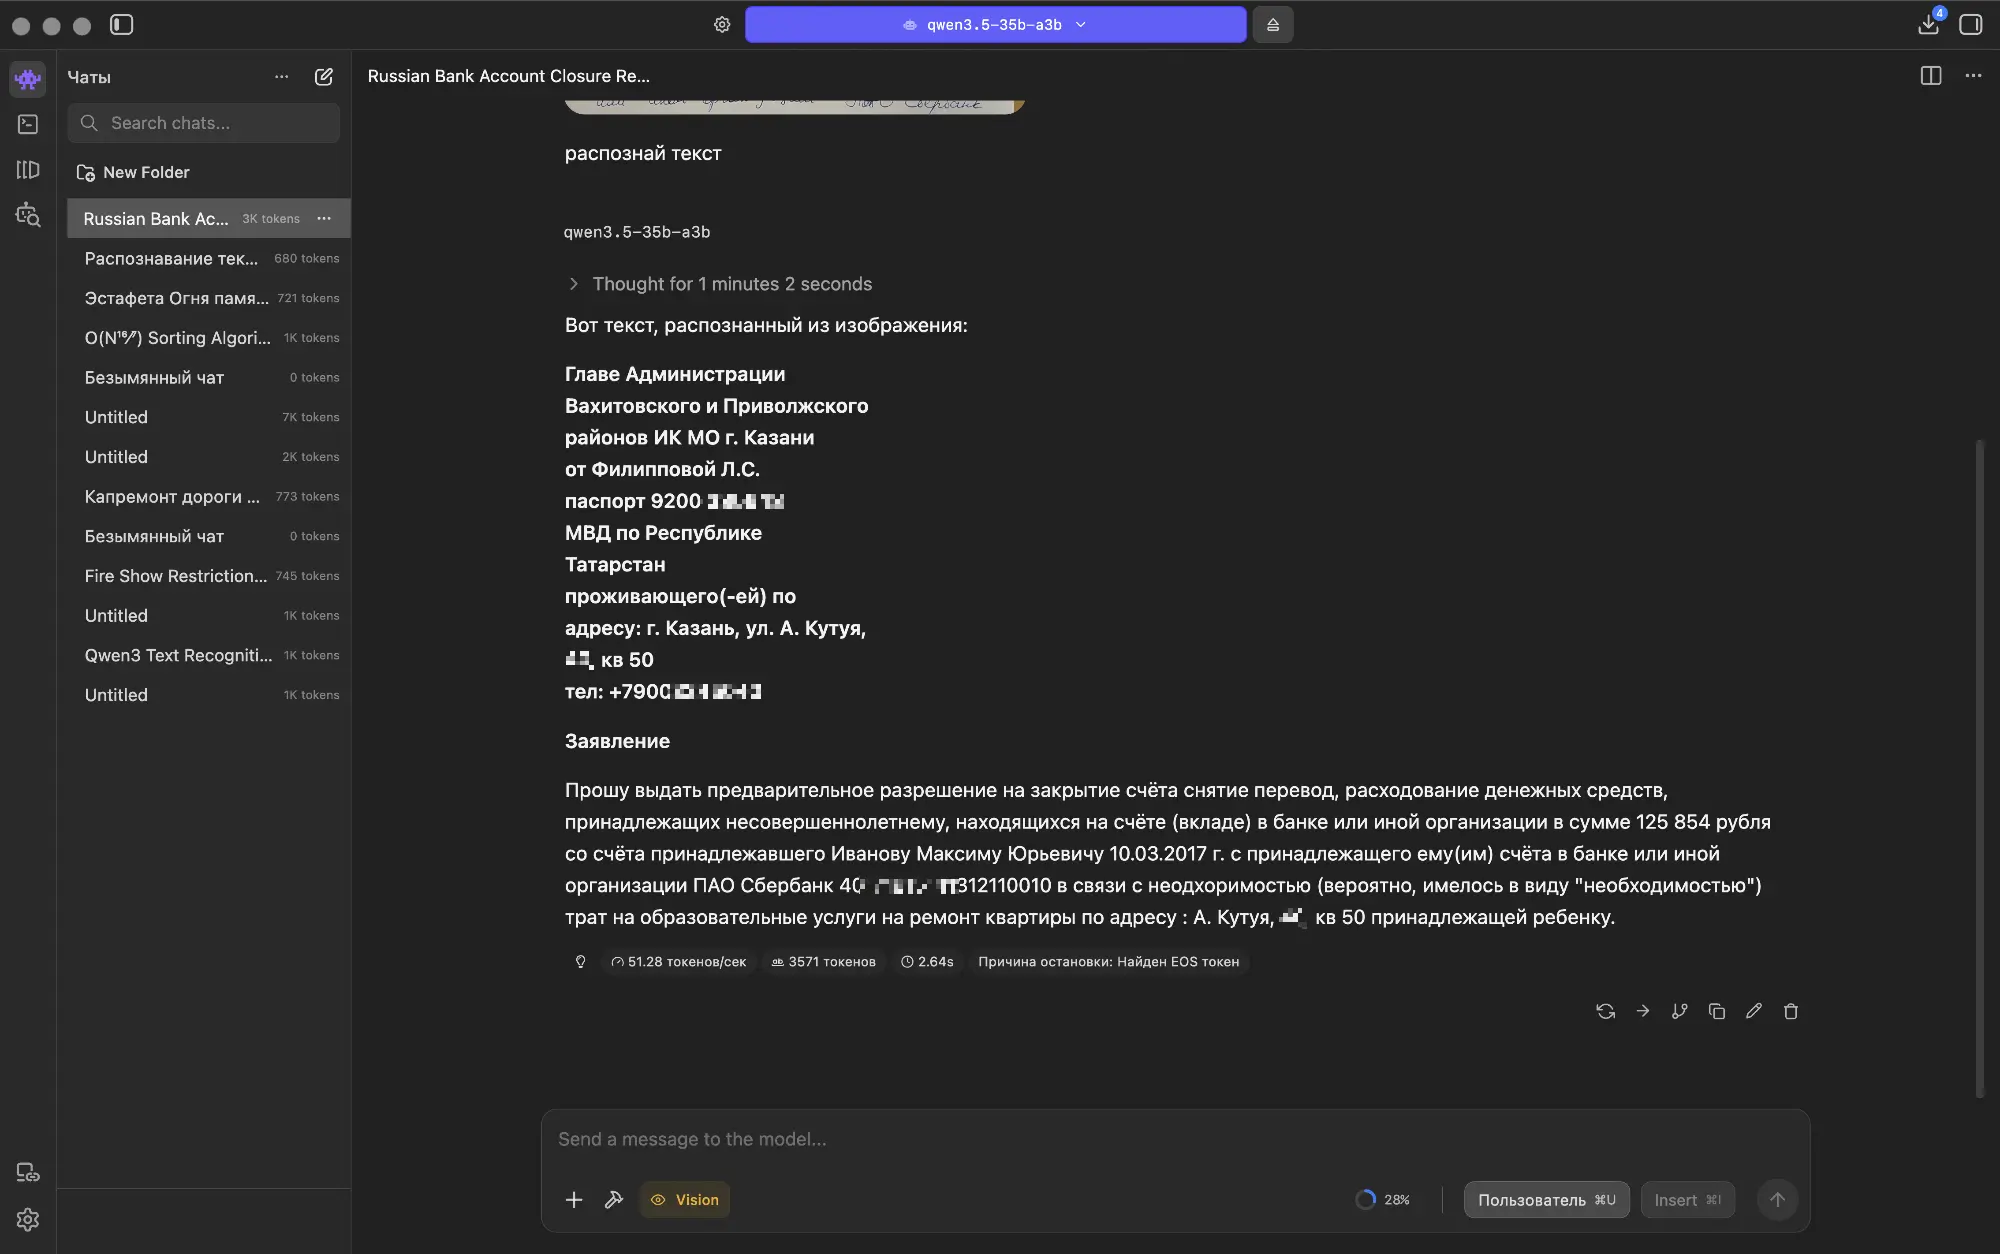
Скриншот чата с ИИ-моделью qwen3.5-35b-a3b: распознан текст заявления о закрытии счёта несовершеннолетнего в Сбербанке Казани, адрес — ул. А. Кутуя, кв. 50, сумма 125 854 руб.

Комментарии 9

Leonid № 2
О да, это ещё очень хороший текст . Сейчас покажу кусок немецкого текста, который чатгпт распознал
ivs № 8
сорян, почему-то двойной минус отформатироавался, как зачёркивание, увы.
попробую ещё раз:
lms chat \-\-model qwen3.5-9b \-\-config '{"enable_thinking": false}'
Евгений Степанищев автор № 9
Да мне, собственно, на один раз попробовать.

Я не буду на ноуте гонять эту сетку.