программирование
Утилита «s-tools»
Вчера перед сном вспоминал, что ещё я такого программировал в детстве, о чём можно упомянуть, кроме программы «Паррот», о которой я рассказывал около месяца назад. Вспомнил про утилиту s-tools, которую мы писали вдвоём с братишкой на ассемблере x86 под ДОС.
Название придумал я. Расшифровывалось оно как «Stepanischevs’ tools», а сокращение намеренно было сделано похожим на «stools» — «табуретки», поэтому я нередко так эту утилиту и называл.
Это был набор утилит в одном файле и самый объёмный код на ассемблере, который мы
Утилиты вызывались, если я ничего не путаю, при помощи номерного ключа, после которого шли параметры самой утилиты. К каждой из них прилагалось описание на русском языке. Часть программ была «резидентами» (TSR), и некоторые из них умели загружаться в HMA.
В ДОСе были специальные вызовы, при помощи которых можно было выделить себе в HMA кусочек памяти. Но поскольку это был один сегмент, программам приходилось модифицировать себя, чтобы поменять у себя внутри адреса ячеек памяти и использовать только ближние вызовы (jmp near или call near).
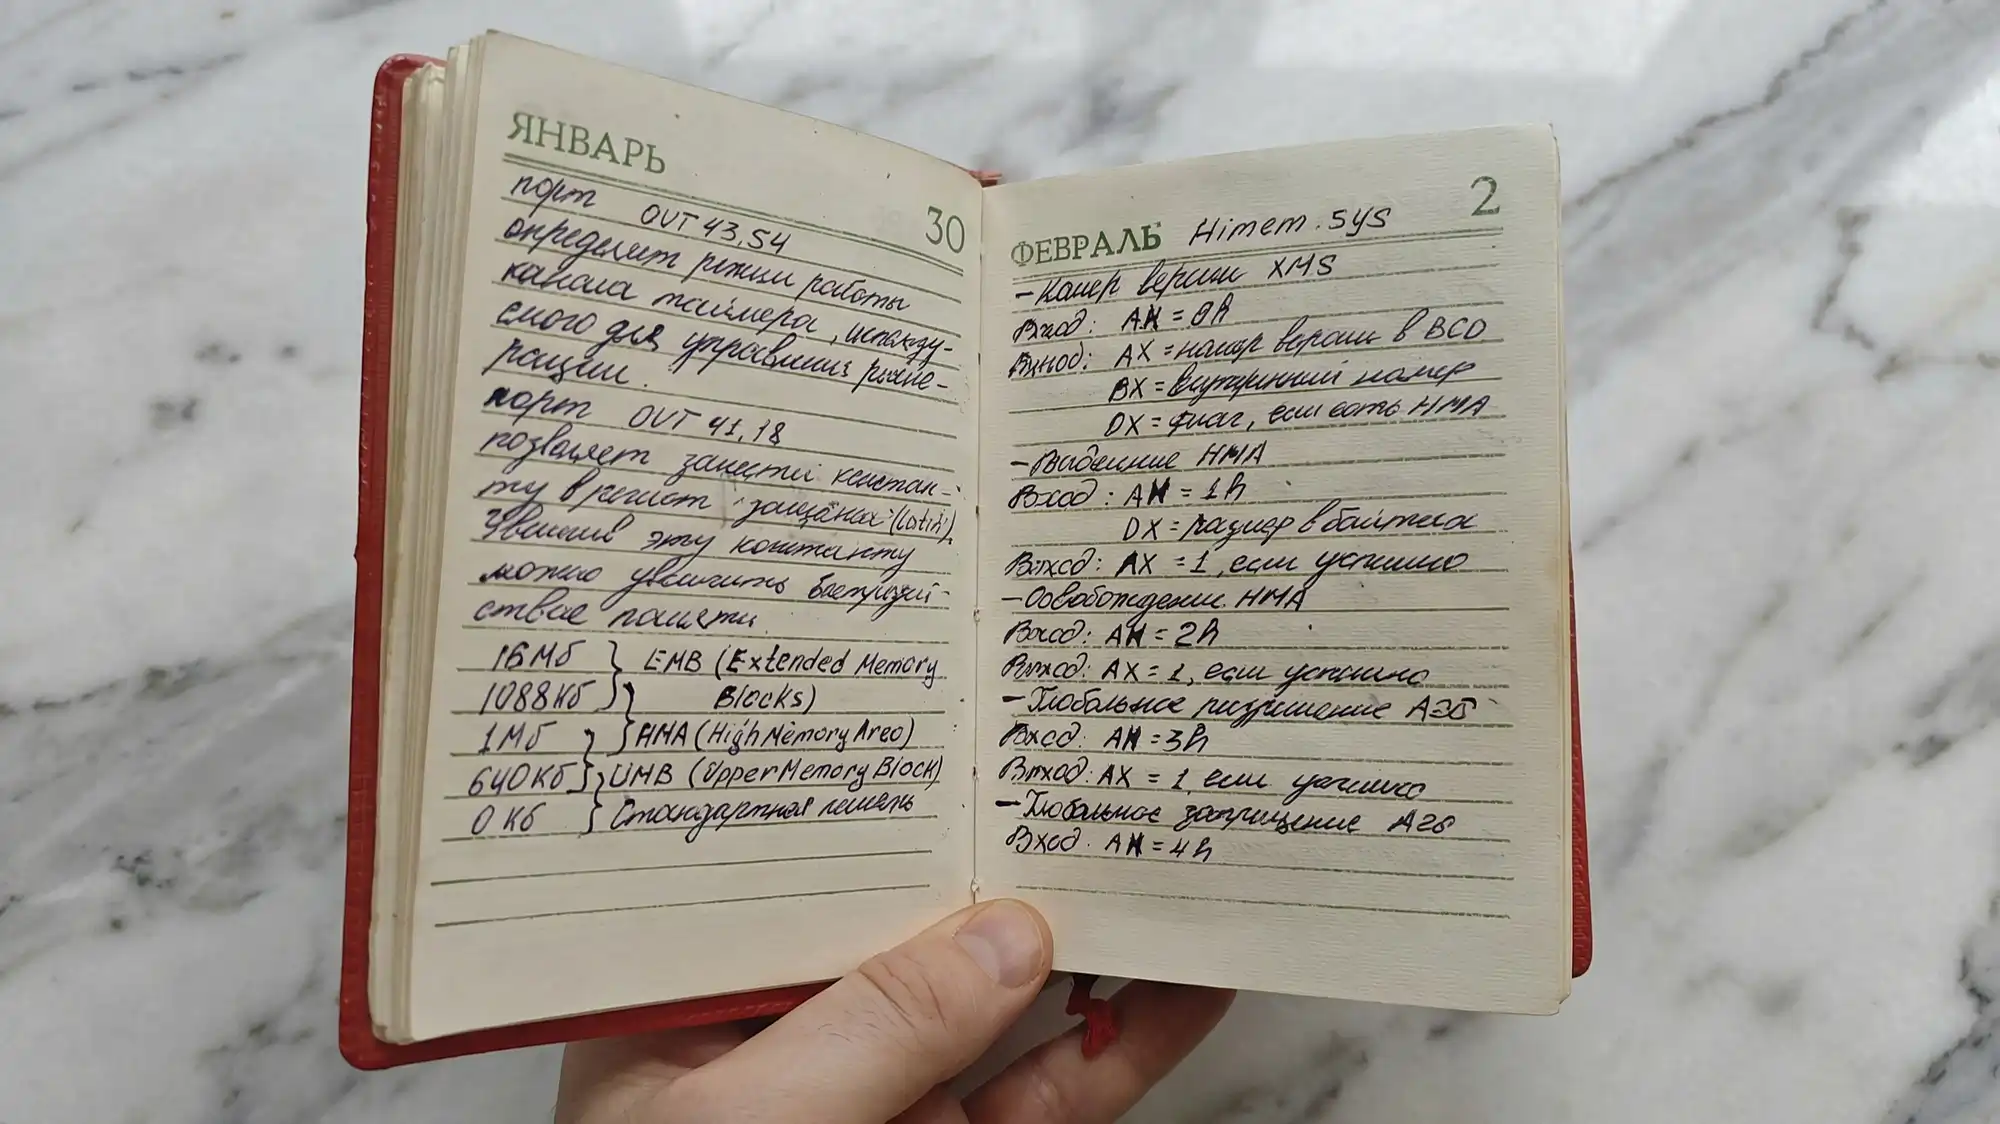
Я попытался вспомнить что именно умели «табуретки», но вспомнил только малую часть, разумеется. Утилиты в моём списке идут не по порядку следования, я его просто не помню.
Первое, что я вспомнил — в отдельном файле s-tools.ovl лежал шрифт, который мы вынули
Вторая утилита умела поднимать тайминги памяти на PC XT, идея была подсмотрена
Третья утилита решала проблему буфера клавиатуры. Компьютеры в те времена работали так медленно, что не успевали обрабатывать весь ввод пользователя, он попадал в специальный буфер, а уже оттуда его забирали программы. Если вы печатали достаточно быстро, вы вполне могли упереться в размер буфера и услышать звуковой сигнал, означающий, что вам надо подождать.
Буфер можно было переместить, но недалеко — в пределах, если ничего не путаю, первых 64 килобайт ОЗУ. Я тогда нашёл в ДОС два неиспользуемых зарезервированных участка памяти, куда, на выбор, и переставлял этот буфер. Второй из этих участков
Четвёртая утилита меняла палитру экрана. Если верно помню,
Следующая утилита выводила по нажатию
Шестая утилита умела записывать в файл нажатые клавиши, а потом их «проигрывать» — это было удобно для автоматизации
Седьмую утилиту я написал уже когда учился в Университете. Как я уже упоминал, я тогда работал лаборантом и, как и все лаборанты, нередко
Позже
Восьмую утилиту, возможно, следовало бы вспомнить первой. Не исключено, что с неё и начались «табуретки», но это не точно. В те времена мы много работали с дискетами и, если на них портился сектор на нулевой дорожке, где помещалось оглавление файловой системы, то её можно было выбрасывать — несмотря на то, что другие сектора в таких случаях помечались как «плохие» и просто не использовались, тот же фокус с нулевой дорожкой не проходил.
Один из наших соотечественников написал драйвер pu_1700, позволявший выбрать другую дорожку для хранения оглавления. Было только одно неудобство — драйвер приходилось запускать с разными параметрами руками, чтобы работать с разными дискетами.
В «табуретках» была резидентная программа, которая по горячей клавише патчила память pu_1700, меняя дорожку с оглавлением. Это позволяло быстро переключаться между стандартными и нестандартными дискетами.
Больше никаких подробностей я чётко не помню.
Смутно припоминаю, что была некая утилита для сканирования файловой системы, которую точно писал братишка, но что она делала вспомнить не могу. Кроме того, было
«Кардпьютер» и джойстик
Так я и не смог заказать нужный мне джойстик к «Кардпьютеру» — как я уже рассказывал везде конец истории один — отправляю деньги, продавец выжидает, потом отменяет заказ, деньги возвращаются. В итоге сделал ход конём — купил джойстик другой версии и просто дописал прошивку, чтобы она его поддерживала.
Оказалось несложно — я нашёл коммит, где добавили поддержку другого джойстика, там очень понятный код. Заработало сразу почти правильно, только пришлось поменять верх и низ местами. Эмулятор я пока не нашёл (если предположить, что он существует), а сама прошивка компилируется очень просто, запишу себе, чтобы не забыть:
# установка всех нужных инструментов
curl -fsSL -o get-platformio.py \
https://raw.githubusercontent.com/platformio/platformio-core-installer/master/get-platformio.py
python3 get-platformio.py

# сборка прошивки
~/.platformio/penv/bin/pio run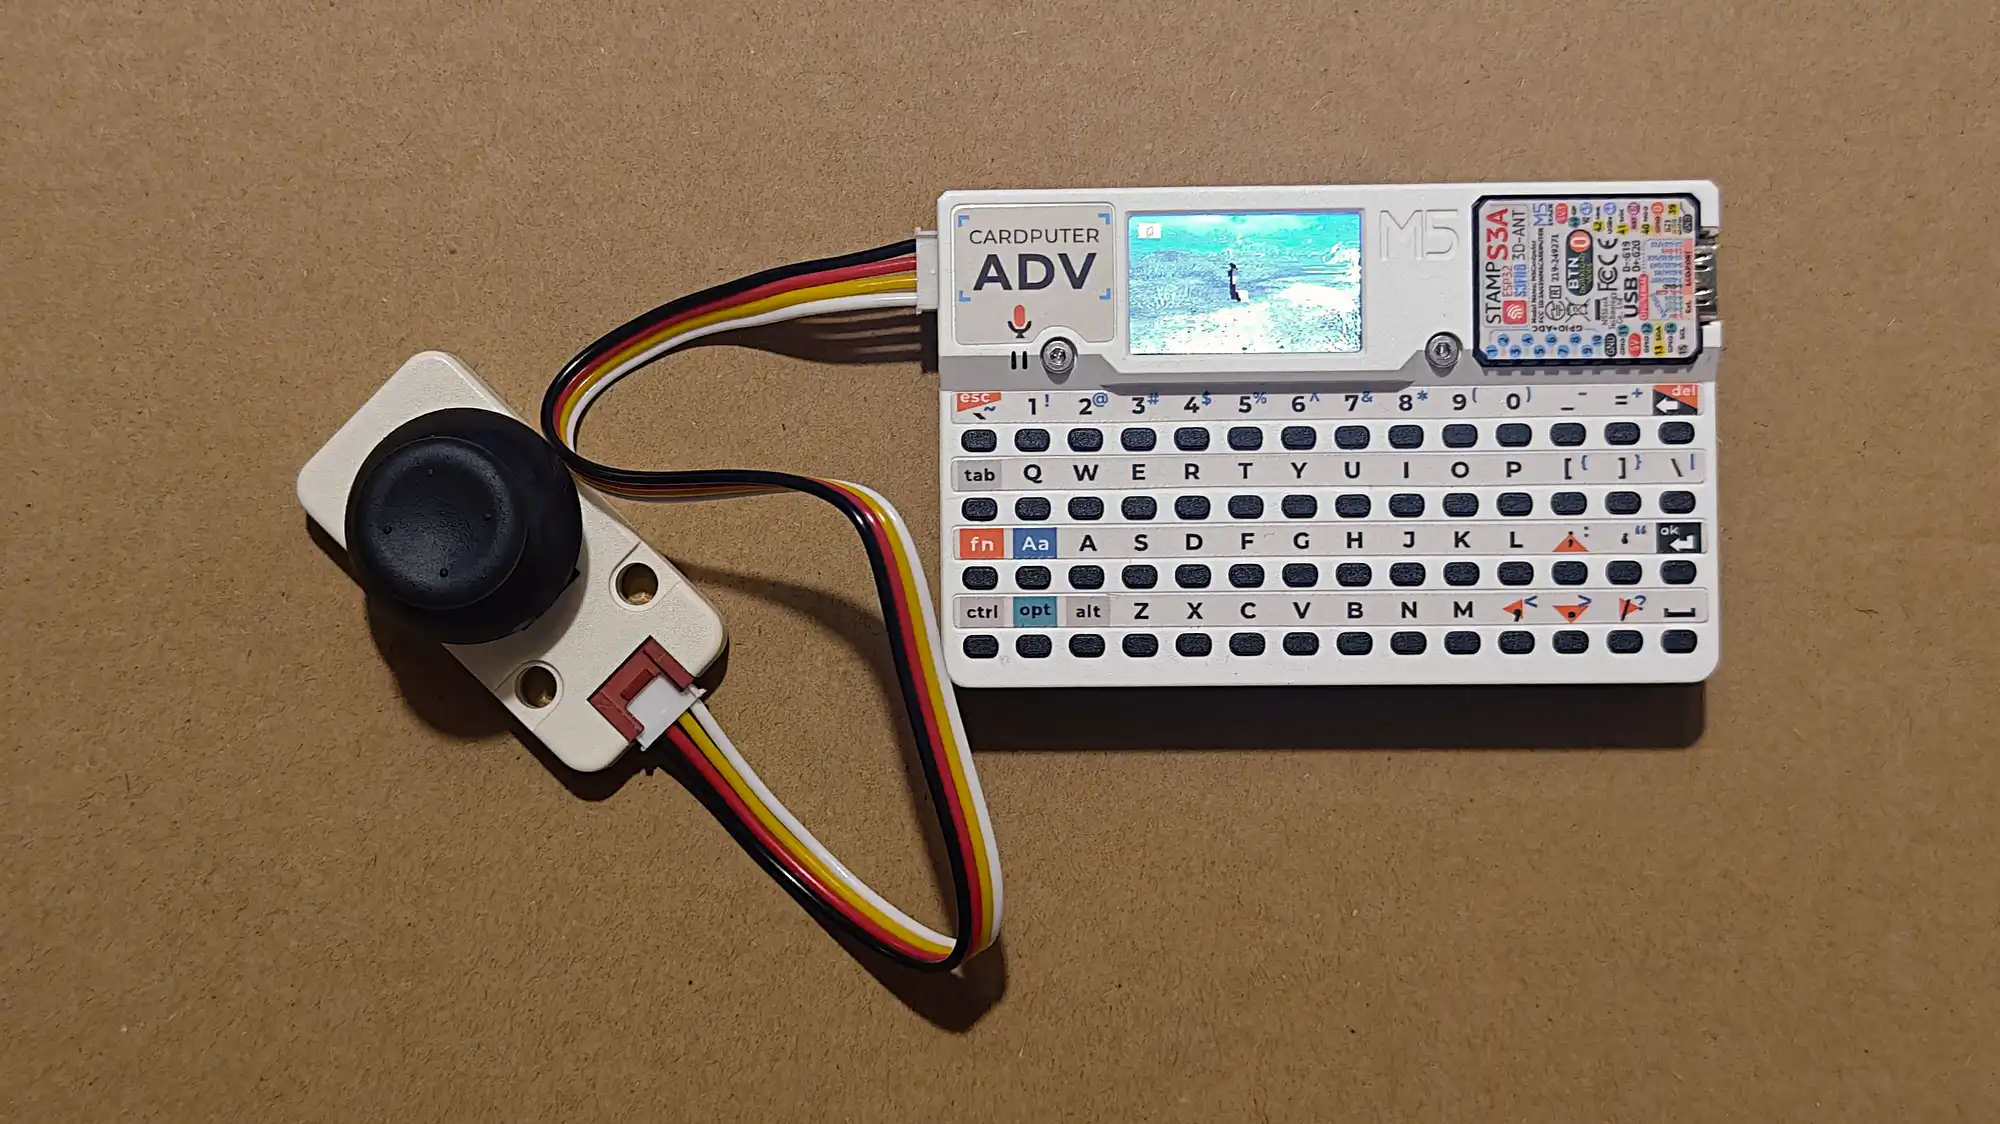
Добавлено 12 февраля: о, мой код по поддержки джойстика этой версии вмержили внутрь прошивки пакета эмуляторов. Теперь можно скачивать новые версии без необходимости их патчить!
«Invalid page» и «тост»
Недавно у одного из клиентов развалилась часть таблицы в «Постгресе» — в логах видно, что при чтении не совпадают контрольные суммы. Ничего особо нового — за последние несколько лет встречал эту проблему несколько раз у разных клиентов и даже описал алгоритм восстановления базы из разных источников у себя на сайте.
Там у меня в заметке есть хранимая функция, которая сканирует таблицу и сообщает какие именно строки требуется восстановить. Но в этот раз она мне, как ни странно, не помогла — завершилась, не выдав ничего. Раньше она осечек не давала и я, не поверив себе, даже запустил её дважды.
Долго разбирался в чём дело, разобрался. Принцип работы моей функции такой — она вынимает каждую строку, если получает ошибку, то сообщает об этом. Но оказалось, что если
В итоге я переделал хранимку — передаю всё строку целиком в функцию ROW_TO_JSON, чтобы прочитались и значения из «тостов». Это помогло, функция стала работать как и задумывалось.
CREATE OR REPLACE FUNCTION check_table(table_name TEXT)
RETURNS void AS $$
DECLARE
    rec RECORD;
    row_data RECORD;
BEGIN
    FOR rec IN EXECUTE format('SELECT ctid::text AS ctid_str, id FROM %I', table_name)
    LOOP
        BEGIN
            EXECUTE format('SELECT * FROM %I WHERE ctid = %L::tid', table_name, rec.ctid_str)
            INTO STRICT row_data;

        row_data := ROW(ROW_TO_JSON(row_data)); /* to read the toasts */

        EXCEPTION WHEN others THEN
            RAISE WARNING 'CTID: %, ID: %, Error: %', rec.ctid_str, rec.id, SQLERRM;
        END;
    END LOOP;
END;
$$ LANGUAGE plpgsql;
Посканировал сеть «Веб-архива»
Я был излишне оптимистичен по поводу сканирования локальных адресов
В итоге я взял самый маленький диапазон и стал смотреть только
Даже в таком режим нашлось куча
Например, на моём скриншоте найденный блог с рассказом как автор гнобит своего коллегу. Копия этого сайта, кстати, есть
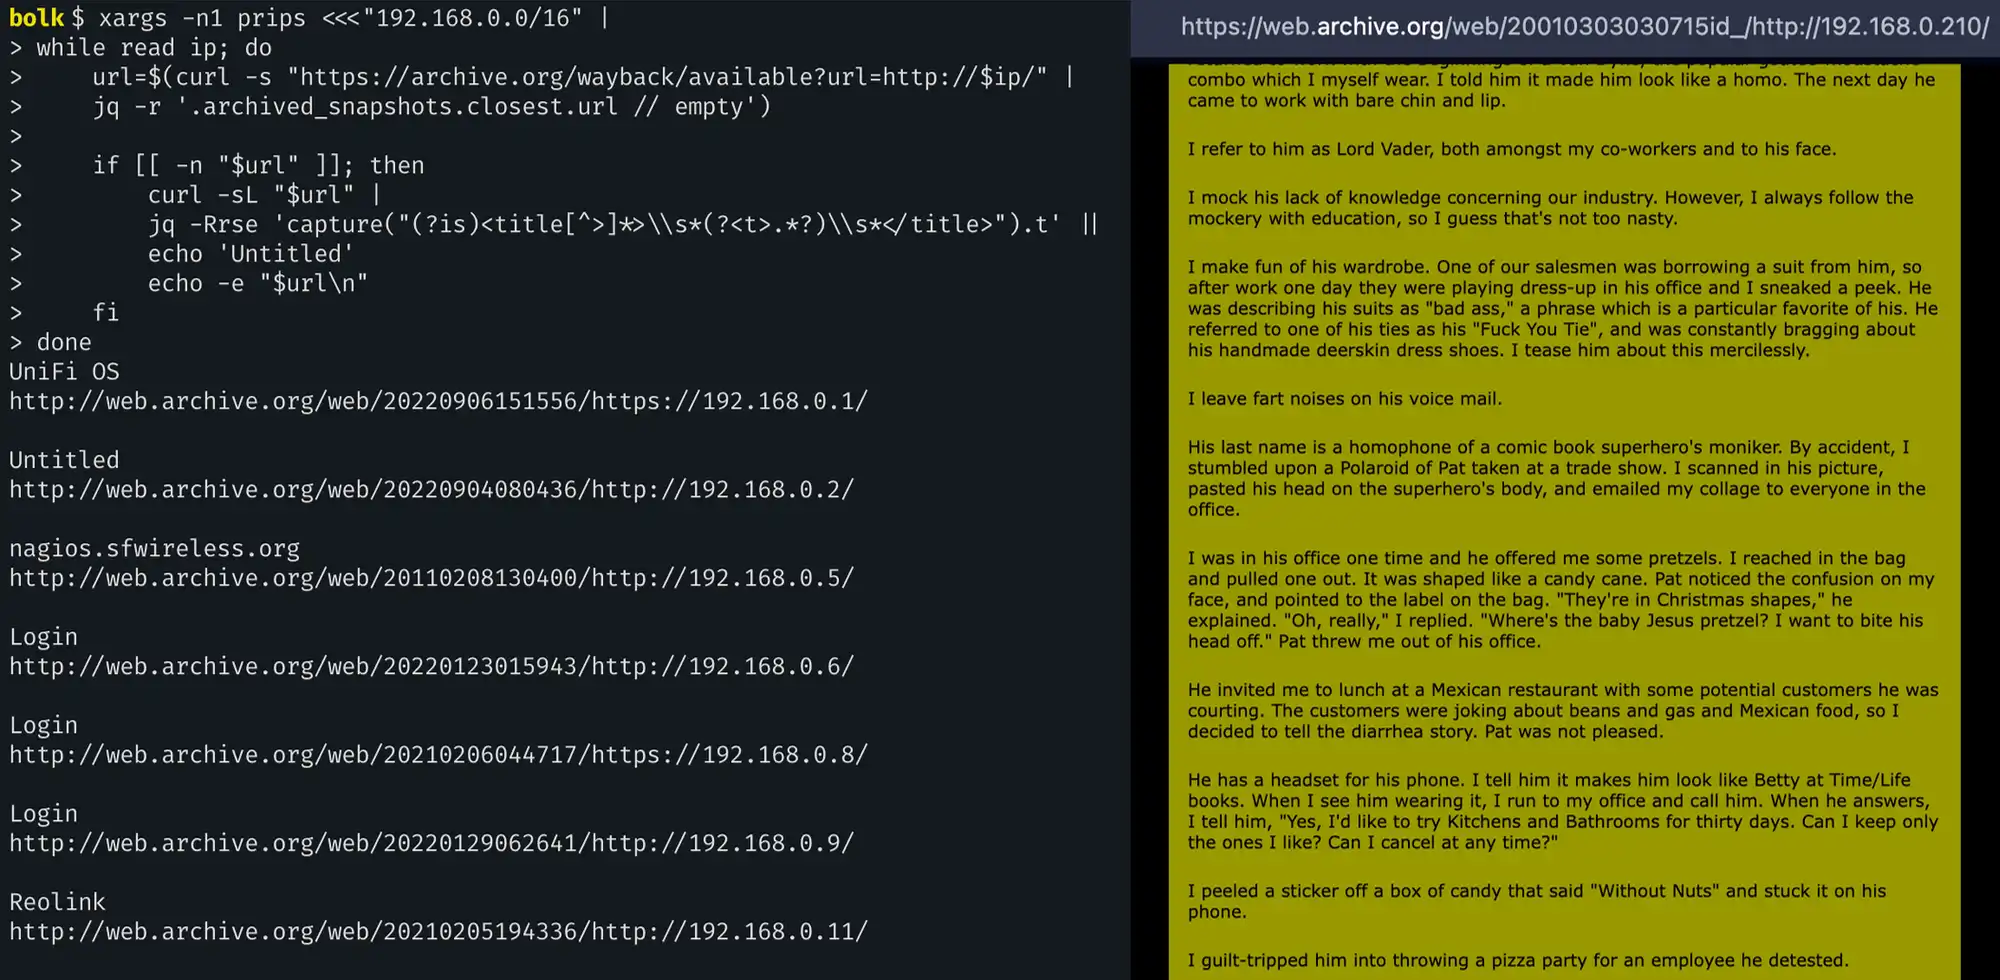
Локальные адреса в «Веб-архиве»
★
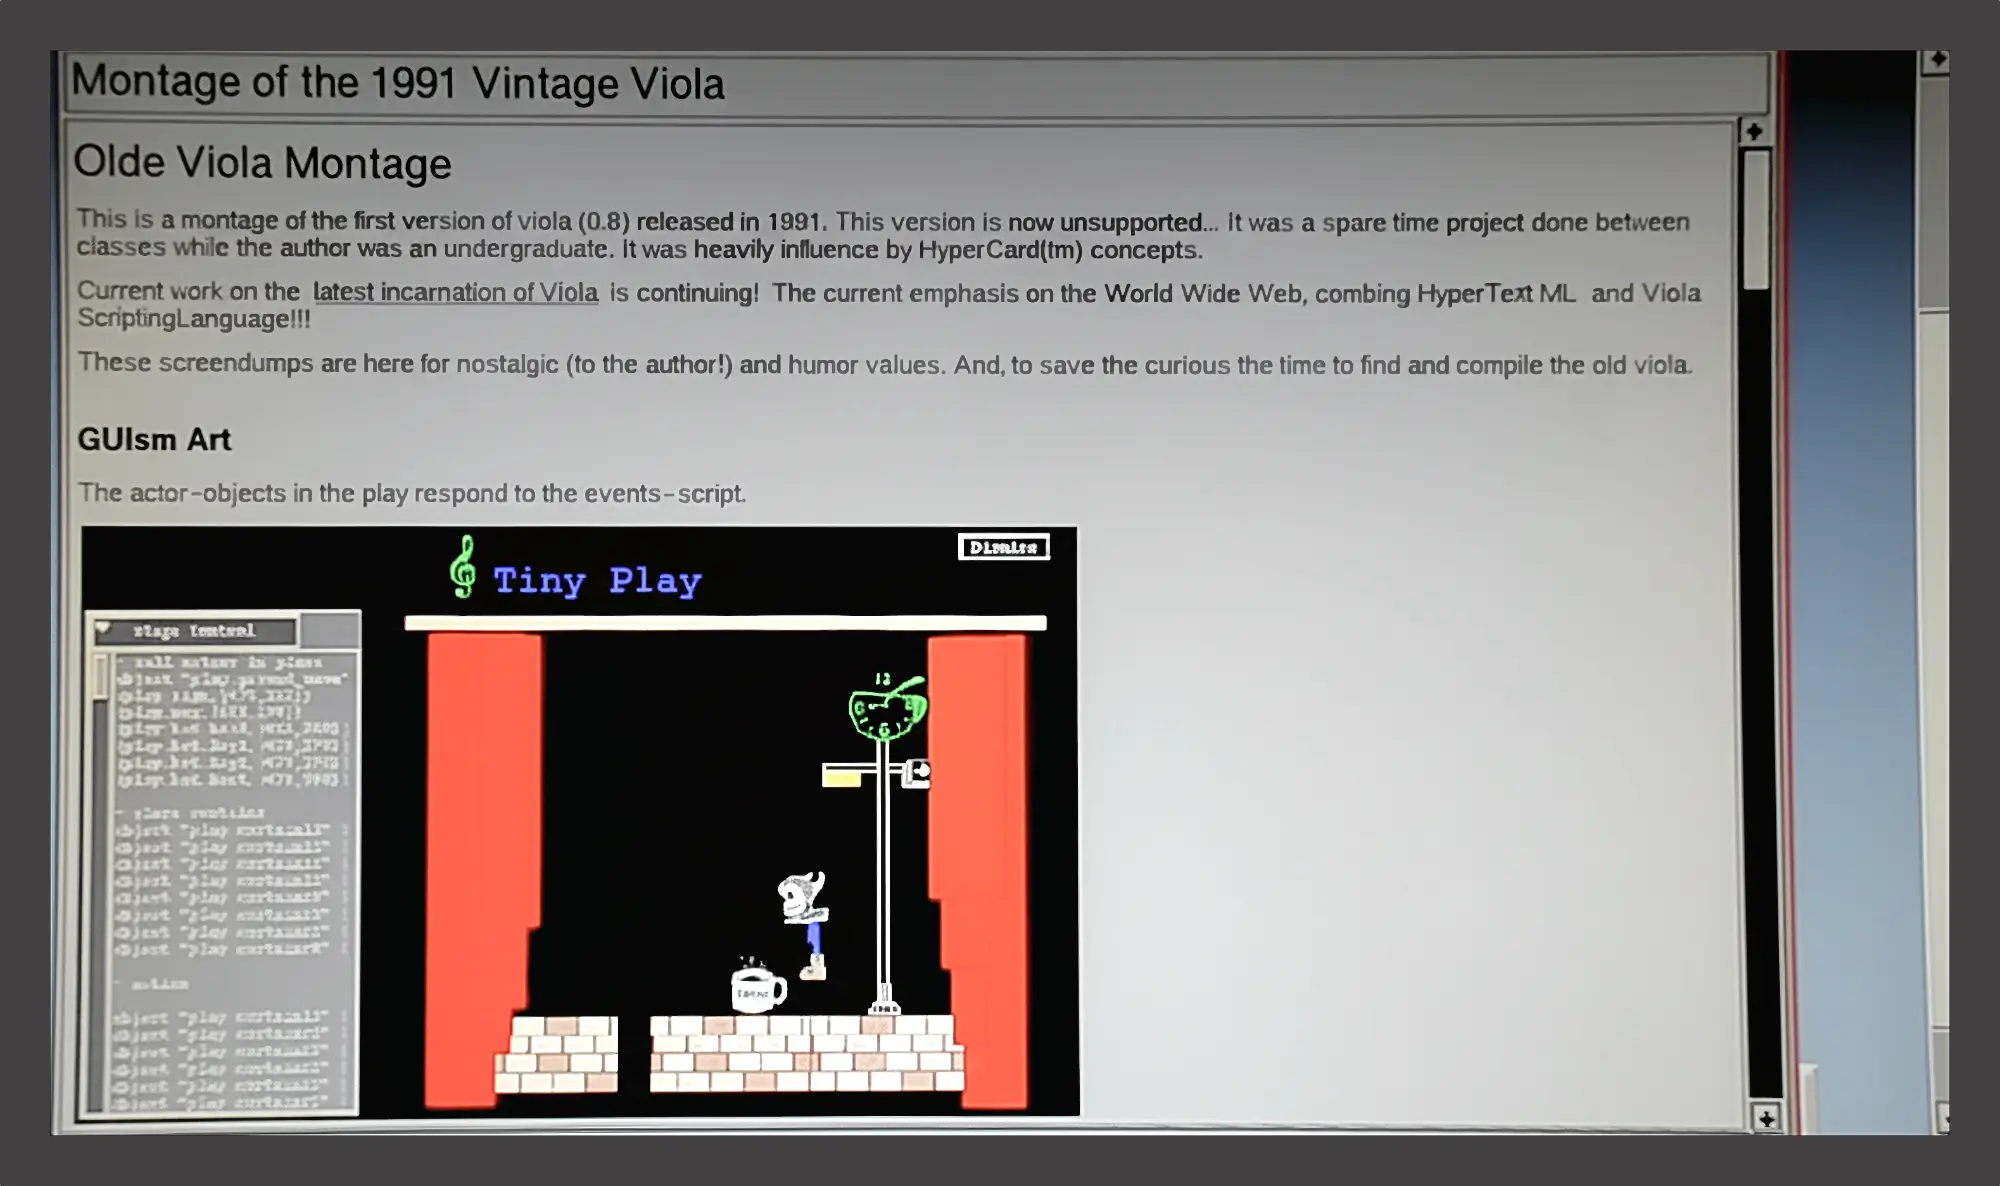
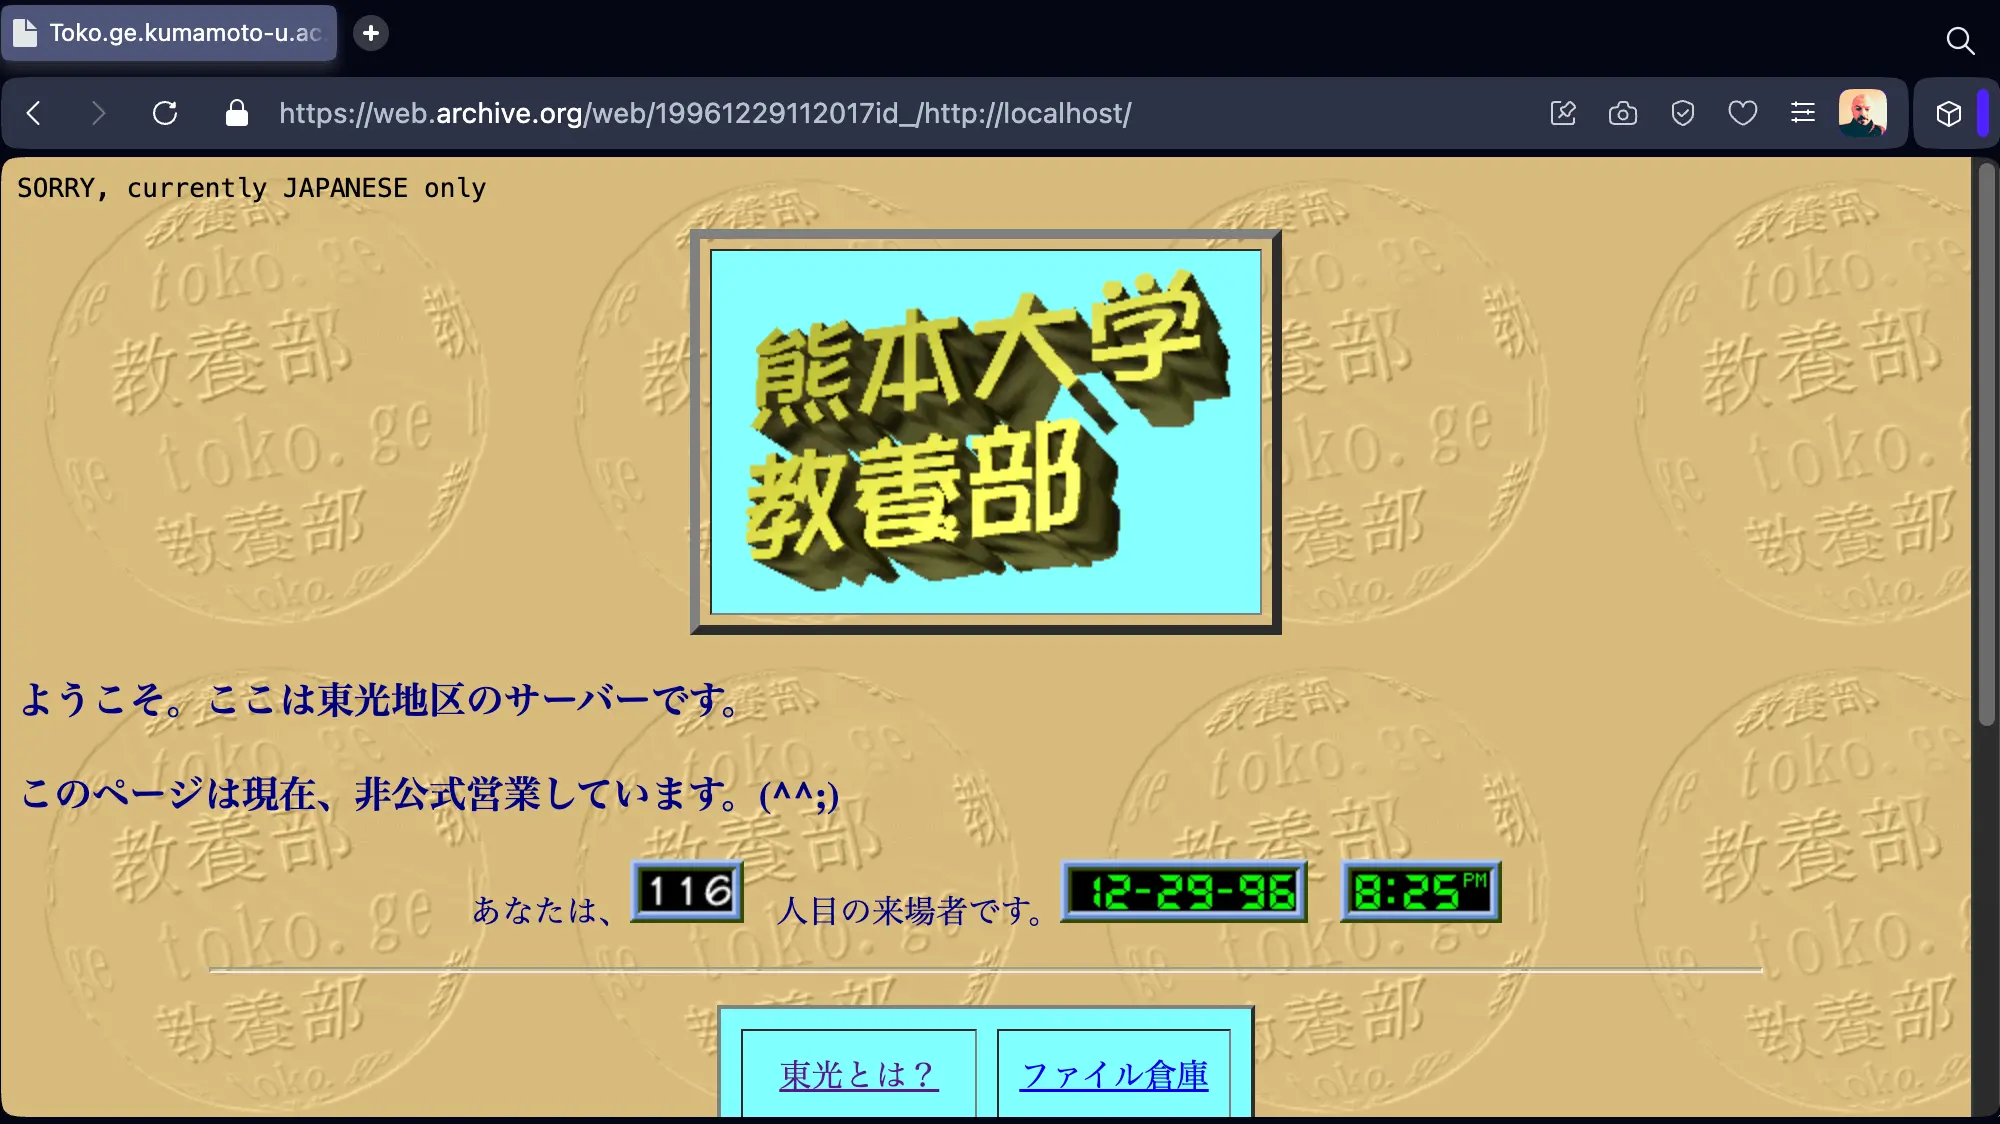
Я тут благодаря «Виоле» обнаружил
В моей версии этого браузера я делал логику, согласно которой, если домен не открывается, то я пытаюсь найти и открыть его самую раннюю сохранённую копию
В браузере есть несколько встроенных ссылок на разные давно не существующие сайты, и эта логика нужна, чтобы внешние ссылки с них нормально открывались.
Я не учёл, что локальные адреса — localhost, 127.0.0.1 и прочие — не должны искаться
Оказалось,
Поскольку снапшоты за разное время
Попробовать что ли сканер написать, который составит список всего этого богатства…
PHP: (binary)
И, чтобы, как говорится «два раза не вставать», расскажу про самую бесполезную конструкцию в ПХП. Я знаю, что не так много народу знают про (unset), про которую я ворчал вчера, а про эту вещицу, как мне кажется, знает ещё меньше программистов на ПХП.
Одна из неприятных вещей, которые остались в ПХП с давних времён — работа встроенных функций и конструкций только со строками в однобайтовых кодировках. С этим можно жить — есть библиотеки, которые позволяют замести эту проблему под ковёр, но сам язык помогать вам в этом не будет.
К сожалению, работу доделать не осилили, очень уж было сложно, особенно тяжело шло с расширениями. В итоге версия так и не вышла, но так как о ней широко раструбили, пришлось даже пропустить номер — после ПХП 5 вышла сразу седьмая версия.
Но некоторые отголоски этой не совершившейся революции
В версии 8.5 по сих пор есть преобразование типа (binary), которое является алиасом к (string), но выдаёт предупреждение об устаревшей конструкции. А кроме этого, у строки есть префикс b: b"string", придуманный для того, чтобы создавать в ПХП6 однобайтовые строки. В современных версиях ПХП он, разумеется, ничего со строкой не делает.
И эту всю красоту из языка
PHP: (unset) и (void)
Язык PHP часто ругают. Большей частью — заслуженно, но часть давно решённых проблем тянется за ним, как смрад за народным ополчением в Средние века. Ненавистники часто глубоко в проблемы языка не вникают — им неинтересно, перепечатывая аргументы, которые много лет как несостоятельны.
Как мне кажется, самая большая проблема языка сейчас — это его процедурное прошлое, которое торчит изо всех щелей. Но есть и менее заметная, при этом системная проблема: у языка нет «великодушного пожизненного диктатора», как у Пайтона или Линукса, или более «сыгранной» команды, определяющей долгосрочные цели в развитии языка.
Некоторые разумные,
Я хочу поворчать на одну из таких мелких тем.
В ПХП с незапамятных времён была конструкция (unset), которая приводила любой тип к NULL. Не самое очевидное название, поэтому, наверное, и применял её мало кто — не всем очевидно чем она могла бы быть полезна.
Тем не менее, я со временем догадался, что можно её приспособить, чтобы обозначать, что
class Smth
{
    private function saveSmth($stat)
    {
      // тут какие-то действия
      // прошло успешно, но выше где-то может быть и false
      return true;
    }

    public function doSmth($action, $stat)
    {
       // тут какой-то код
       // результат вызова метода ниже мы игнорируем
       (unset) $this->saveSmth($stat);
       return true;
     }
}
Мне казалось и до сих пор кажется, что это полезный паттерн. В «Гоу», например, в этом случае нужно присвоить возвращаемое значение специальной переменной _, иначе компилятор ругается.
И вот, много лет назад, в версии 7.2 использование (unset) в коде стало вызывать предупреждение об устаревшей конструкции. Я тогда попытался
А в версии 8.5 внезапно та же идея возвращается под новым именем, только теперь нужно писать (void), а не (unset).
Да, имя более логичное, да функционал расширен — появился ещё и новый атрибут, да синтаксис изменён — результат (unset) можно было
«Виола»: формулы и стилизация
Долго же я прикидывал правда ли автор «Виолы» задумывал, чтобы математические формулы у него выводились на красном фоне. С одной стороны в коде именно так, да и мне это кажется даже
Действительно, есть ли в этом смысл? Почему именно формулы на странице должны быть

На скриншоте красного фона нет. Видимо
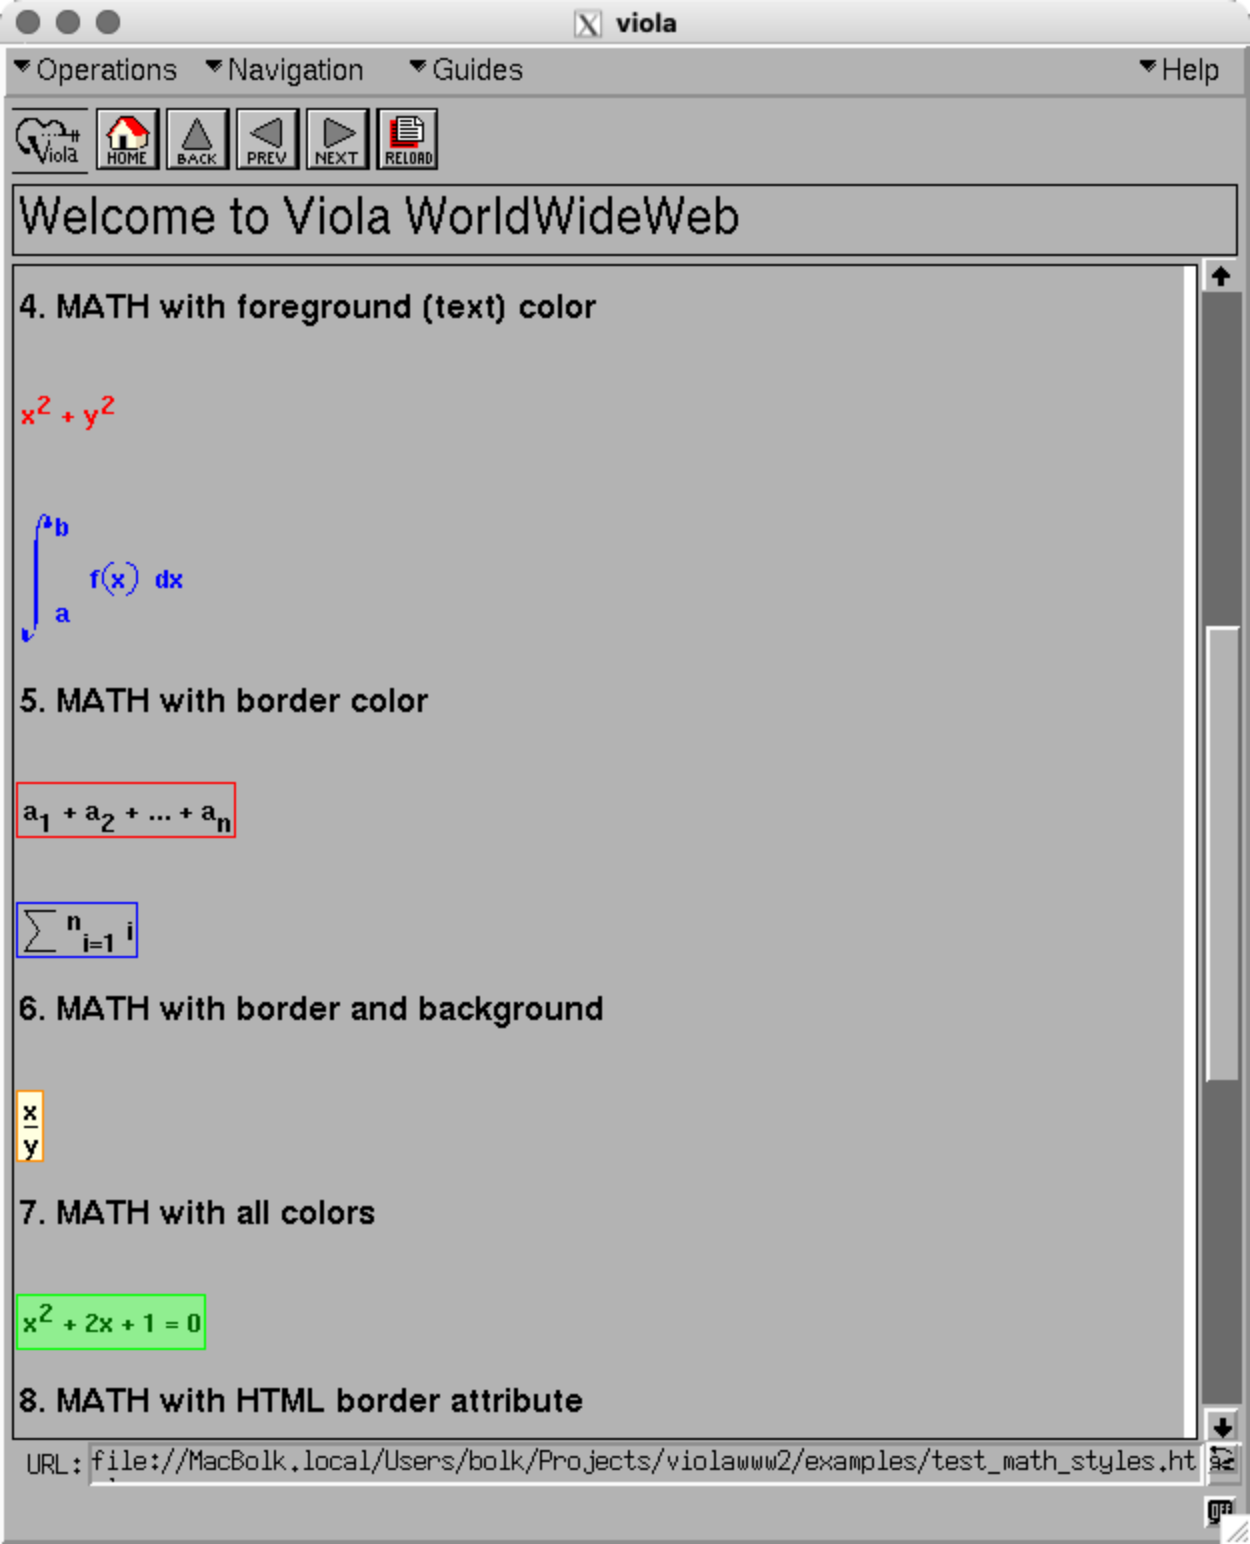
В общем, от красного фона я избавился и сделал возможность стилизовать формулы в соответствие с закомментированным кодом, который автор не дописал — у формул должна была появиться возможность устанавливать цвет фона, шрифта и бордюра. Всё это заработал в последнем коммите.
Вот, кстати, как выглядело недописанное место, где можно подсмотреть что планировалось сделать:
tagPtr = STG_tagPtr("MATH");
i = STG_attr(tagPtr, "BGColor");
if (i) set("BGColor", i);
i = STG_attr(tagPtr, "FGColor");
if (i) set("FGColor", i);
i = STG_attr(tagPtr, "BDColor");
if (i) set("BDColor", i);
А то некоторые читатели недоумевают, наверное, откуда я вообще знаю что задумывал автор.
Этот кусочек выше был закомментирован и не дописан, зато из него видно, что автор собирался стилизовать задний фон (BGColor), цвет шрифта (FGColor) и цвет бордюра (BDColor).
Нередко такие места содержат в себе достаточно понятные намёки на то как это было задумано, в других же случаях помогают комментарии, главы из недописанной книги автора или его редкие письма в различные группы рассылок, куда он редкий раз писал свои мысли в самом начале
Человек: как убить трёхчасовой вайбкодинг
Я уже рассказывал как нейросеть
Первые три часа работы над прототипом, про который я недавно писал, я очень спешил и для экономии времени даже не заводил репозиторий, ну и ничего не коммитил, соответственно, решив, что на старте проекта в этом ничего страшного нет.
Уже после обеда, решив зафиксировать,
Тут меня буквально на мгновение отвлекли
Минуту, наверное, я ошарашенно смотрел на дело рук моих, но потом вспомнил, что
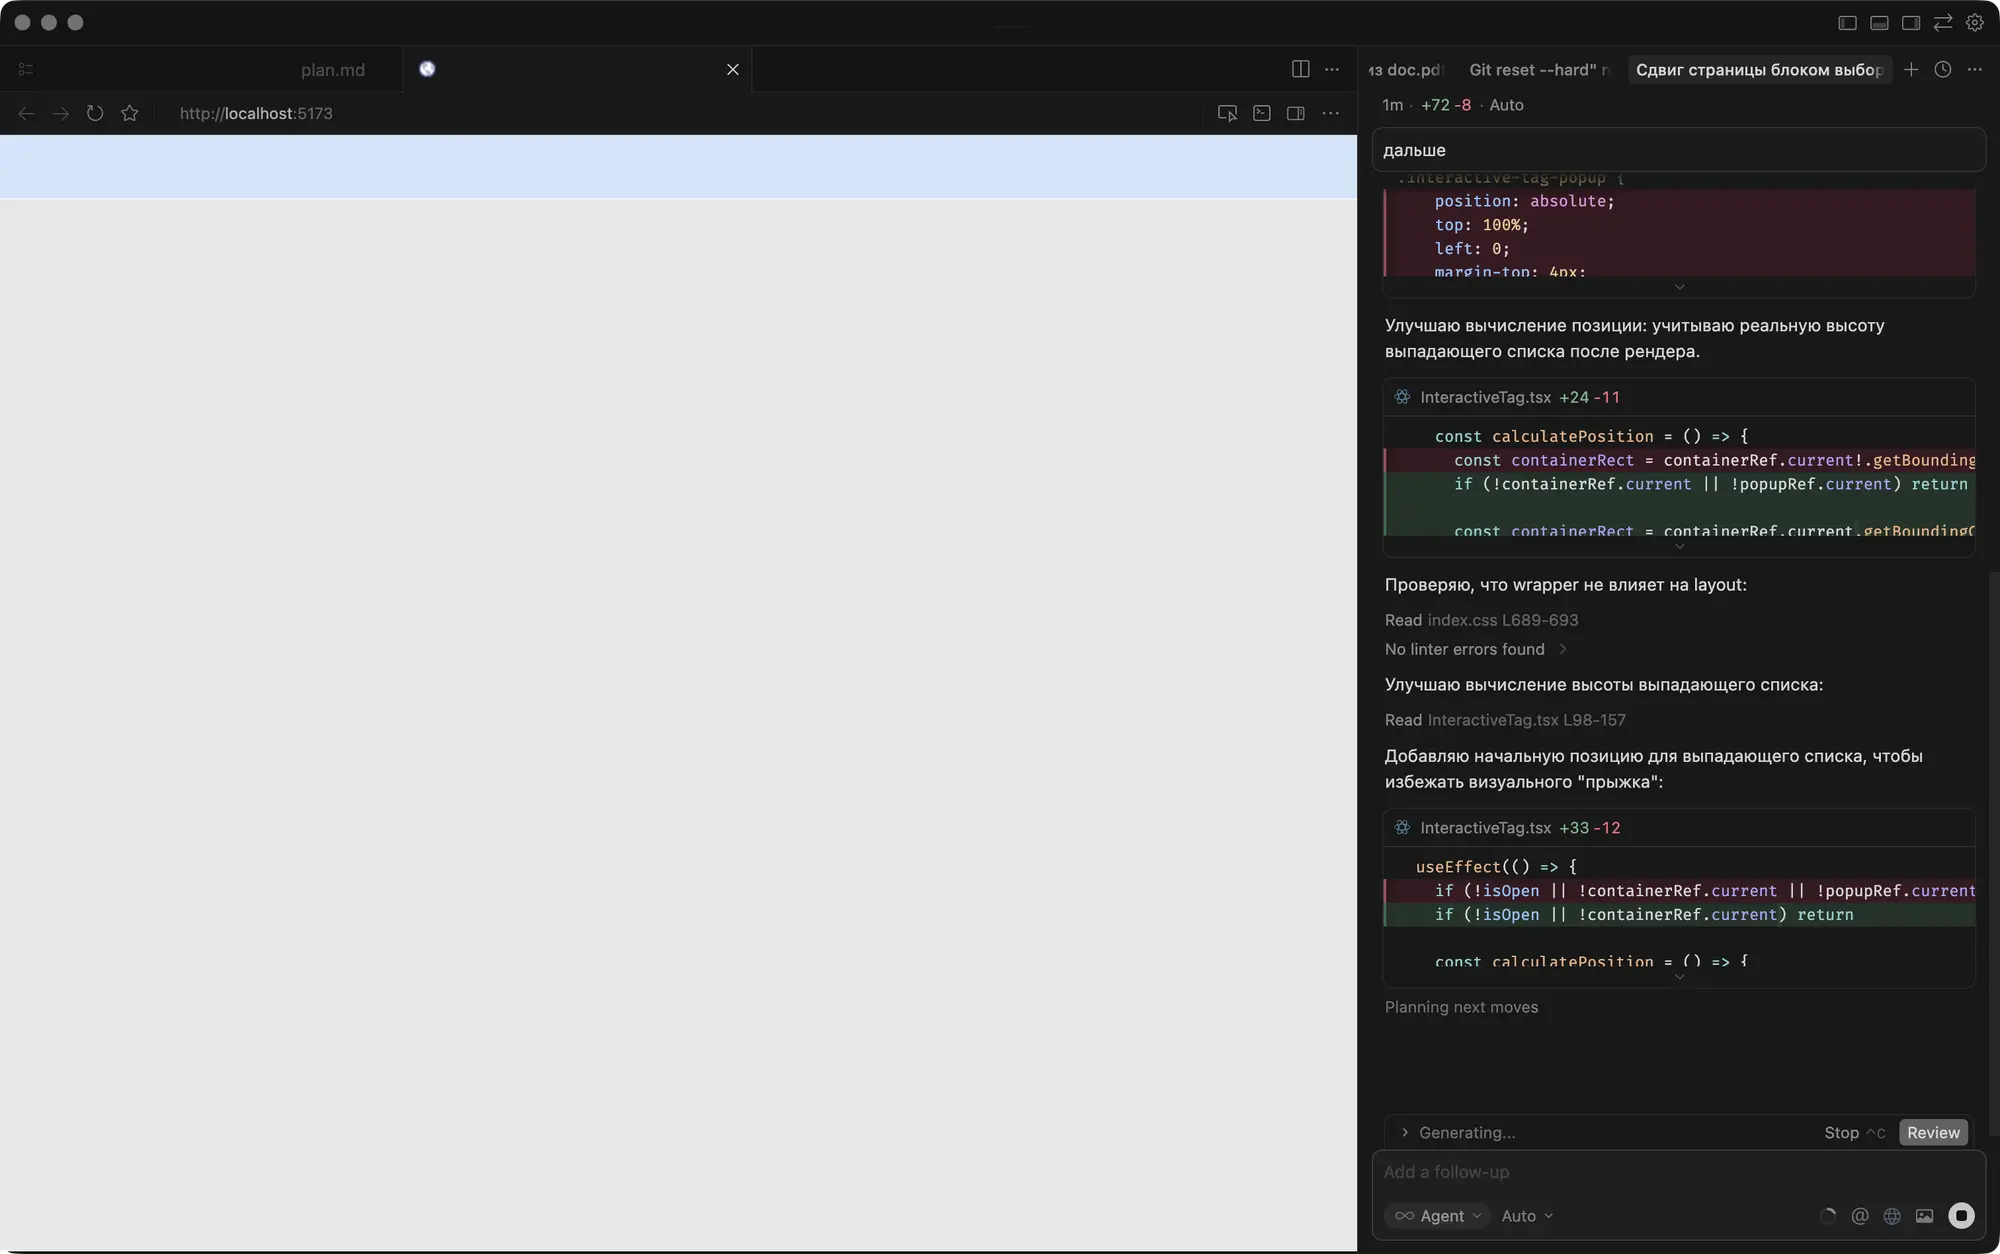
В том же редакторе, где вайбкодил, — в «Курсоре», спросил у нейросети нельзя ли
Если присмотреться, то на скриншоте прототипа, который мне пришлось почти полностью вымарать, можно увидеть заголовок окна чата с моим вопросом про эту ситуацию.
Прототипирование и ИИ
На работе у нас проект одного очень сложного модуля к нашему продукту, дизайн которого мы делаем уже почти год. Бывает так, что мы его откладываем, занимаемся другими делами, потом возвращаемся, но длится это уже очень долго. Одна из причин — никак не удаётся нащупать правильные решения.
Технологическая сложность очень велика, поэтому запрототипировать дизайн малыми силами не удалось, к тому же он ещё только формируется.
А на днях я подумал — почему бы не попробовать сделать прототип (срезав
Выгрузить вёрстку из «Фигмы», где у нас нарисован дизайн, нам не удалось — предназначенные для этого плагины ничего не дали. Я решил с этой проблемой не бодаться, а попробовать сделать вёрстку из картинки «нулевого состояния», постепенно добавляя поведение так, как это описано в техническом задании.
Это был самый утомительный этап — картинку нейросеть «видит», но судя по тому как получилась первая версия, она её себе
Особенно хорошо это было заметно на иконках — элементы на них, чаще всего, те же самые, но нарисованы совсем иначе. Если остальную вёрстку я сумел выправить промптами, то иконки мы просто вытащили из «Фигмы», назвали говорящими именами и нейронка сама догадалась куда их применить.
Так же пришлось, кстати, поступить и с цветами. На скриншоте я убрал весь получившийся интерфейс, потому что не могу его показывать, но полоску заголовка оставил, только всё оттуда стёр.
На приведение в порядок того, что модель наверстала, ушёл, наверное, час, после этого мы вырезали кусок из технического задания, где описывались механики и я скормил это нейросети как есть. Часа через три у нас был прототип, с которым
Потом я просто сказал нейросети где лежит кусок технического задания по которому ему надо написать код, после чего всё заработало
На этом прототипе днём позже мы смогли оценить
При этом я не рассматриваю сделанную работу как готовый кусок кода, который можно затем будет интегрировать в проект. Этому есть несколько причин:
«Виола» и безопасность
Когда я только начинал заниматься восстановлением браузера «Виола», меня поразило как много он себе позволяет делать в системе. Если бы браузер с такими возможностями и с полным отсутствием защиты от несанкционированного их применения дожил до конца девяностых, хакеры бы от его репутации камня на камне не оставили.
Конечно,
At this point you’re probably thinking how great this this, but how do I know that the applets I run won’t delete my files, smuggle info out of my system, and do other mischiffs?
The answer is that these imported objects can’t (or shouldn’t be able to).
The current security policy is pretty straightforward and somewhat limiting for the objects. It basically goes this way: all imported objects are marked as untrusted, and as such these imported objects have no system priviledges, have no access to sub interpreters, and can not coarse other objects to execute scripts arbitrarily.
Видимо эта работа так и не была завершена, но, что радует, была начата. Я изучил всё то, что автор писал по этому поводу у себя на сайте, в группах рассылок и коде браузера и тщательно описал что именно было сделано. Потом я определил, что нужно доделать в коде, чтобы обеспечить минимальную защиту компьютера пользователя от вредоносных сайтов, и приступил к работе.
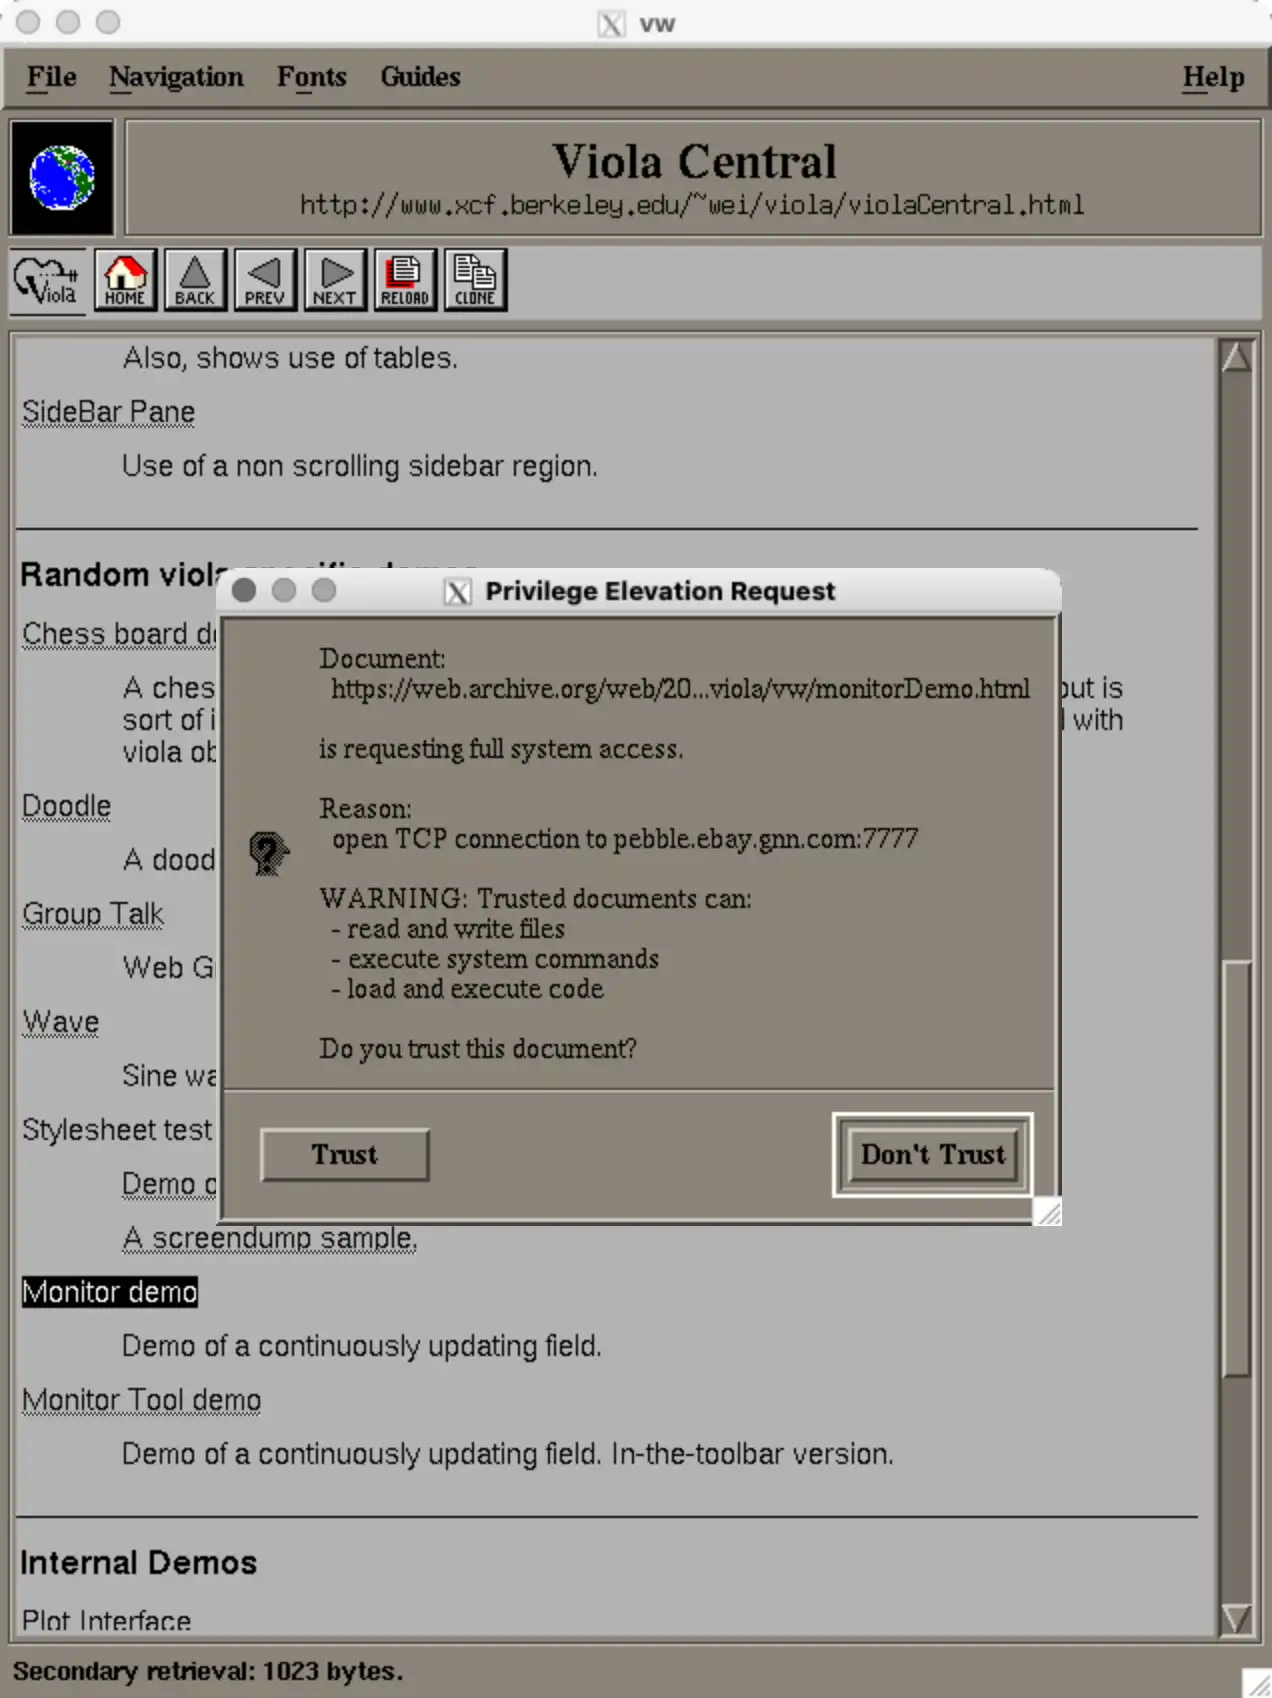
Конечная реализация вышла довольно прямолинейной. Браузер может работать в одном из двух режимов: защищённом и нет. Когда браузер переходит
В популярном приложении одно э́то было бы проблемой, но я не вижу смысла спрашивать разрешение и для локальных страниц, так как это осложнит мне тестирование браузера. Так что я себе проделал небольшую брешь в защите.
Из защищённого режима браузер переключается в режим без защиты только с разрешения пользователя, переключение инициируется, если во время интерпретации скрипта встречается вызов, требующий переключения в доверенный режим (например, работа с файловой системой или открытие сокета), а так же, если на странице установлен тег SECURITY с атрибутом LEVEL=0.
Оказывается, автор браузера предосмотрел такой тег, но не успел реализовать. Название атрибута в коде уже было, а вот его значение — это моё обоснованное предположение. В коде есть центральный флаг securityMode, принимающий два значения — 0 (система безопасности отключена) и 1. Я предположил, что атрибут LEVEL должен влиять на значение этой переменной.
Если пользователь не согласился на переход в доверенный режим, вызов, запросивший повышение привилегий, завершается с нефатальной ошибкой — там, где можно вернуть флаг того, что произошла ошибка, я это делаю. Как только браузер встретит следующий такой вызов, он опять попросит разрешения сменить режим. Тут, опять же, слабое место, — можно заспамить пользователя такими запросами. Собственно, эта проблема была в любом браузере девяностых годов.
Решается она просто. Например, можно добавить в диалог галочку «больше не спрашивать» и не позволять его вызывать до перехода на другую страницу, но это настолько не в духе браузеров тех годов, что я тоже не стал этого делать.
Если мы перешли в доверенный режим, то он сбросится на следующей же странице, загруженной из интернета.
Я потратил так много усилий и токенов нейросетей, чтобы сначала понять замысел автора, потом придумать в её рамках реализацию, закрывающую все белые пятна, а потом реализовать, что немного выдохся и пока больше таких больших доработок не делал, да и токены надо бы поэкономить. Поэтому пока что я доделываю всякие мелочи и дописываю документацию.
Но не будь нейросетей… Я уже не раз повторял это в частных разговорах, но, кажется, ни разу не писал у себя в блоге: без нейросетей я бы этим заниматься не стал. Усилие от реализации этих доработок без нейросетей во много раз перекрывает удовольствие от этой работы.
Особый режим «Веб-архива»
Вчера я, занимаясь «Виолой», случайно узнал Полишинеля. Подозреваю, что многие знают, а для меня это новость.
Видимо
Я пытался с этим бороться, вырезая ненужную мне вставку, но это не всегда нормально работает. Вчера я догадался погуглить есть ли
В ссылку после даты надо всего лишь добавить слово id_!
Например, эта страница откроется с баннером:
https://web.archive.org/web/19971210184100/http://info.cern.ch/
А эта — без:
https://web.archive.org/web/19971210184100id_/http://info.cern.ch/
99 бутылок: Basic в UNIXv4
А раз я узнал как запустить UNIXv4, грех не воспользоваться возможностью посмотреть что там за языки программирования есть на борту. Ассемблер и Си меня не заинтересовали, но оказалось, что в комплект входит довольно интересный «Бейсик», маленький, но мощный.
На нём я и решил написать «Песню о пиве».
86. Basic в UNIXv4 работает в двух режимах — интерактивном, в нём операторы вводятся без номера и выполняются сразу же, и программном, где номер строки указывается, а оператор запоминается для последующего выполнения. Этими двумя режимами можно пользоваться вперемешку.
Редактора нет, набивать программу нужно сразу в буфер интерпретатора, либо создавать при помощи стороннего редактора. Важно не ошибиться, так как редактировать программу можно только полной заменой строки, указав новому варианту тот же номер.
Почти во всём это довольно стандартный «Бейсик», но тут есть две особенности.
У меня в коде есть пугающая конструкция goto 2110 + 10 * ((arg(1) > 0) + (arg(1) > 1)). Выглядит страшно, признаюсь, я её специально запутал, так, мне кажется, лучше передаётся дух эпохи, судя по старым программам, так вполне могли тогда написать.
На самом деле тут всё просто: выражение в скобках для нуля даёт ноль, для единицы — единицу, а для значения больше единицы — двойку. Это нужно для условного перехода на разные части подпрограммы, так как строкового типа нет и единственный способ вывести нужную строку — передать её в print как есть.
Кроме числового типа (числа с плавающей точкой тоже поддерживаются), есть массивы, причём даже двумерные с индексами от нуля до 32768.
10 for i=0 98
20 2000(99-i)
30 2100(98-i)
40 print
50 next
60 print "No more bottles of beer on the wall, no more bottles of beer."
70 print "Go to the store and buy some more, 99 bottles of beer on the wall."
80 done

2000 if arg(1) == 1 goto 2030
2010 print arg(1) " bottles of beer on the wall, " arg(1) " bottles of beer."
2020 return
2030 print "1 bottle of beer on the wall, 1 bottle of beer."
2040 return

2100 goto 2110 + 10 * ((arg(1) > 0) + (arg(1) > 1))
2110 print "Take one down and pass it around, no bottles of beer on the wall."
2115 return
2120 print "Take one down and pass it around, 1 bottle of beer on the wall."
2125 return

2130 print "Take one down and pass it around, " arg(1) " bottles of beer on the wall."
2135 return

run
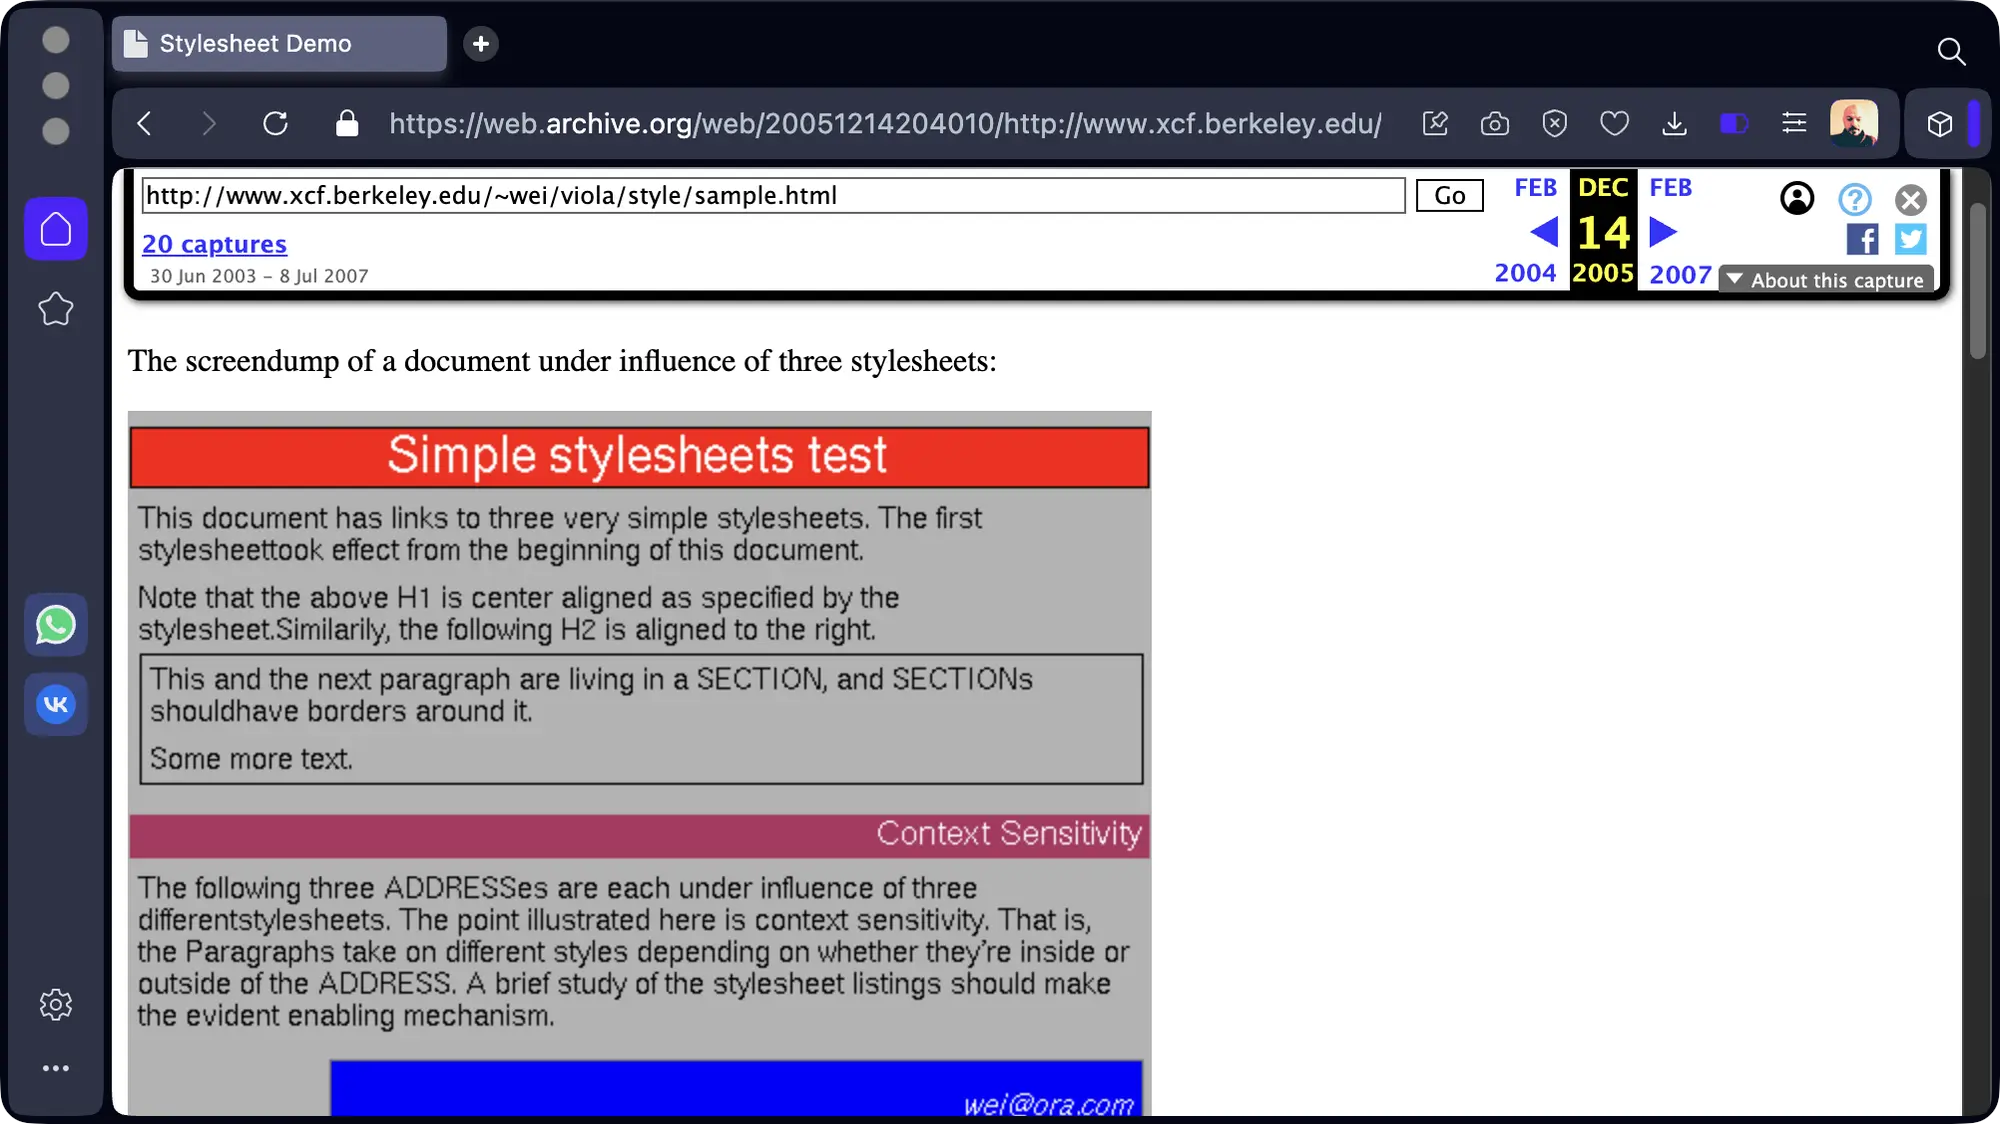
Программу, которая у меня получилась и её вывод я заскриншотил для истории. Интересно, конечно, когда в последний раз на этом «Бейсике»
«Вампус» и ChatGPT 5.2
Прочитал тут новость, что недавно была обнаружена лента с кодом операционной системы UNIXv4. Этот код считался утерянным, но в декабре его смогли восстановить с ленты и я, конечно же, сразу пошёл смотреть что из себя представлял Юникс в 1973 году.
Ничего особо интересного, кстати, команд — кот наплакал. Некоторые вполне узнаваемы (cat, например, или pwd), некоторые выглядят непривычно (chdir вместо cd), а некоторых нет вовсе (sed, awk).
Зато есть несколько игр, одна из которых — моя старая знакомая, игра «Hunt the Wumpus». Моё знакомство с ней началось с поисков игры «Убей вампира»
Игра текстовая и очень простая для программирования, я её несколько раз реализовывал, например, для наручных часов «The Sensor Watch», но это не значит, что я умею в неё играть! Я
В этот раз я тоже не стал заморачиваться, а вместо этого решил посмотреть — выстроит ли стратегию
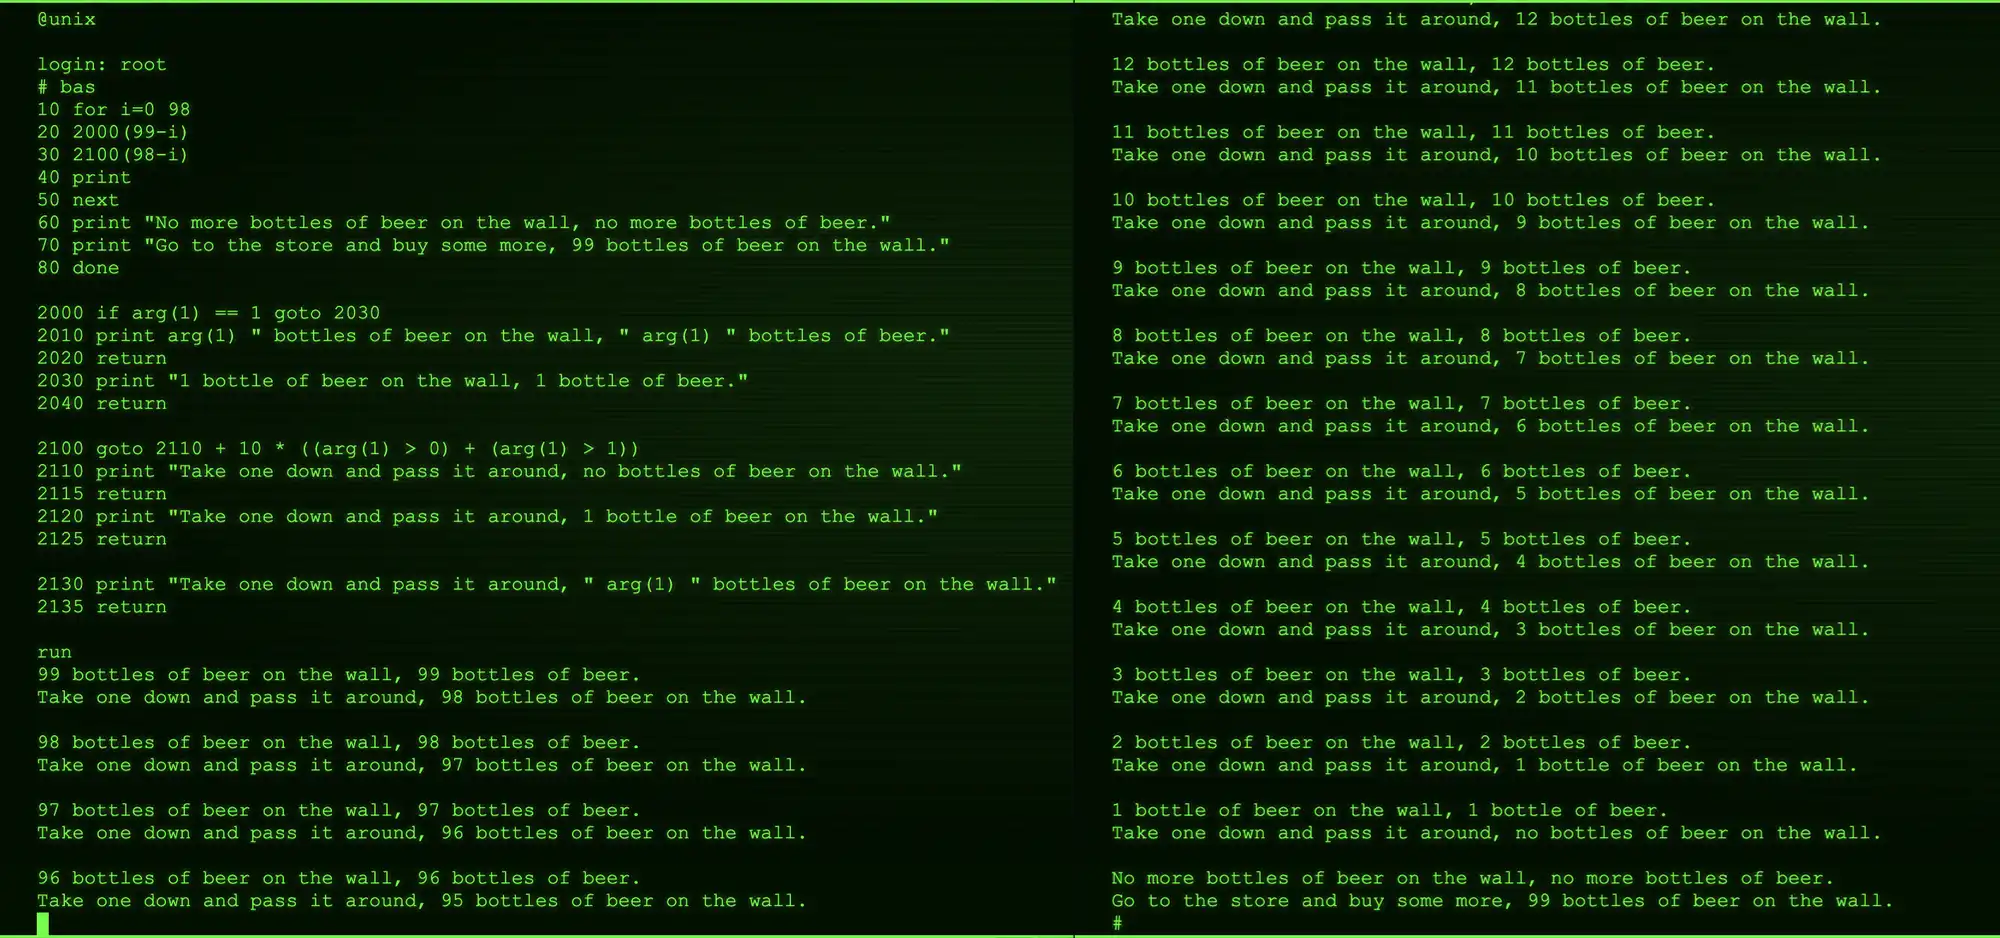
Первые три игры нейросеть проигрывала, выясняя правила (они отличаются от реализации к реализации), а после, получив все подробности, начала выигрывать. Я сыграл с её подсказками пять партий, все пять она выиграла.
Сетка утверждает, что единственная возможность проиграть — на первом ходу, там слишком мало информации, а дальше, если играть аккуратно, проиграть уже невозможно.
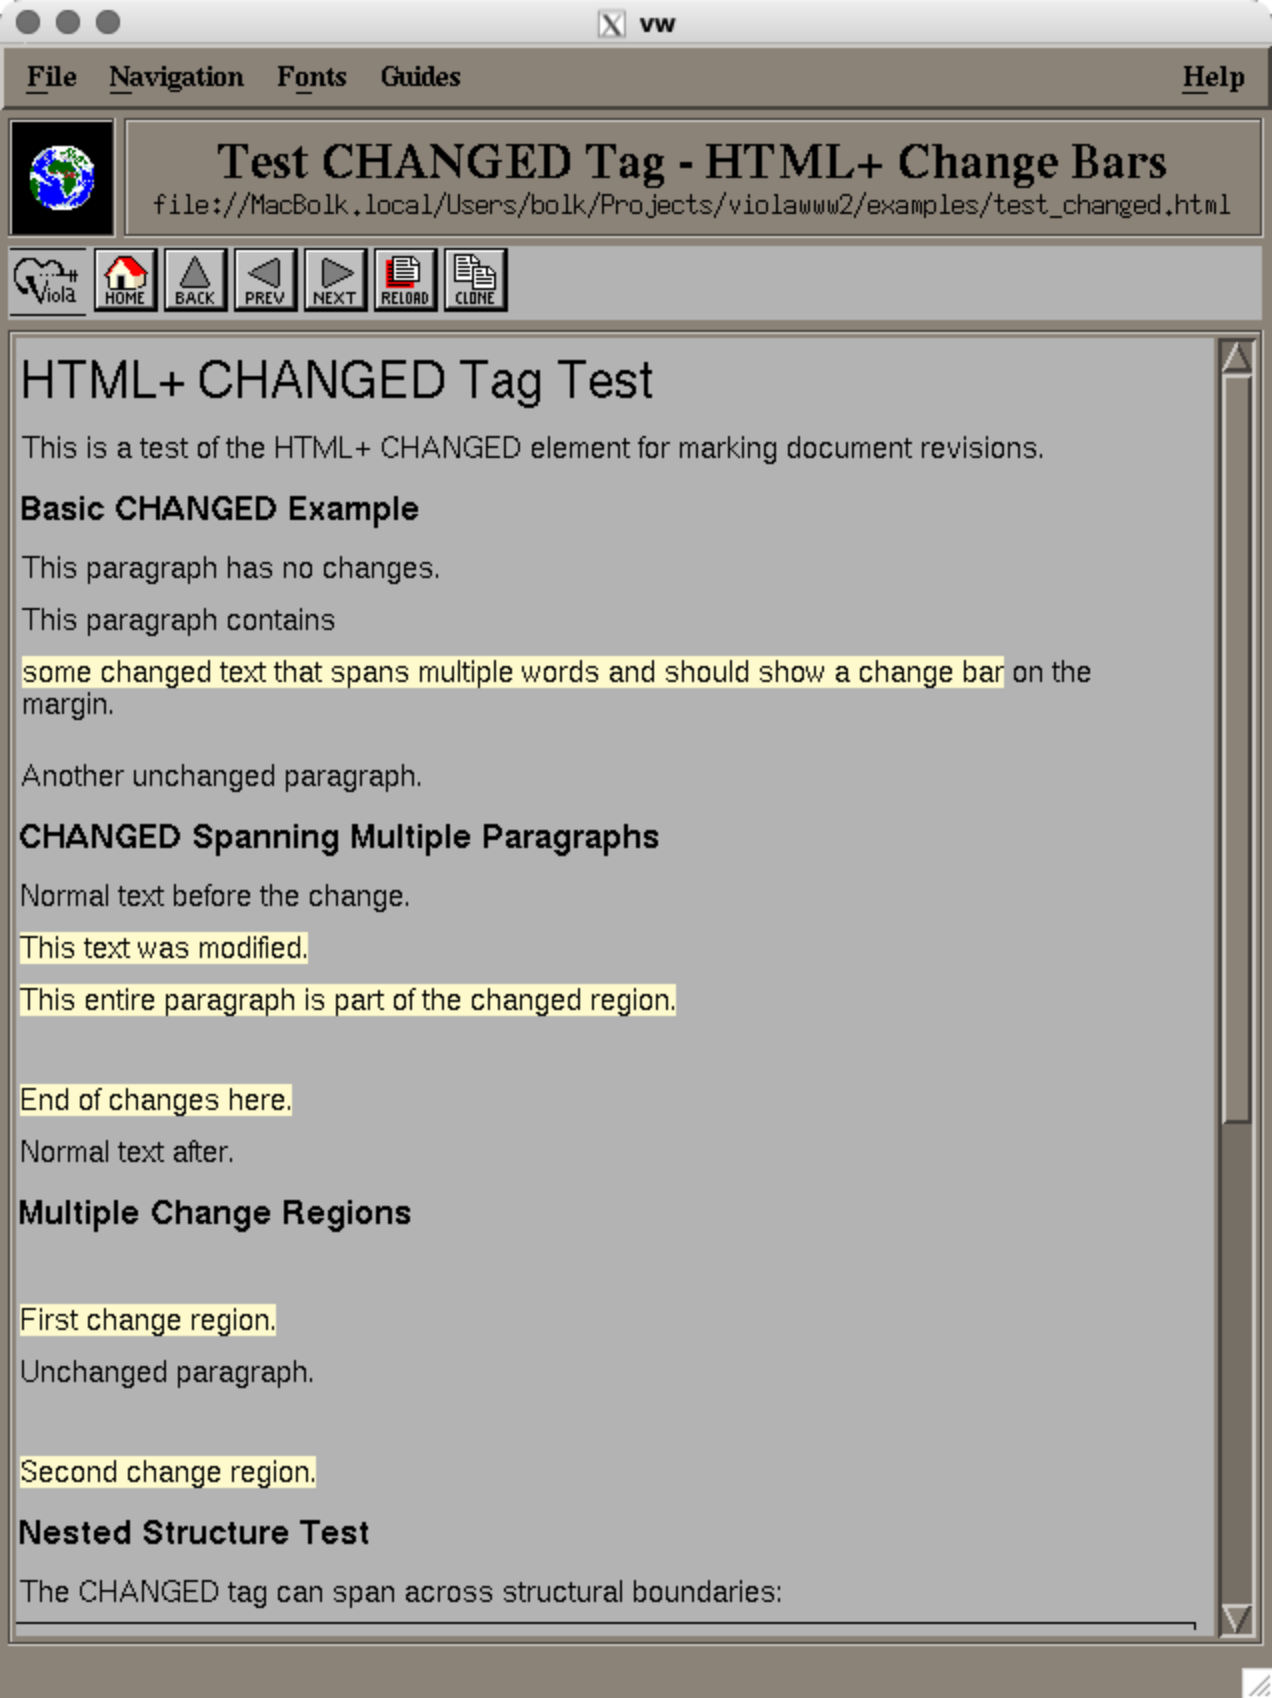
«Виола»: тег CHANGED
Если верить «Википедии», веб появился в 1989 году. Его ранний период очень плохо сохранился, даже проект
В «Виоле» я часто нахожу начатые и неоконченные части реализации
Так случилось и с тегом CHANGED. Я давно заметил его в коде, но не понимал как он должен работать. По коду про него было известно, что он должен был выделять часть текста оттенком жёлтого (точнее — цветом LemonChiffon1), имел два атрибута ID и IDREF и при этом был не блочным.
Конечно, мне было непонятно что у него за атрибуты, но последнее всё ещё сильнее усложняло. Когда я начал читать код, то подумал, что это
Тогда я решил, что это просто ошибка в коде и реализовал тег так как я его понимаю. Но было непонятно что делать с атрибутами, особенно с IDREF. По имени понятно, что это
Я записал себе в список дел
В архивах начала
Ни одна ссылка не работала, зато по имени htmlplus.dtd нашлось несколько уцелевших спецификаций, где, как я и надеялся, упоминался искомый тег с небольшим описанием:
<!-- change bars defined by a matched pair of CHANGED elements:

        <changed id=z34> changed text <changed idref=z34>

 This tag can't act as a container, since changes don't respect
 the nesting implied by paragraphs, headers, lists etc.
-->

<!ELEMENT CHANGED - O EMPTY>

<!ATTLIST CHANGED -- one of id and idref is always required --
    id      ID      #IMPLIED -- signals start of changes --
    idref   IDREF   #IMPLIED -- signals end of changes -->
Собственно, из этого кусочка всё стало ясно. Тег задуман таким образом, чтобы как бы «выпадать» из обычной логики вложенности тегов — так как выделение текста может пересекать границы других тегов.
Вместо открывающего и закрывающих тегов тут применяется тег с атрибутом ID для обозначения начала участка и тег с тем же значением в атрибуте IDREF для определения места, где участок заканчивается.
Этот тег не дожил до нашего времени, потому что его было предложено заменить на два других — ADDED и REMOVED, которые позже превратились в более привычные нам INS и DEL.
Несмотря на то, что найденная спецификация оказалась сложнее первоначальной моей реализации, в этот раз получилось всё запрограммировать даже быстрее, видимо при частом программировании с нейросетями нарабатываются
Один из таких способов, кстати, — банальное документирование. В процессе реставрации «Виолы», у меня набралось довольно много документации, благо при помощи нейросети это делать очень просто — даёшь команду что ещё учесть и она сама вписывает новые знания в подходящее место.
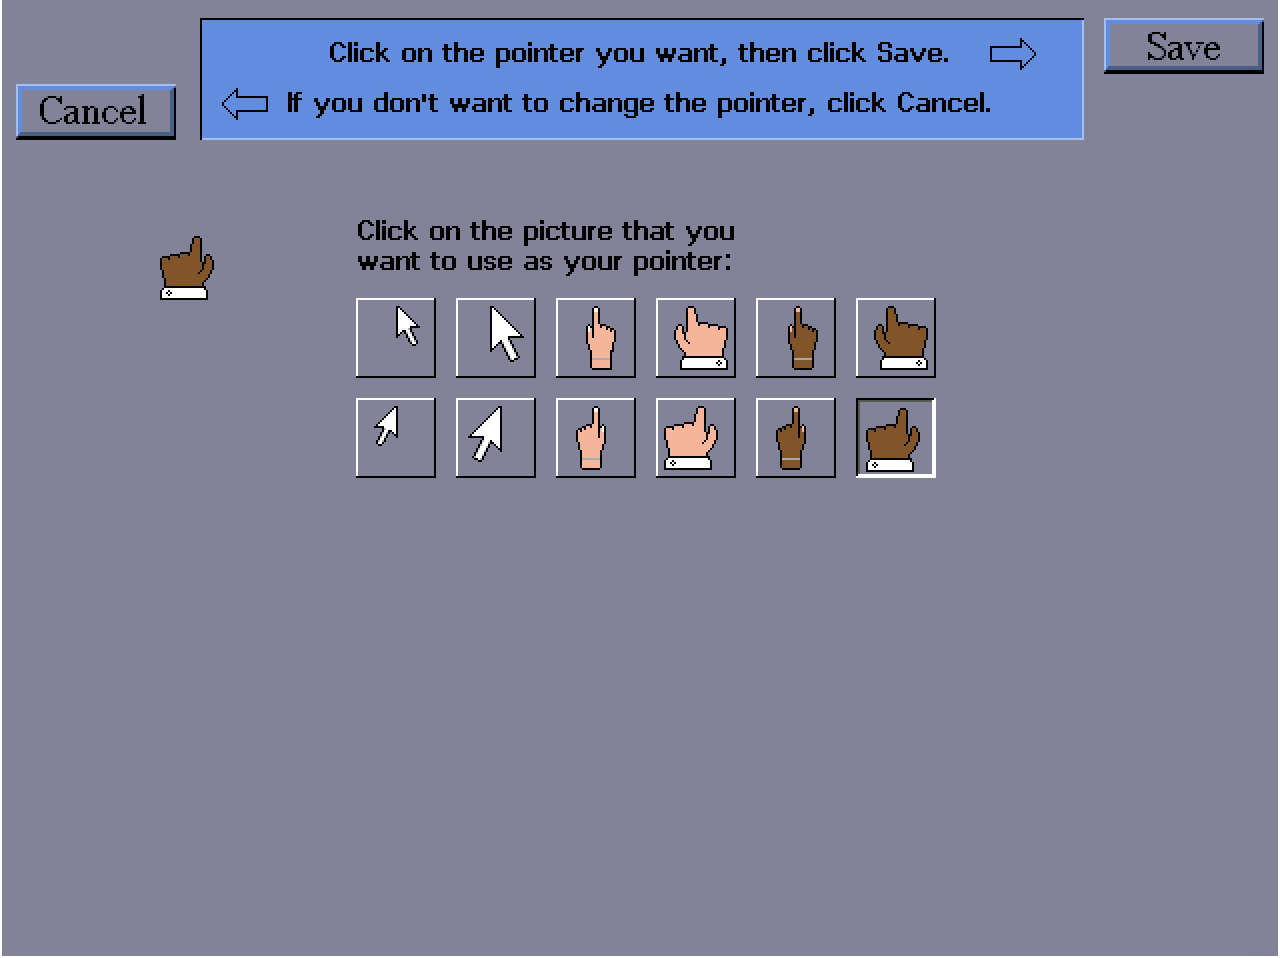
«Packard Bell Desktop»
В статье «Оболочки
Мне захотелось упомянуть про неё, потому что мне в ней понравился экран смены курсора мыши. Отдельные курсоры для двух цветов кожи (думаю, это исключительная инклюзивность для программы того времени), «женские» и «мужские» курсоры, курсоры для левши и правши!
Мне кажется удивительным, что
Отмена пуска
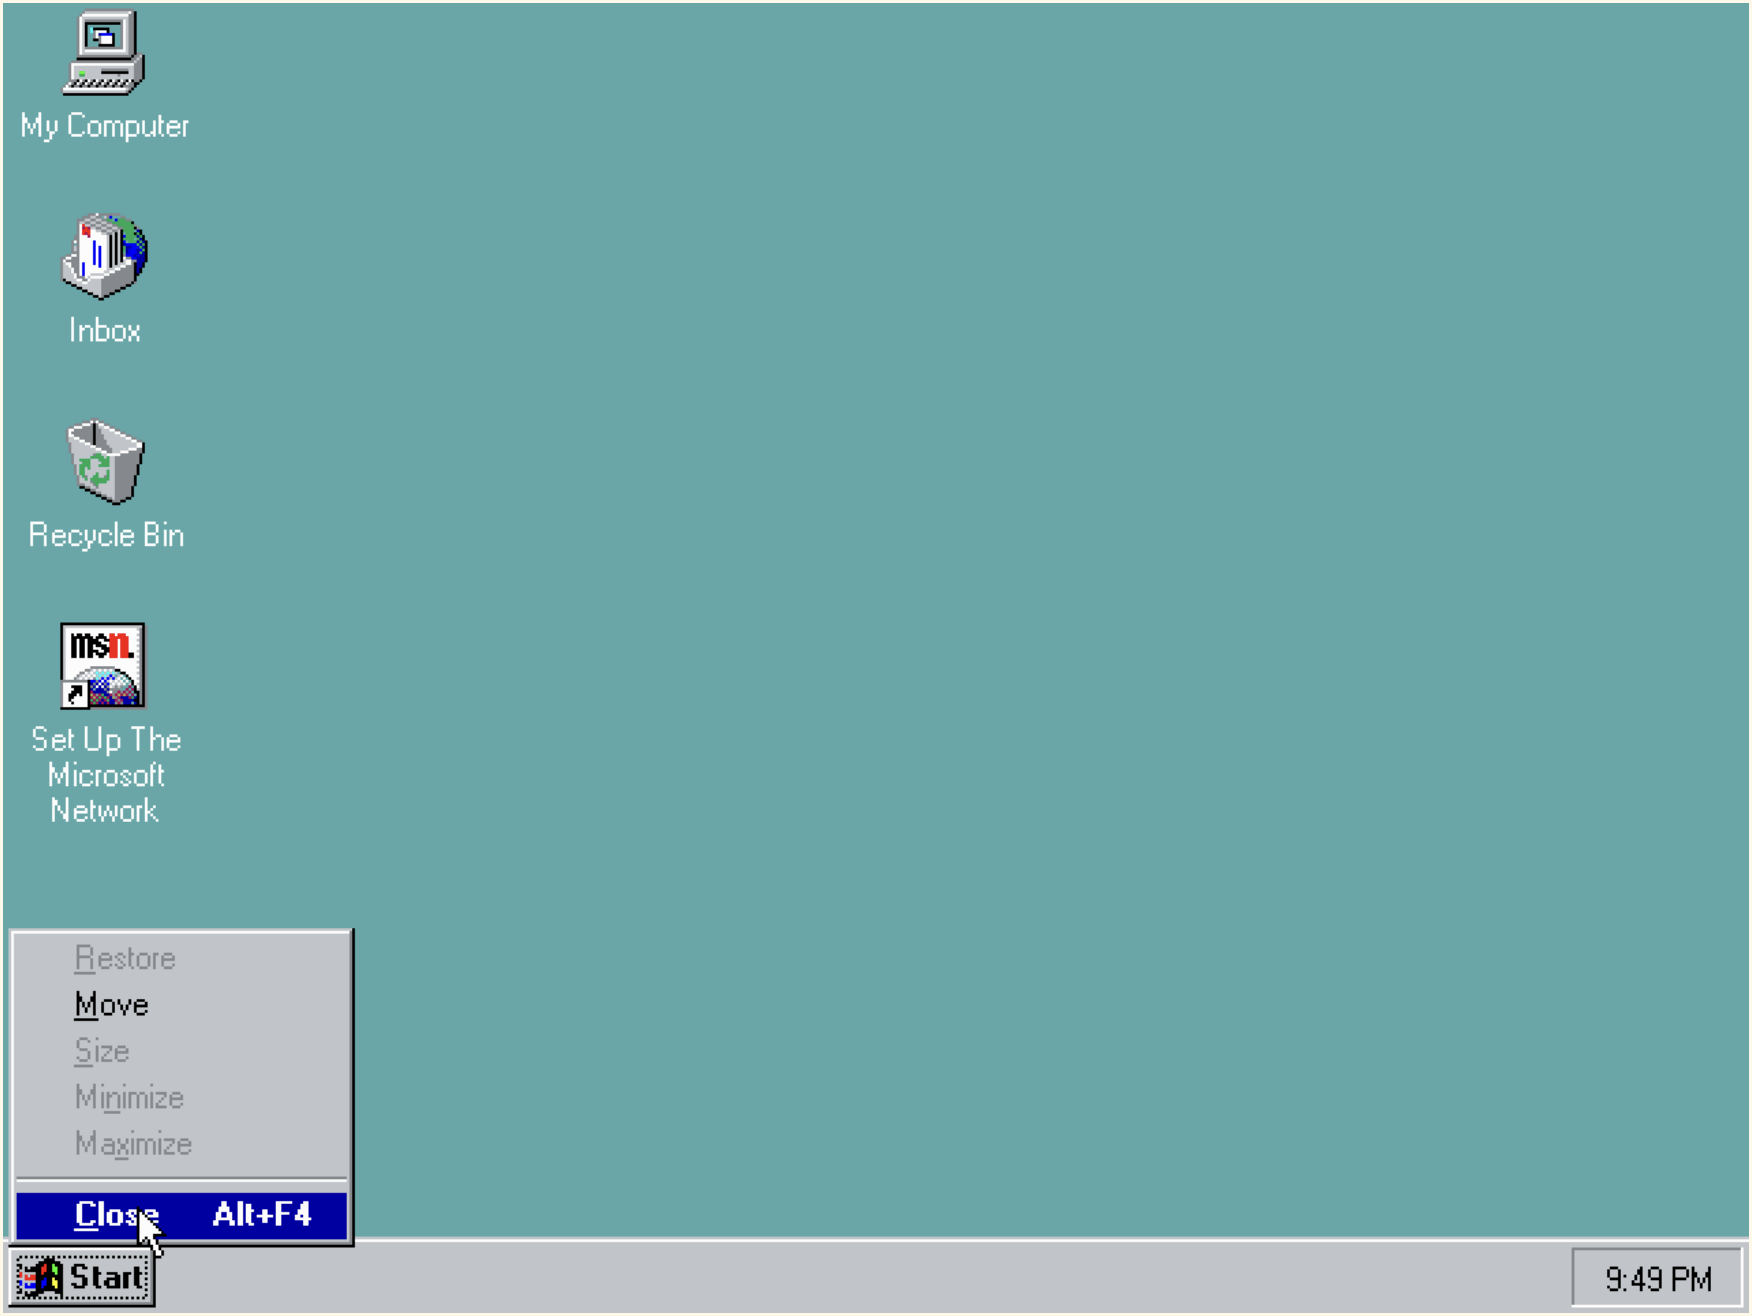
Недавно, в связи с обсуждением адекватности перевода кнопки «Start» → «Пуск» в «Виндоуз 95» в одном из телеграмных чатов, я вспомнил, что в ранних версиях этой системы был забавный баг — кнопку «Пуск» можно было убрать с экрана, закрыв как приложение.
Для этого надо было установить на ней фокус, нажать Alt+- и выбрать пункт «Закрыть». Мы в те годы иногда так подшучивали над друг другом или над студентами в компьютерных классах Университета, где я тогда лаборантил.
Кроме этого «Пуск» можно было ещё и двигать. Например, поставив её посередине панели задач. И это задолго до «Виндоуз 11»! Правда нормально это не работало — при запуске приложений «Пуск» пропадала за ними.
XBM vs. Брайль
Мне в комментариях к предыдущей заметке задали в вопрос — а насколько графика, представленная шрифтом Брайля, проигрывает по размеру формату XBM? Я прикинул, что должна даже выигрывать —
Давайте посмотрим
#define bullet_width 7
#define bullet_height 7
static char bullet_bits[] = {
   0x1c, 0x3e, 0x5f, 0x3f, 0x5d, 0x2a, 0x14};
Что мы тут видим? Почти восемьдесят байт служебной информации, форматирование, от которого, впрочем, можно избавиться и информация о пикселях. Причём пиксели задаются группами по восемь числом в шестнадцатеричном виде и каждое такое число занимает пять байт вместе с запятой.
В итоге размер файла можно примерно оценить на как 77 + 7×7/(8/5) ≈ 107 байт. В реальности чуть больше
Если же перевести эту картинку в шрифт Брайля, то всё получится куда компактнее. Каждый символ шрифта занимает три байта и кодирует сразу восемь точек (2×4), плюс надо учесть в расчётах переводы строк: ceil(7/4) × (ceil(7/2) × 3 + 1) = 26 байт.
А есть ли условия, при которых XBM был бы компактнее его представления в Брайле?
Логика подсказывает, что это должны быть
Я наугад выбрал разрешение 1×100 и угадал: 77 + 1×100/(8/5) ≈ 140 байт против ceil(1/4) × (ceil(100/2) × 3 + 1) = 151 байт.
Добавлено позднее: я не знаю как решить задачу нахождения этого порога аналитически, поэтому решил перебором, написав программу на языке R:
lhs <- \(w, h) ceiling(w/4) * (3 * ceiling(h/2) + 1)
rhs <- \(w, h) 77 + (5 * w * h) / 8

holds <- \(w, h) lhs(w, h) > rhs(w, h)

W <- 500
H <- 500

min_h <- \(w) { i <- which(holds(w, 1:H))[1]; if (is.na(i)) NULL else i }
min_w <- \(h) { i <- which(holds(1:W, h))[1]; if (is.na(i)) NULL else i }

for (w in 1:W) {
  if (is.null(h <- min_h(w))) break
  cat(sprintf("w = %d, h min = %d\n", w, h))
}

for (h in 1:H) {
  if (is.null(w <- min_w(h))) break
  cat(sprintf("h = %d, w min = %d\n", h, w))
}
Получились следующие значения:
w = 1, h min = 87
w = 2, h min = 299
h = 1, w min = 201
То есть картинки 1×87, 2×299 и 201×1 (бо́льшую сторону можно увеличивать, это увеличит разрыв) занимают в Брайле больше, чем в XBM. В реальности это не точные границы, так как внутри XBM указывается название картинки, которое может быть разного размера.
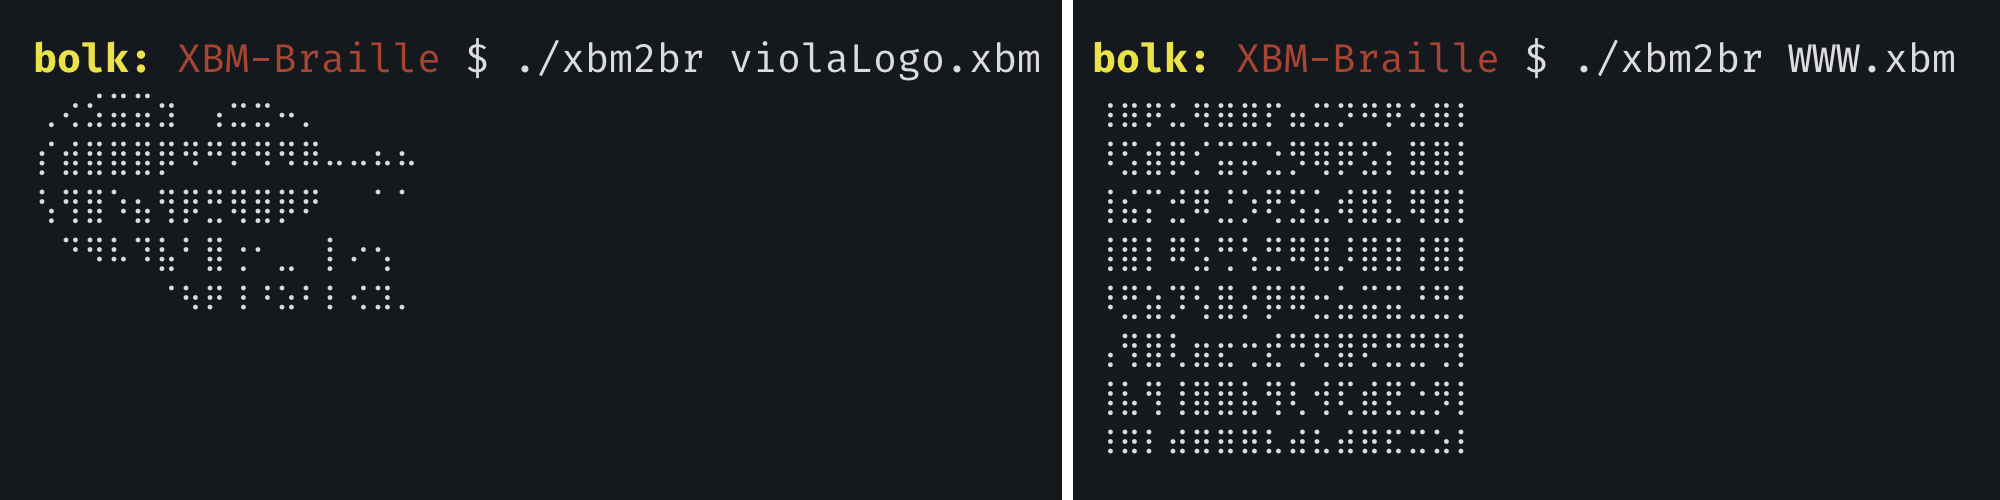
Рисование азбукой Брайля
Если помните, недавно я, вдохновлённый строчкой из песни «в каждой строчке — только точки», пытался выяснить что вообще можно записать точками, если использовать азбуку Морзе. Мне тогда один из комментаторов напомнил про шрифт Брайля — тактильный шрифт для слепых, состоящий из точек.
Он есть в Юникоде, поэтому на экране им можно написать что угодно и, как и требуется в песне, там будут только точки. Я тогда подумал, что «что угодно» можно трактовать и шире — если постараться, точками этого шрифта можно выводить в консоли любую графику.
Сегодня, как это
Шрифт Брайля бывает двух систем — шеститочечный и восьмиточечный. Для целей рисования удобнее брать восьмиточечный — между символами есть зазоры, как если бы это были обычные буквы, и нам выгоднее использовать более насыщенный точками элемент.
Таким образом у нас получается блок 2×4, где мы, подбирая код символа, можем получить любое сочетание точек. Я боялся, что в расположении точек нет никакой системы, но к моему счастью оказалось, что каждая точка, которую надо закодировать, отображается на конкретный бит численного представления нужного символа.
Оставалось только решить, что я, собственно, буду выводить. Это должно быть
Так, к примеру, выглядит картинка с логотипом «Виолы» в этом формате:
#define violaLogo_width 32
#define violaLogo_height 20
static char violaLogo_bits[] = {
   0xe0, 0x03, 0x00, 0x00, 0x18, 0x0c, 0x0f, 0x00, 0xe4, 0x8b, 0x30, 0x00,
   0xfa, 0x8f, 0x4f, 0x00, 0xfa, 0xff, 0xff, 0x00, 0xfd, 0xff, 0xff, 0x50,
   0xfd, 0x2f, 0xe9, 0xff, 0xfd, 0x07, 0x00, 0x00, 0x7d, 0xfc, 0xff, 0x50,
   0xbd, 0xfd, 0xff, 0x00, 0xba, 0x3b, 0x7f, 0x00, 0x3a, 0xdb, 0x1e, 0x00,
   0x7c, 0xd7, 0x00, 0x01, 0x78, 0xd6, 0x06, 0x19, 0xe0, 0xce, 0x00, 0x25,
   0x00, 0xcc, 0x32, 0x21, 0x00, 0xd8, 0x5a, 0x39, 0x00, 0xf0, 0x6a, 0x25,
   0x00, 0x60, 0x32, 0x79, 0x00, 0x00, 0x00, 0x00};
Алгоритм обещал получиться простым, поэтому для реализации я выбрал bash, тем более, что такую обработку там делать иногда даже проще, чем в большинстве других языков. Вот, например, вся функция чтения данных из файла картинки, получилось очень просто:
load_xbm() {
    local file="$1" hex h

    W=$(awk '/^#define.*_width/ {print $3;exit}' "$file")
    H=$(awk '/^#define.*_height/{print $3;exit}' "$file")
    BPR=$(( (W + 7) / 8 ))

    for h in $(sed -n '/{/,/}/{/{/d;s/}.*//;s/0x//g;y/,/ /;p;}' "$file"); do
        BYTES+=($[16#$h])
    done
}
Очень долго пришлось разбираться с битовыми сдвигами и порядком чтения точек из чисел, на это ушла просто прорва времени. Я пытался сделать это в уме, но не справился и перешёл на бумагу. Оказалось, что я не дошёл буквально полшага — надо было только изменить вывод точек на обратный.
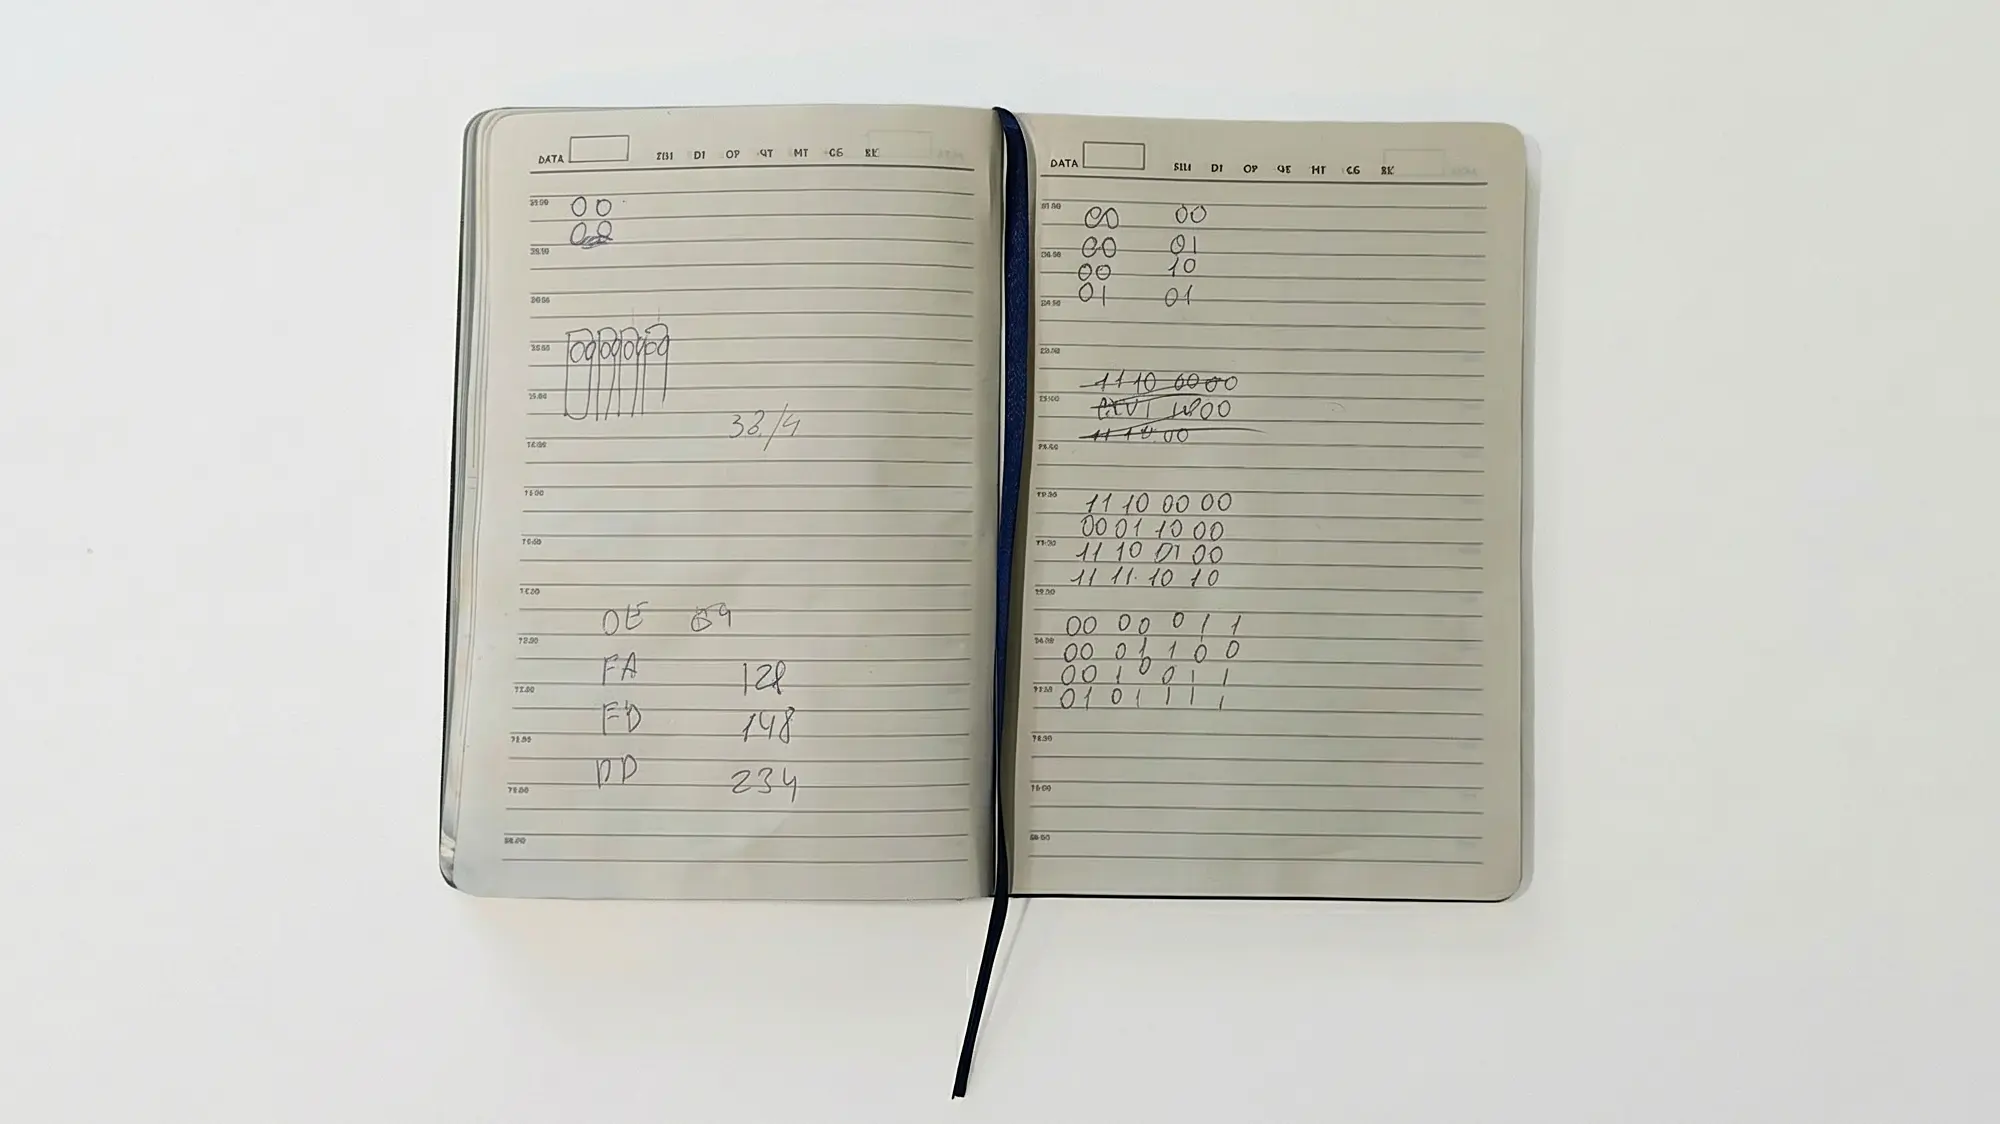
В итоге получился небольшой скрипт, в котором, если убрать все пустые строки, около полусотни строчек. Я его выложил, как водится, на «Гитхаб».
«Виола»: тянущееся окно
Отложил пока в сторону свой проект до дописыванию браузера «Виола», поскольку исчерпал все токены на своём тарифе в «Курсоре». Там, конечно, остались бесплатные модели («Грок», например), но они годятся только
Зато случилось интересное — поиск в интернете принёс видео «Viola www y Erwise dos de los navegadores web pioneros», где
В моём проекте с этим сложности — при изменении размеров окна, всё очень некрасиво едет и красится чёрным, видимо
Раз это не так, то после перерыва надо будет вернуться к этой задаче. Попытаюсь решить её с «Опусом 4.5», пока это умнейшая сеть для программирования.