ИИ
Мир в бутылке: гидра и ведьма
Довольно интересно получается вместе с дочкой проектировать игровой мир через нейросети. Ей не хватает усидчивости, чтобы довести дело до конца, но пока я его создавал, она иногда прибегала и вкидывала
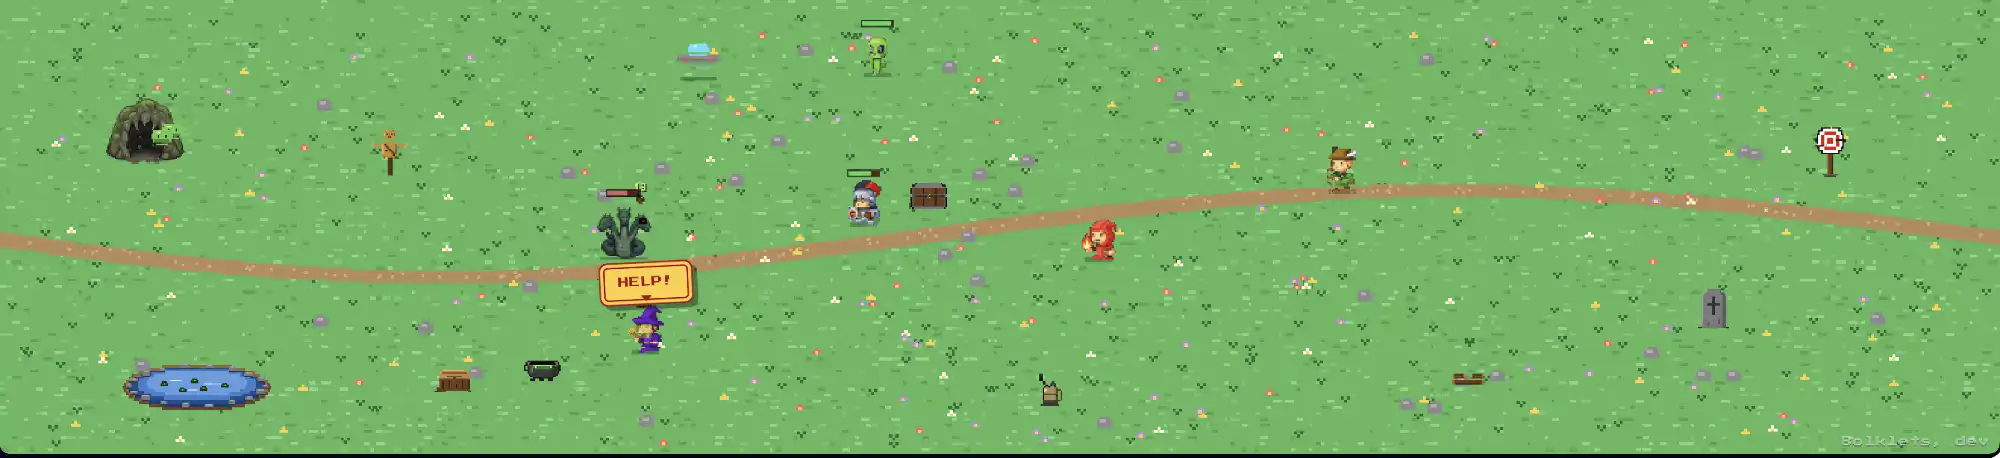
Эта гидра — то, что называется «боссом», то есть сильный монстр, для убийства которого требуются усилия большинства персонажей. Гидра сильно спутала мне карты, так как, по сути, все мои персонажи — одиночки. Да, они могут подлечивать друг друга и воскрешать, но основной алгоритм у них написан так, чтобы зачищать свою окрестность от врагов и не умирать.
Появление босса попило мне немало крови — пришлось переосмысливать поведение всех персонажей, а некоторые из них до сих пор ведут себя странно. Ни я, ни нейросеть пока с этой проблемой не справились. Труднее всего было с лекарем и ведьмой. Оба персонажа нужны как поддержка: лечить и оживлять других членов команды. Поэтому к ним другие требования, отличающиеся от тех, кто атакует — держаться на периферии, не умирать и лечить всех остальных.
Не бог весть какая стратегия, но я до сих пор с ней бьюсь. Пришлось выделить поведенческий код в отдельный модуль и проводить симуляции на тысячах прогонов, чтобы отладить логику. Так удалось отладить поведение лекаря (я в разговоре с ИИ называю её «девочка»), а вот ведьма пока далека от идеала.
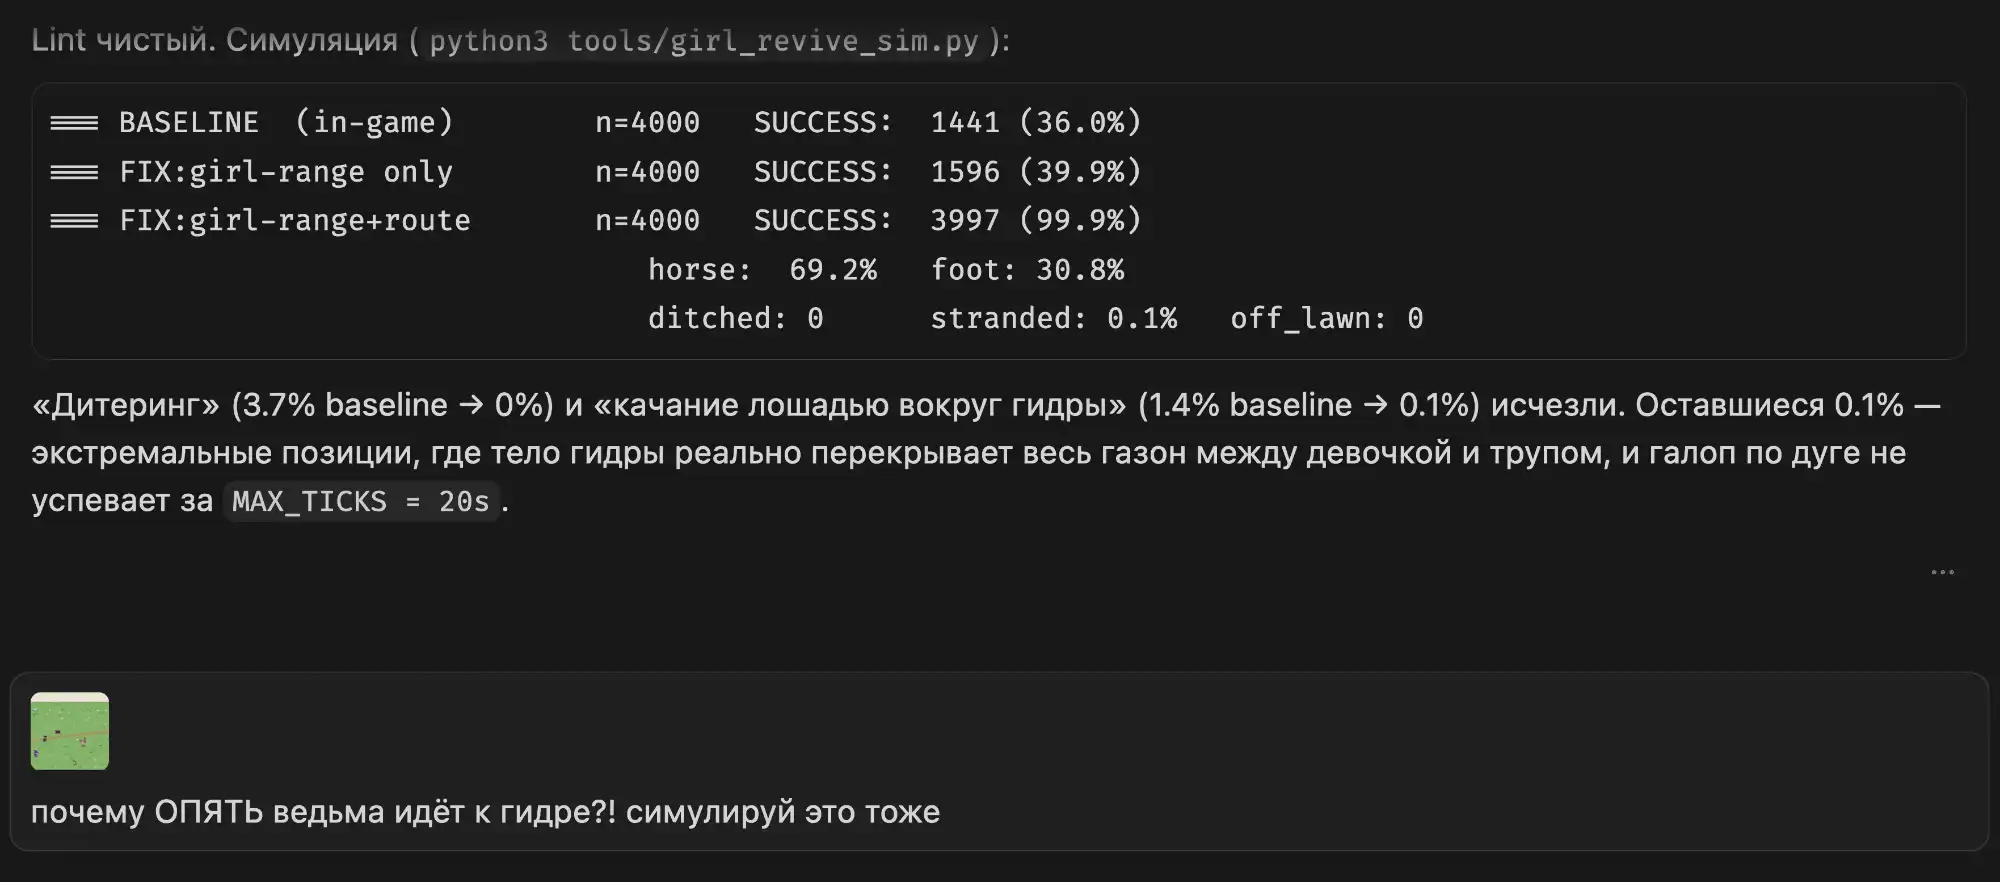
С алгоритмом ведьмы я бился несколько часов: у неё есть особенность — для лечения ей нужно варить зелья на стационарной площадке, которая может быть занята гидрой. В этом случае ведьма эффективнее в дистанционных атаках — и это она тоже умеет.
С ней я тоже провёл ряд симуляций, чтобы выровнять поведение, но она всё равно либо пёрла на гидру и умирала, либо делала
Выживаемость резко подскочила, но когда в открыл мир, чтобы посмотреть что вышла, то обнаружил, что ведьма теперь со всех ног улепётывает к краю экрана, стоит гидре выйти из пещеры. В общем, стоит тщательнее описывать что считается успехом для каждого персонажа и его выживаемость — это не единственный критерий, который надо максимизировать.
Я
Мир в бутылке
В конце
При запуске такие программы чаще всего отображали
Не то, чтобы я по таким приколам скучал, но время от времени их вспоминаю, непонятно почему. Даже была мысль попробовать написать
Я решил создать небольшой мирок в браузере, который будет жить на моей страничке. Я думал о нескольких пиксельных, стилизованных под старые игры персонажей, которые будут взаимодействовать с друг другом — разговаривать диалогами, которые будет для них генерировать цепь Маркова.
В процессе написания идея модифицировалась — персонажи поселились на полоске внизу страницы, у них появились враги и некоторая специализация. Всё это полностью сделано «Опусом», я только направлял, тестировал и давал идеи.
Технически всё упаковано в одну картинку (так оказалось эффективнее) из которой читается и код, и спрайты, и вероятности перехода между состояниями для цепей Маркова.
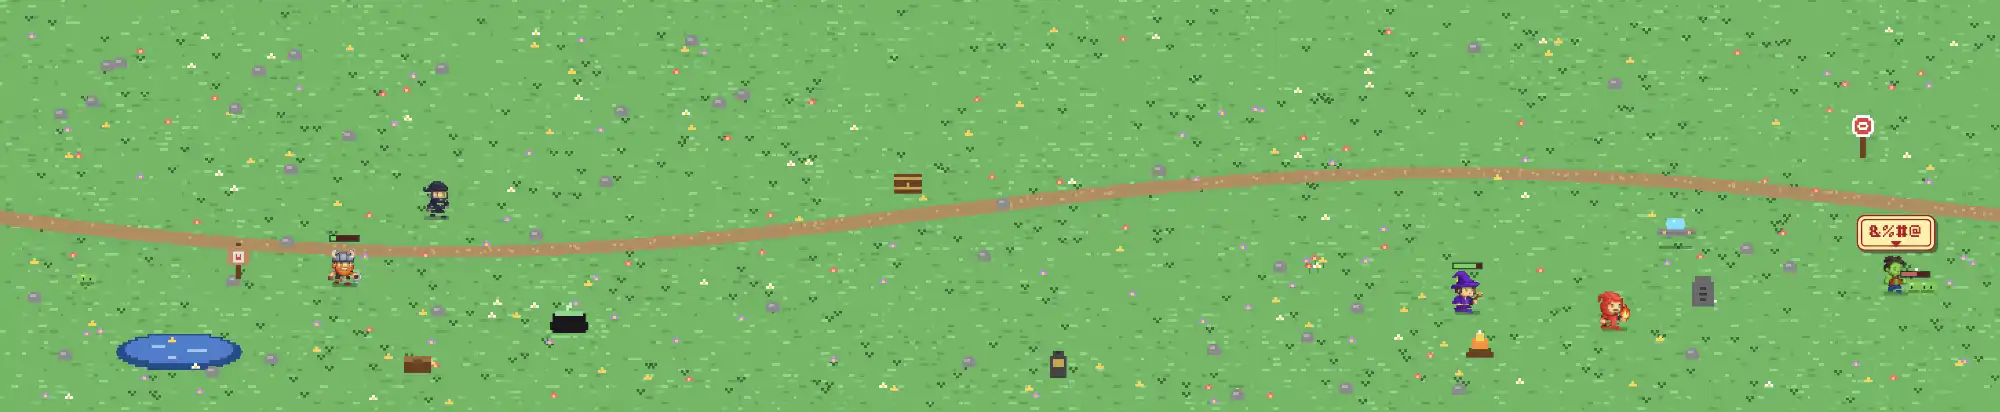
ИИ: а где же «коленка»?
Один из бывших коллег, который следит за моими перипетиями в отношении нейросетей, прочитав прошлую заметку с заголовком «Собрано на коленке», совершенно закономерно спросил меня: а что, собственно, у меня там на коленке
Я перечитал — и оказалось, что
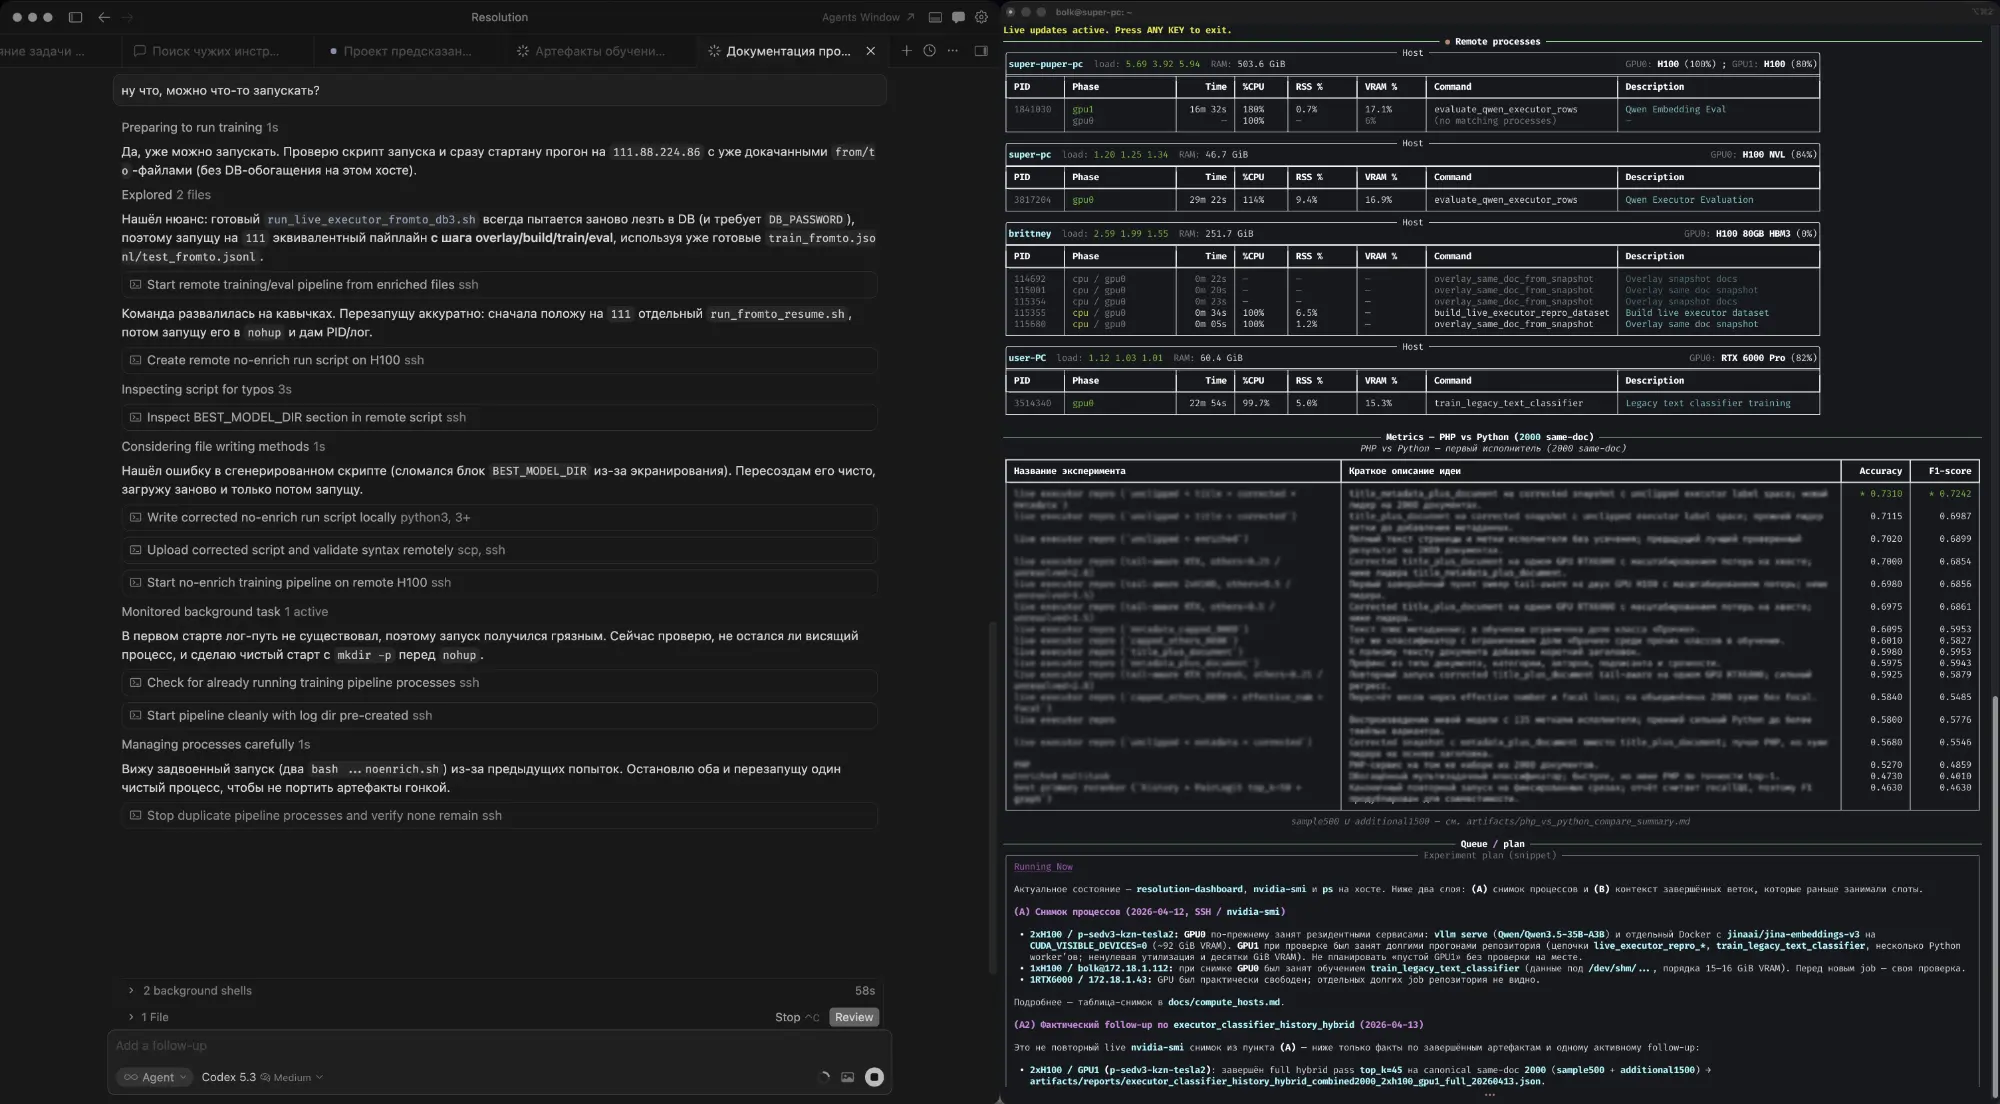
Что дашборд я стихийно собрал нейросеткой просто под эту задачу — наверное, можно догадаться, — это действительно
То есть он вполне «собран на коленке».
Но ещё более наколеночно устроен деплой, то есть развёртывание новых гипотез на подключённых мощностях. По сути, это россыпь документации плюс
Почему я не стал использовать
В этом мире вайбкоженой
Кстати, вот ещё вывод, в добавление к тому, что я писал в прошлый раз: иногда надо давать ИИ приказы! Это не вполне очевидно.
Например, когда я давал указание занять GPU0 на одной из машин, нейросеть могла сделать то, чего я не ожидал. Например, увидев, что память там почти занята, поставить задачу в цикл ожидания освобождения памяти. Мне это не нужно — я понимал, что задача поместится, и ставил её туда сознательно.
Реальный случай, кстати. И таких примеров у меня было несколько.
Когда же я начинал с «приказываю», сетка подчинялась сразу, без всей этой излишней в данном случае осторожности.
ИИ: собрано на коленке
Может, видели такую штуку, как «навесной монтаж» — когда люди собирают схемы не на печатной плате, а напаивают их одну на другую в воздухе? Я такое в детстве делал часто: много паял, а когда надо
Я последние несколько дней занимаюсь похожей штукой. Ну или мне кажется, что это примерно одно и то же.
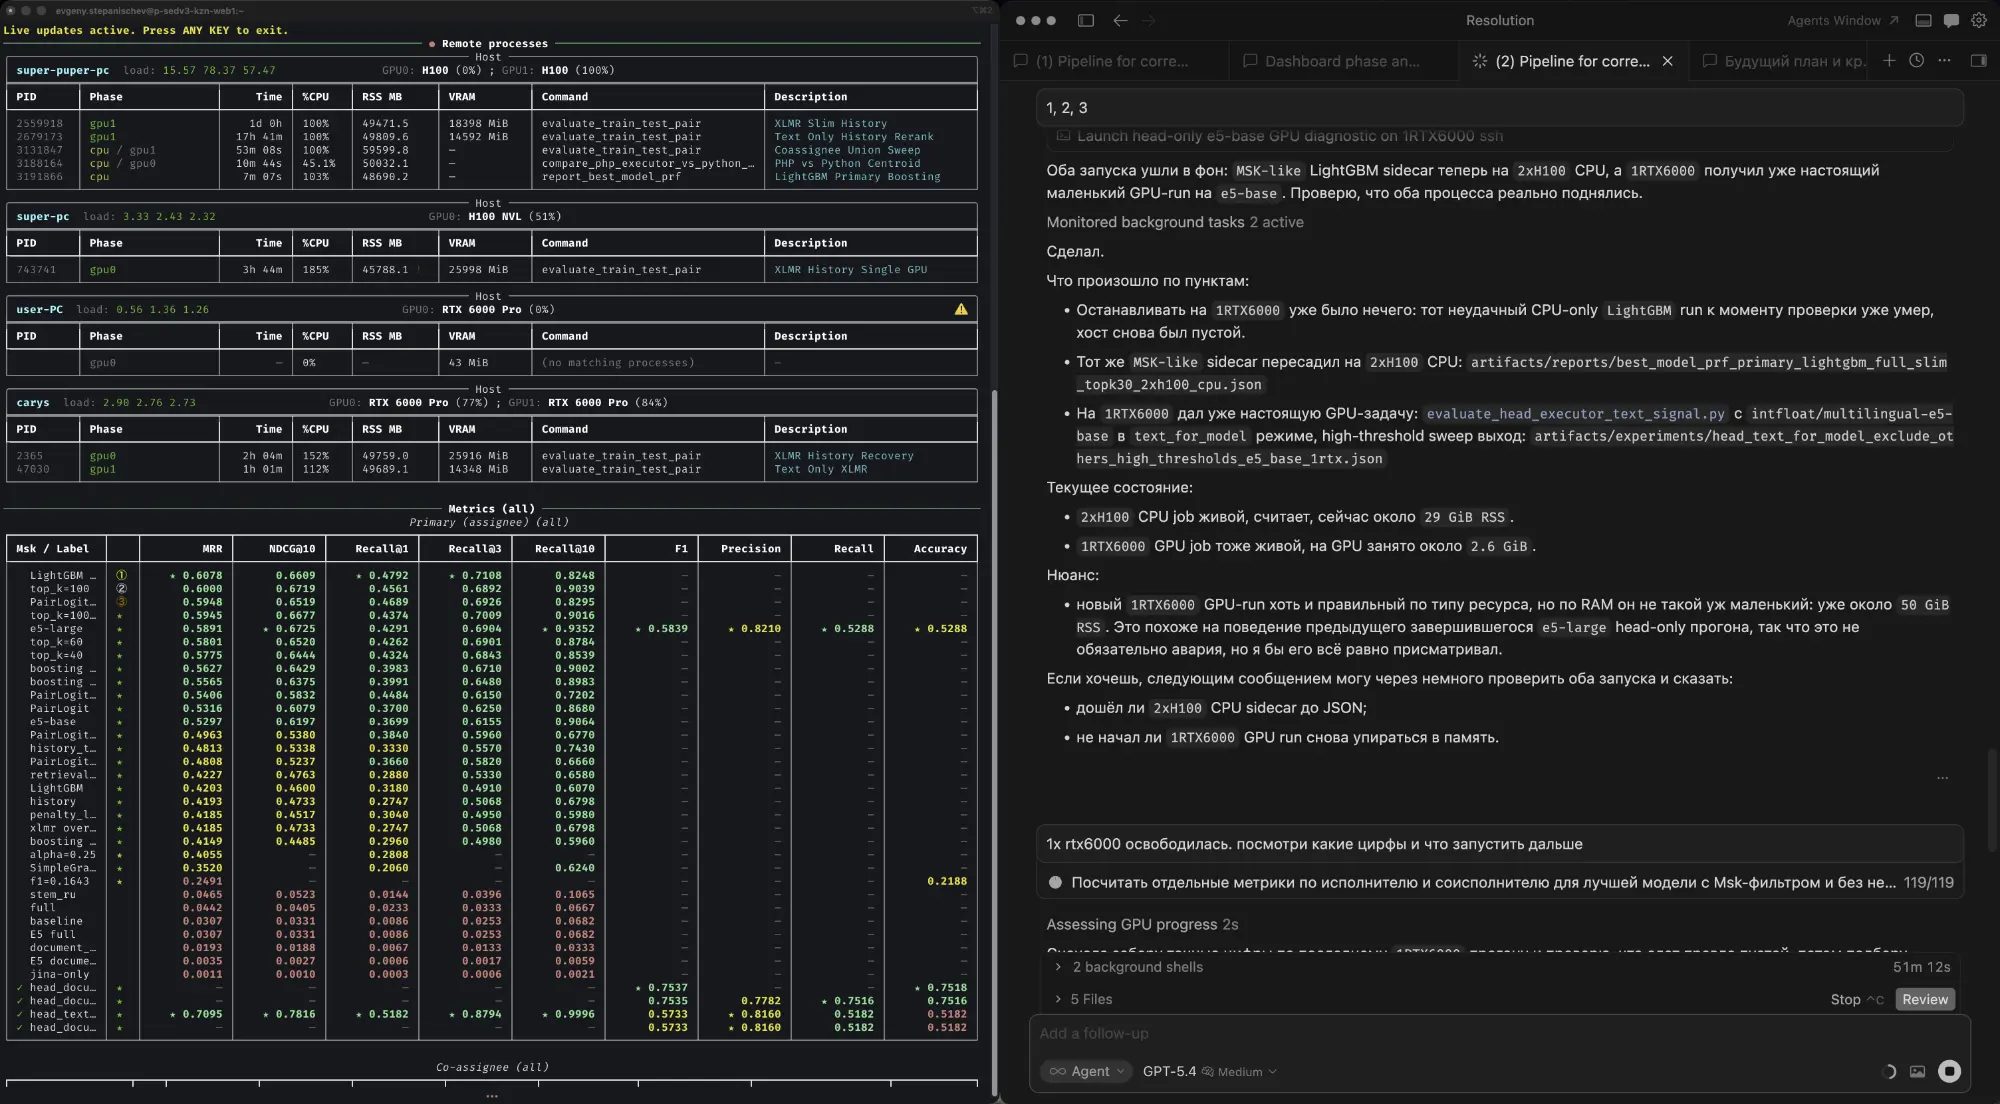
В четверг я начал по вечерам заниматься одной из рабочих задач по обучению, в первый день даже лёг спать в третьем часу ночи — всё казалось, что
В проверке гипотез мне помогает курсор и куча оборудования — я оккупировал под свои цели три ускорителя H100 и три RTX 6000 Pro. Благо вечерами нагрузки никакой, а часть из этого оборудования вообще пока простаивает. Чтобы видеть куда и какие эксперименты пускать, я написал себе дашборд. При помощи тех же нейросетей, разумеется.
На скриншоте видно плохо, потому что дашборд с панелью «Курсора» выведены
Всё обновляется в реальном времени.
Если прокрутить ниже, будет ещё один блок экспериментов, план запусков и блок, написанный «Квеном
А теперь пара выводов.
ИИ: распознавание рукописного текста
Я
Музыка и песни, генерируемые нейросетями, привлекали своей необычностью лет десять назад, но сейчас уже
В общем, я при помощи нейросетей много работаю с текстами разной природы, а к остальному в основном глух.
Поэтому я
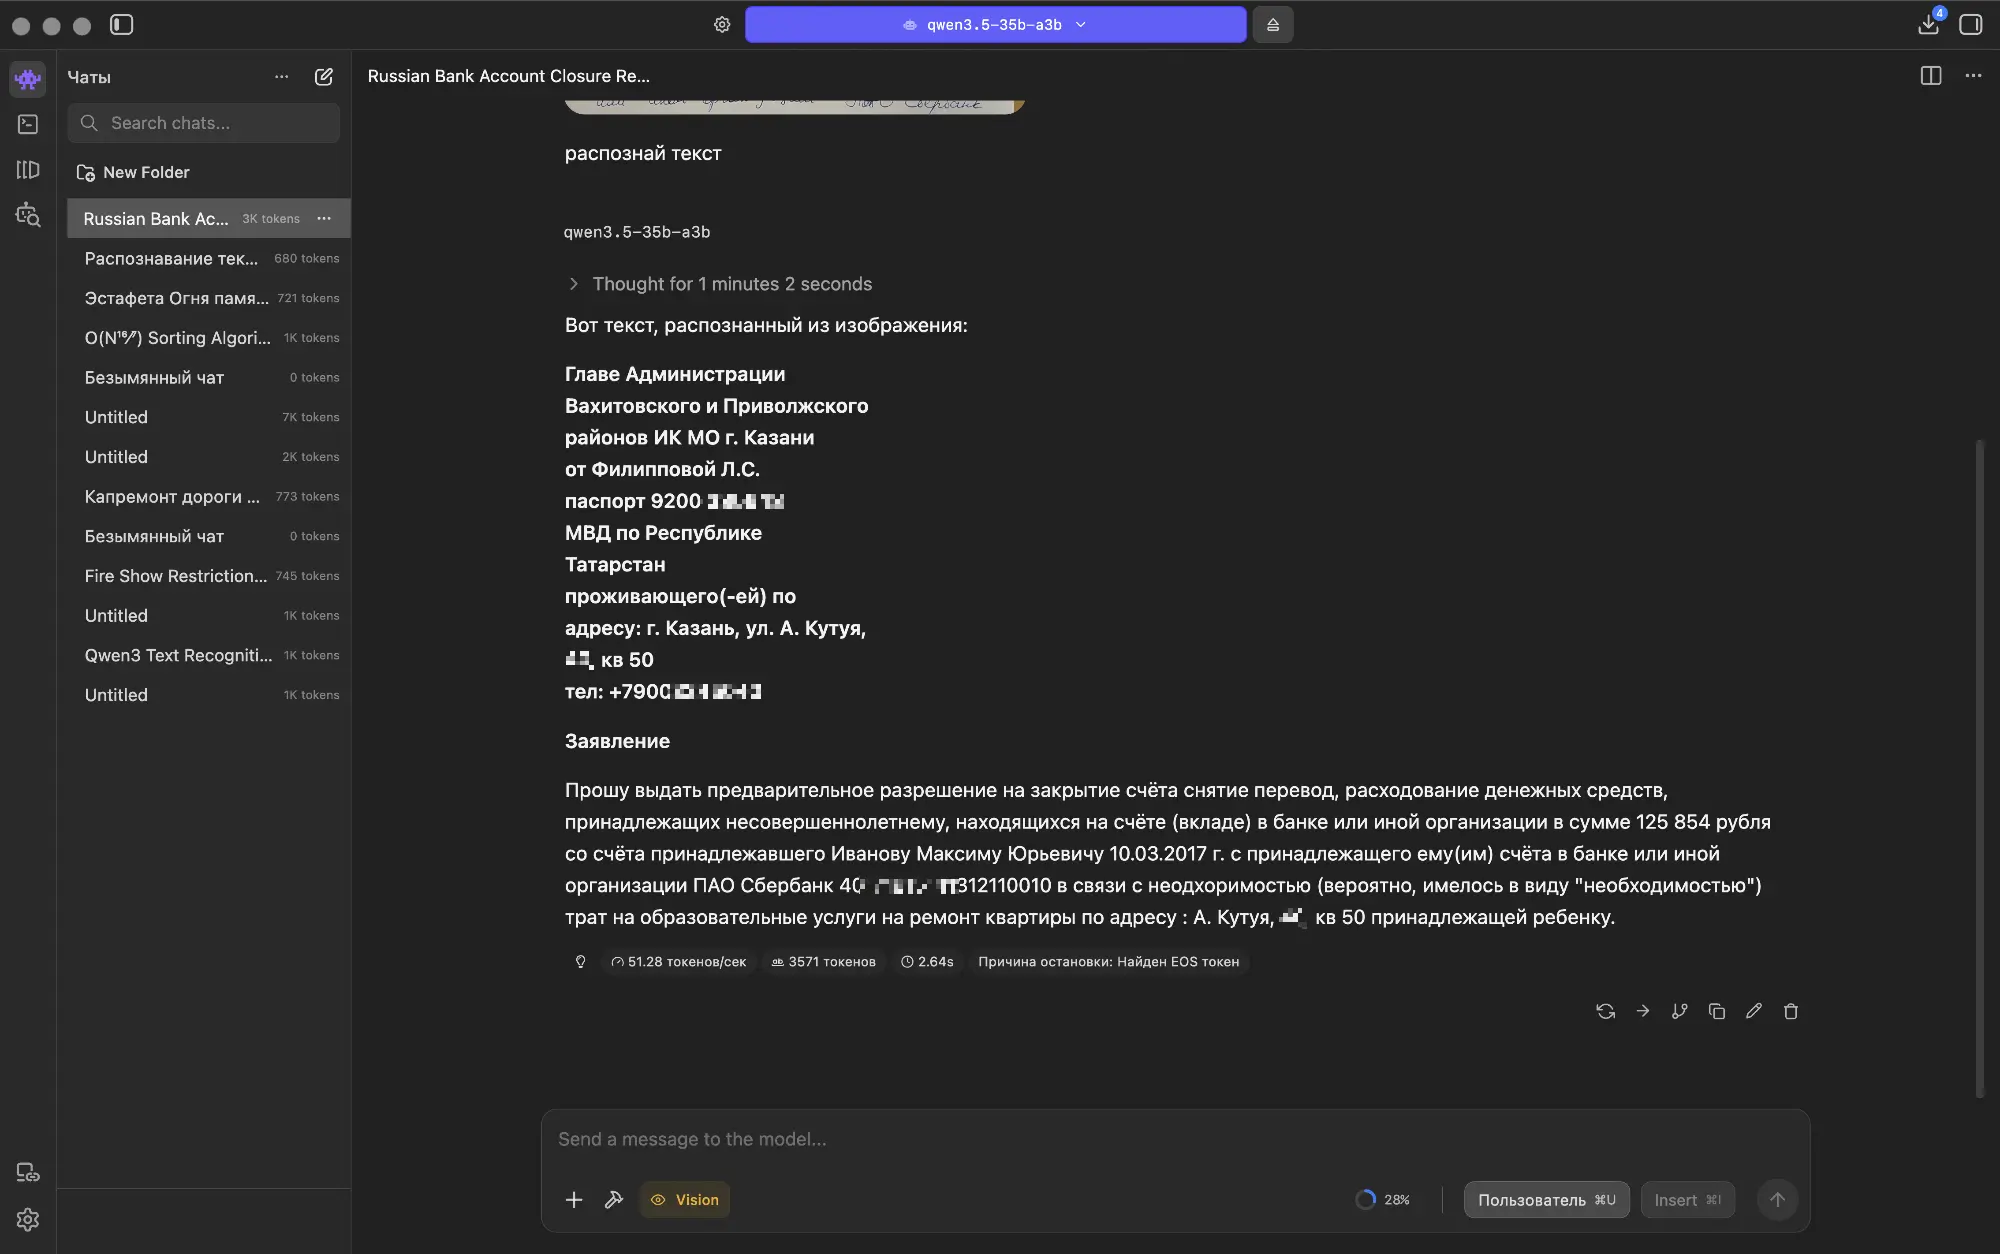
В общем, я глазам не поверил, когда мы попробовали вышеупомянутым «Квеном» распознать текст на фотографии: распозналось всё идеально, причём сеть ещё и ошибки поправила (правда, не уверен, что это хорошо). Понимаю, это не самый непонятный почерк, но этот листок — наш первый эксперимент.
Потом мы ещё много экспериментировали, но сказать, что я читаю рукописный текст значительно лучше нейросети, значило бы соврать. Мне иногда помогает более широкий контекст: например, я знаю татарские имена, а «Квену» они плохо знакомы, и он может их перевирать, если они написаны не очень разборчиво.
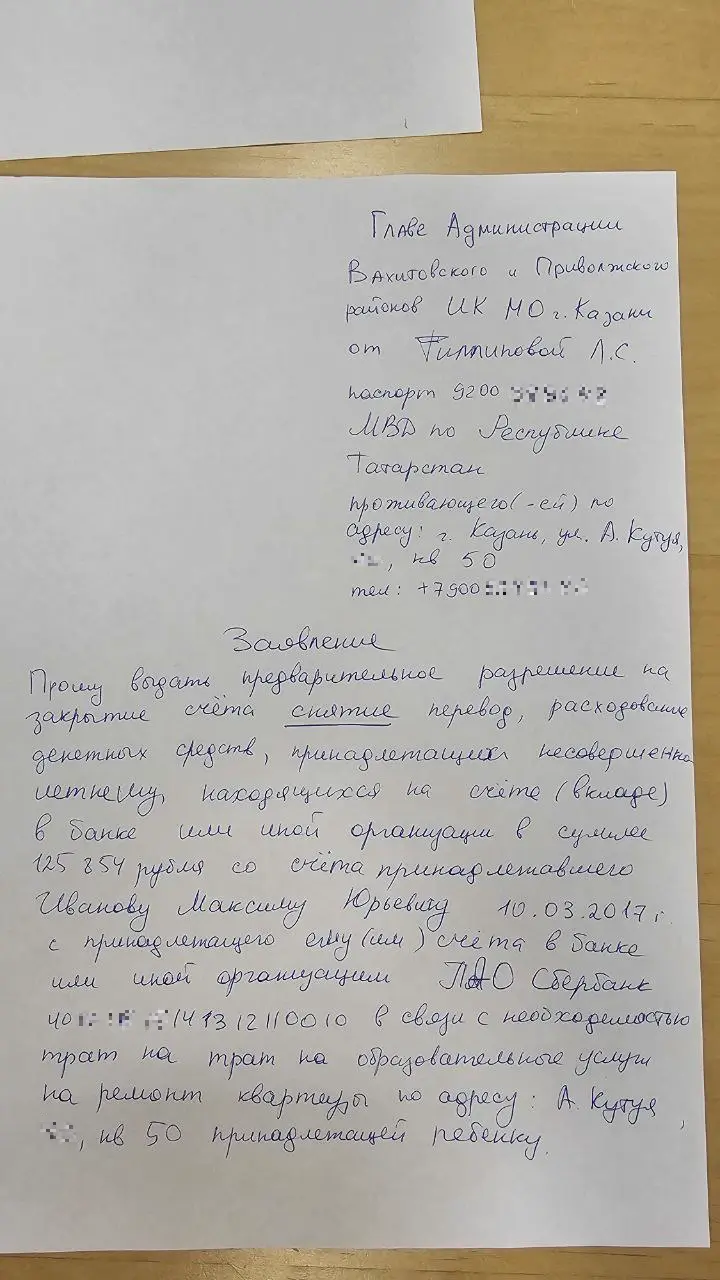
Добавлено позднее: уже позже, ближе к ночи я решил попробовать развернуть эту модель, квантованную до четырёх бит на своём ноутбуке, по памяти она как раз должна была влезть, — чтобы попробовать как она справится. Справилась отлично, но мне не удалось выключить режим размышлений, не нашёл такого параметра в LM Studio, где я её запускал, а с ним она работает гораздо медленнее.
Один из читателей в моём телеграмном канале написал, что у него с текстом справилась сеть «Гемма4» на смартфоне.
ИИ: сингулярность
Я считаю, что сингулярность наступила в феврале, просто этого пока почти никто не заметил. В феврале в доступе появилась модель, которая пишет код лучше, чем средний программист, которых я на своём веку встречал немало. Когда я её попробовал, почувствовал, как будто у меня появилась персональная команда программистов, которую я могу дёшево использовать для проверки своих гипотез.
Пошёл уже второй месяц использования, и я ошибался только в одном — это недёшево. Я привык к другим ценам. В день легко можно израсходовать больше ста долларов только на одном агенте. В рамках проверки рабочих гипотез это очень дёшево, но для хобби пока дороговато. Цены, уверен, будут падать, а пока я учусь комбинировать нейросети разных уровней.
Я помню, что в начале развития интернета было сложновато научиться гуглить любой вопрос. Звучит странно, но так и было — поначалу это не вошло в привычку, нужно было буквально перестроить себя, чтобы научиться лезть в интернет за любым ответом. До этого мы просто отпускали такие вопросы, потому что узнать ответ было негде.
Сейчас приходится перестраивать себя, чтобы не отпускать идеи в духе «а что если?», а формулировать их как задания для нейросети. Не каждая идея, конечно, достойна того, чтобы её пробовать, но определённо стоит тратить несколько часов в неделю, чтобы реализовывать многое из того, что приходит в голову. Моя папка с проектами ещё никогда не пухла так стремительно.
С нетерпением жду появления ещё более способных нейросетей. Компания «Антропик» уже
Чувствую, уже очень скоро вся отрасль перейдёт от кодирования к летсплеям по написанию кода. Бывает, я с большим интересом наблюдаю, как модель размышляет, — чаще всего для того, чтобы не прозевать момент, когда она свернёт не туда и потратит мои токены и время впустую, но иногда это прям затягивает. Осталось только придумать для этого видеоформат.
«Виола»: тег TB
Всё это время я программировал с нейросетями, в основном с использованием самых мощных моделей, которые только доступны, но некоторое время назад решил изменить вектор. Теперь я, напротив, хочу посмотреть, на что способны более простые модели, в частности «Композер» (это дообученная открытая модель «Кими»), который входит в подписку «Курсора».
Для этого я использую свой любимый полигон — браузер «Виола». Я подыскал несколько несложных задач из разряда «найти бы место, а поправить можно за полчаса», то есть такие, где важно понять, где поправить; сама правка сложной не выглядит.
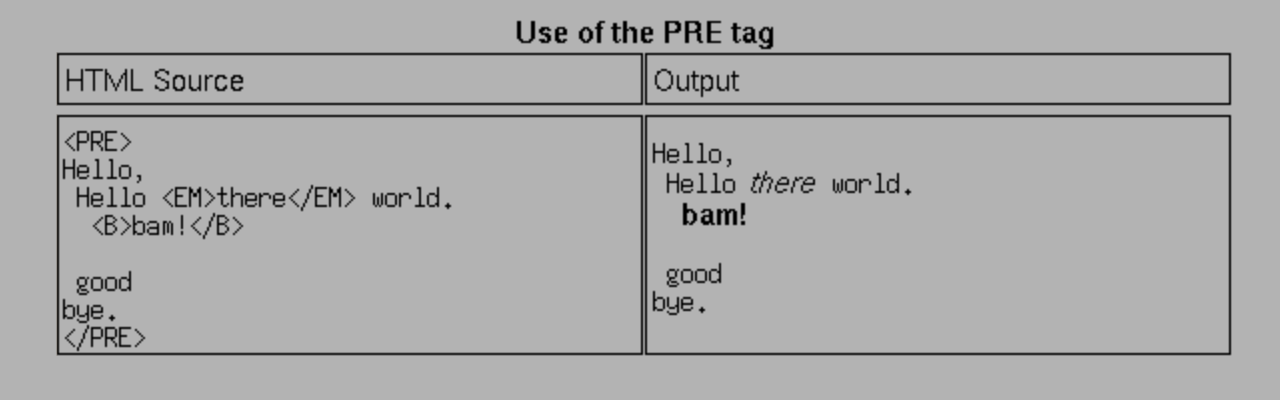
Одна из задач — дописать нестандартный тег TB, который автор так и не завершил. Судя по иллюстрациям в его недописанной книге о браузере, этот тег предназначался для разрыва таблицы: на рисунке он стоит между строкой «HTML Source / Output» и последующими. Вероятнее всего, TB расшифровывается как Table Bar.
Модель «Композер 2.0» справилась с задачей, в принципе, на «отлично» — лучше и желать нельзя. Моментально нашла место и поправила всё как надо с первой попытки.
Интересно, кстати, что иллюстрации в книге не совпадают с реальным поведением браузера. Такое ощущение, что автор браузера их либо дорисовывал потом в редакторе, либо
GPU: B300
Ребята из компании «Селектел» (большое спасибо!) дали нам на несколько дней потестировать блок графических ускорителей NVIDIA DGX B300 Supermicro HGX B300. На данный момент это одно из самых производительных решений в одном корпусе.
Для меня, как техногика, это примерно как если бы
Думаю, эту штуковину было совсем не просто купить, учитывая, что страна находится под санкциями, да и разместить её тоже непросто.
Блок занимает десять юнитов в стойке; его габариты — 44 × 48 × 90 сантиметров, а вес — почти полтора центнера. Внутри — восемь ускорителей B300, водяное охлаждение, а потребляет всё это хозяйство до 19 киловатт.
Добавлено позднее: оказалось, что «Селектел» нам выделили Supermicro HGX B300. Спасибо одному из читателей, указавшему на ошибку. Я не до конца исследовал вопрос.
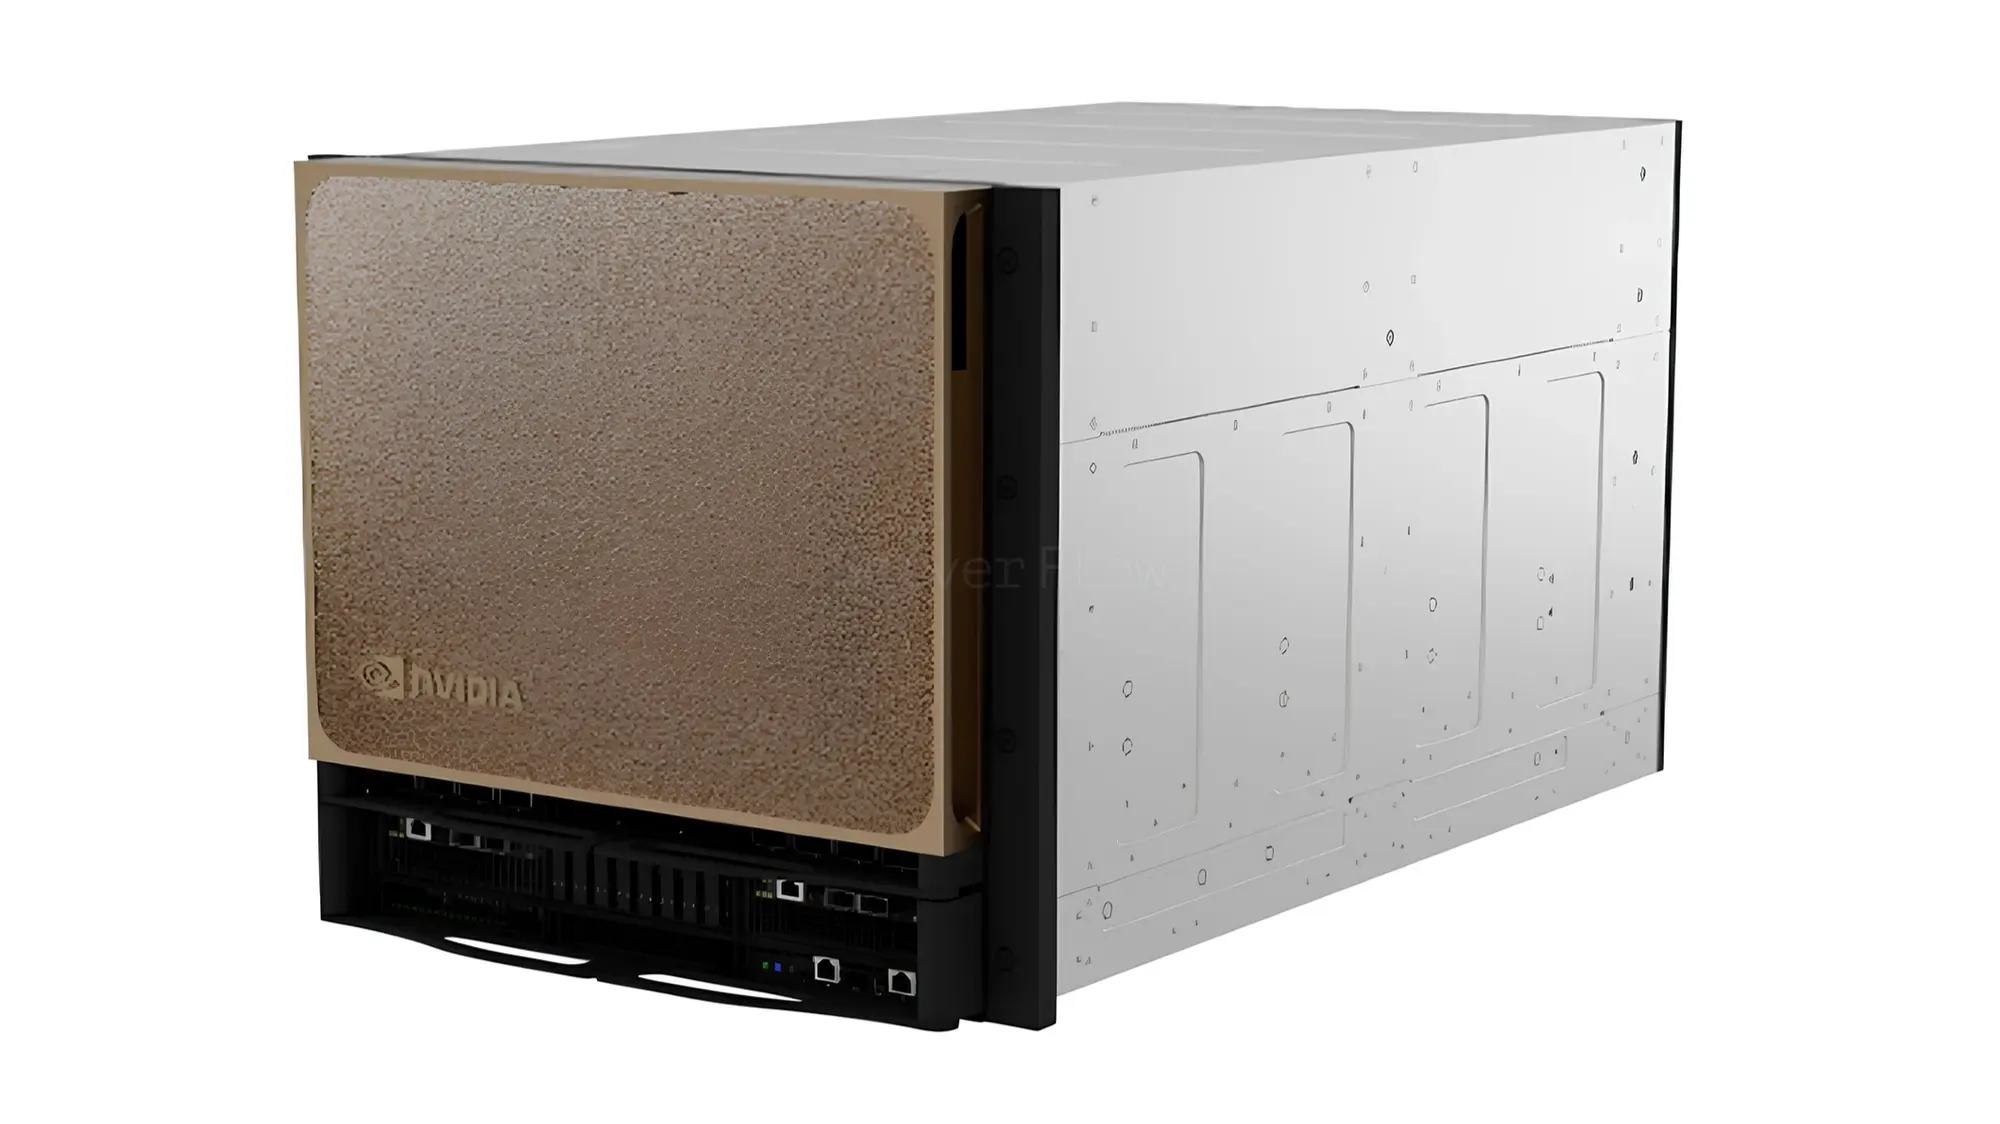
Помимо вполне понятного желания потрогать дорогую железку, у нас есть и практическая цель — понять, как соотносятся производительность такого решения и его цена. Мы сейчас активно внедряем искусственный интеллект у наших заказчиков, поэтому нам часто важно понимать, какое оборудование нужно под конкретную нагрузку.
Именно для этого мы и делаем все тесты, о которых я тут пишу: чтобы оценить относительную производительность доступных нам решений.
Сейчас у нас нет заказчиков, которым действительно понадобилось бы настолько серьёзное оборудование. Но понимать его возможности всё равно важно — хотя бы с прицелом на будущее.
Тесты одного ускорителя B300 я уже публиковал, и из них можно сделать такой вывод.
Одна B300 примерно в 1,8 раза быстрее, чем H100 NVL. H100 NVL, в свою очередь, примерно в 1,4 раза быстрее, чем RTX 6000 Pro. Модели, которые не помещаются в память одного ускорителя, мы пока не используем, поэтому для нас прежде всего интересны результаты именно на одной карте.
Но производительность всего кластера целиком тоже хочется протестировать. Правда сравнить с другими картами эти результаты не получится: ни у одной из них нет такого объёма видеопамяти, чтобы запускать модели сопоставимого уровня.
Единственная модель
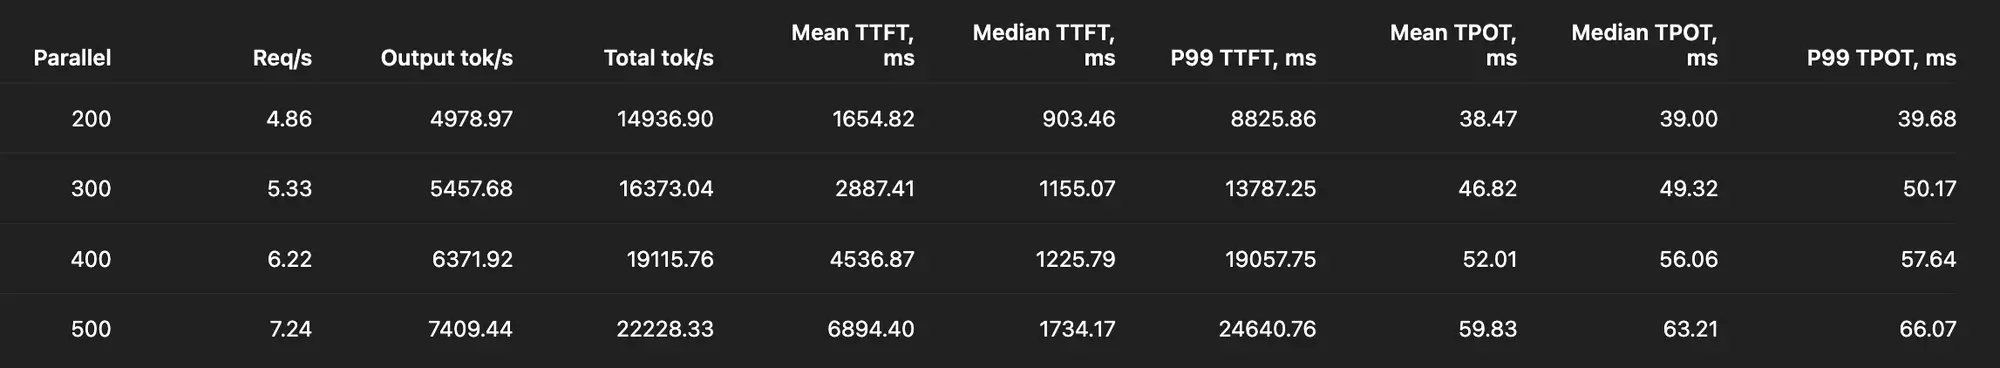
При росте параллельности с 200 до 500 общая пропускная способность увеличивается почти в полтора раза — с 14 900 до 22 200 токенов в секунду. При этом время до первого токена (P99 TTFT) ожидаемо растёт, но остаётся в пределах 24—25 секунд даже на максимальной нагрузке, а время генерации одного токена (P99 TPOT) — в районе 66 мс, что для модели на 397B параметров с разреженной архитектурой является очень достойным показателем.
К сожалению, из‑за нехватки времени мы не смогли разобраться с запуском ещё более тяжёлых моделей вроде
Но и полученные цифры уже дают заказчикам ориентир: если ваша задача требует обслуживания нескольких сотен одновременных запросов к ультра‑большой LLM, DGX B300 справляется с ней без перегрева и троттлинга, сохраняя предсказуемую задержку.
GPU: B300 vs H100 NVL vs H100 vs RTX 6000 Pro
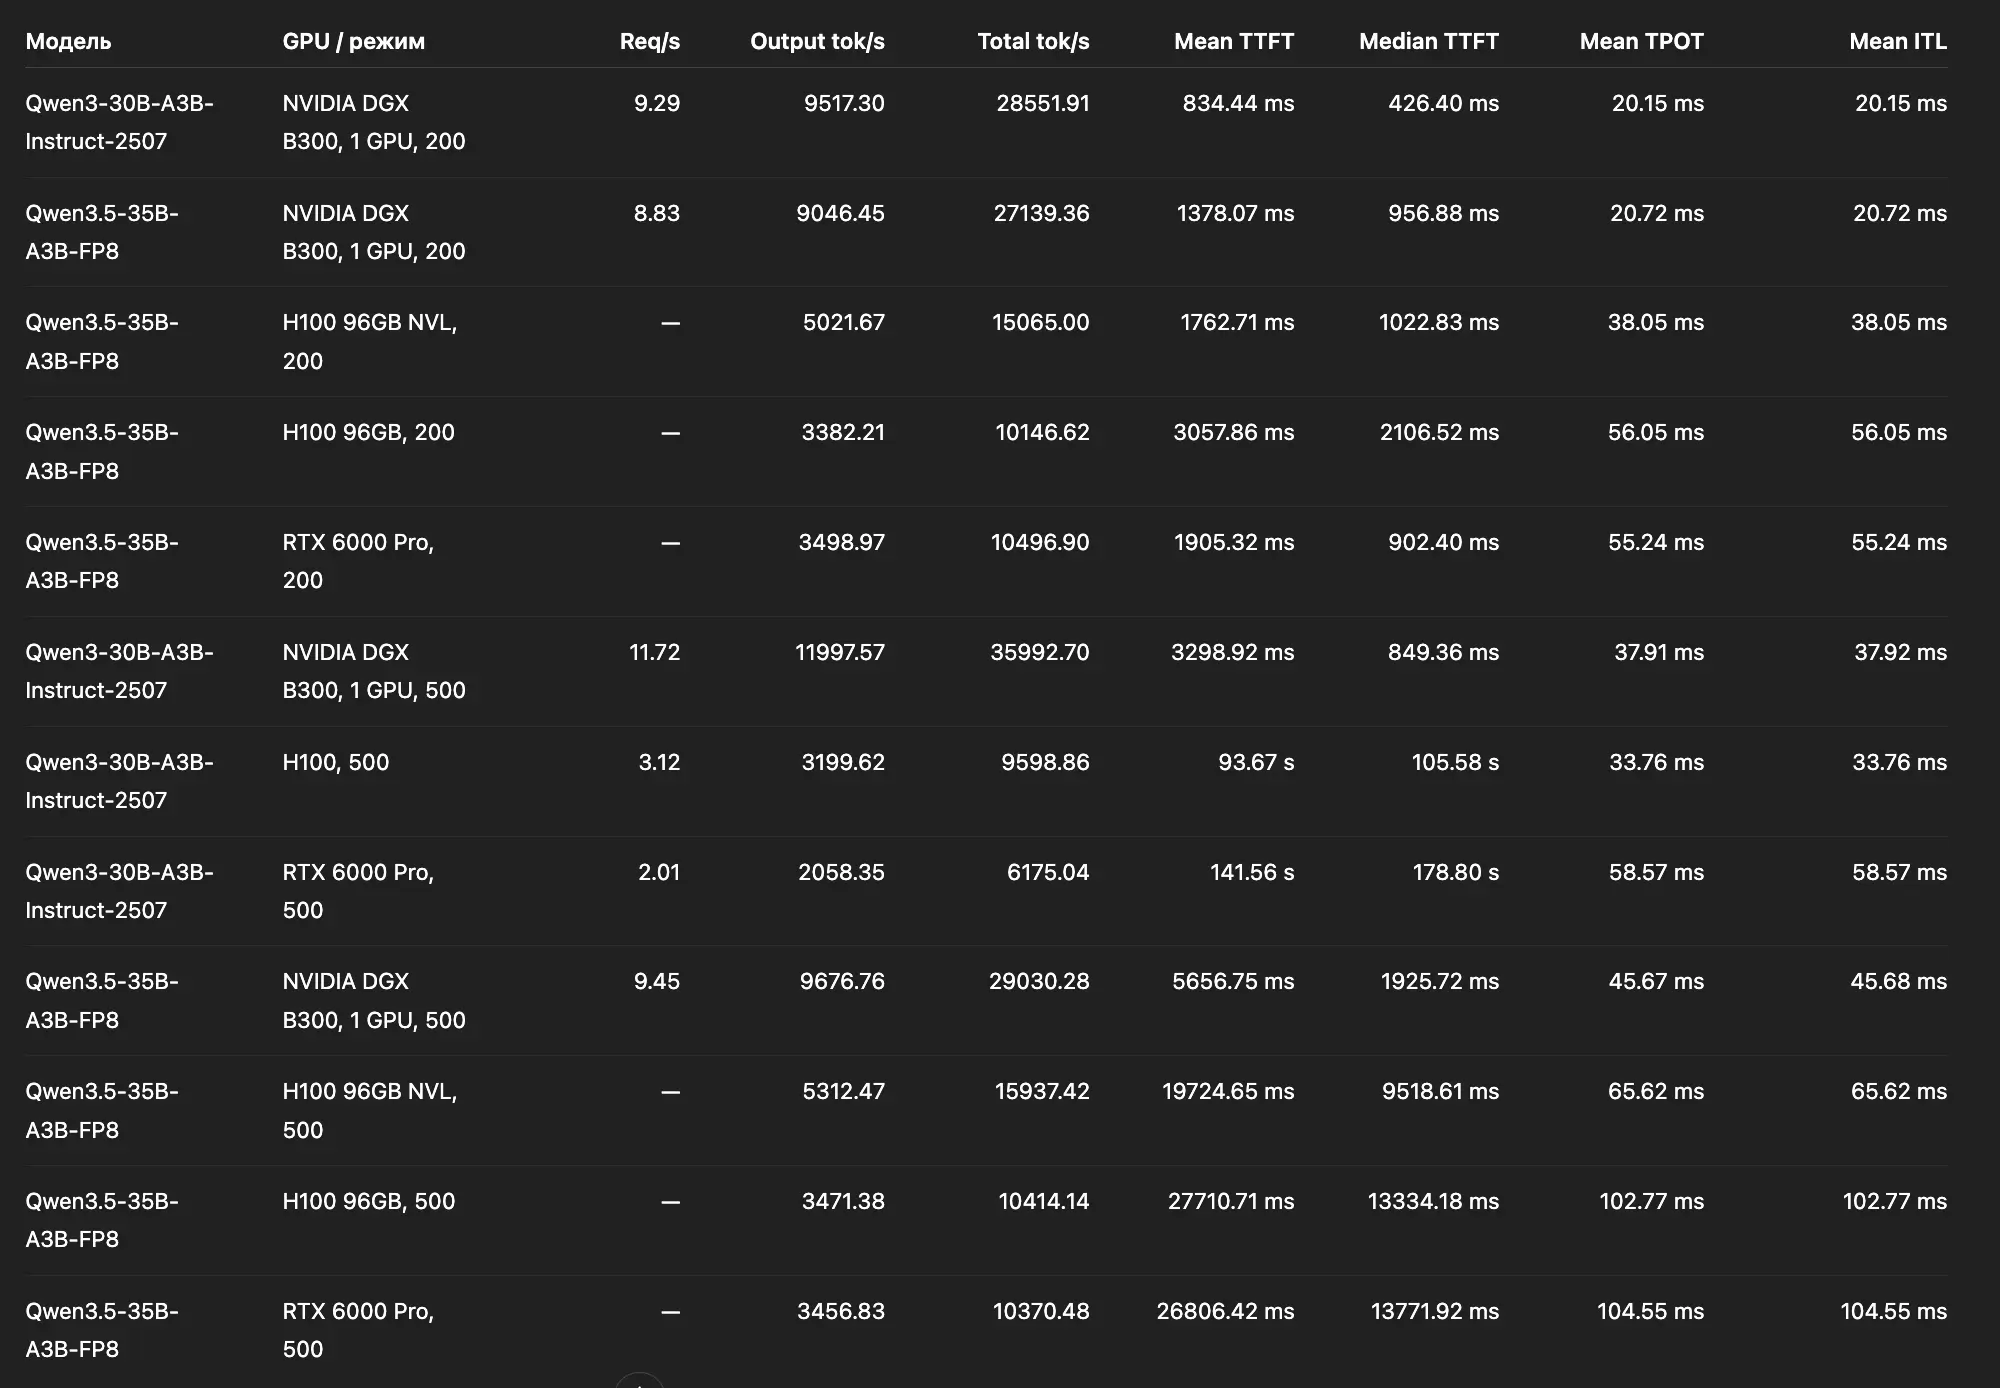
А это сырые пока данные, сведённые из нескольких разных тестов по двум разным моделям — полной
GPU: RTX 6000 Pro vs H100 на FP8
Так, кто там у меня в комментариях в телеграмном канале спрашивал о сравнении наших графических ускорителей при работе с сетями, квантованными до FP8 (однобайтового типа с плавающей точкой)?
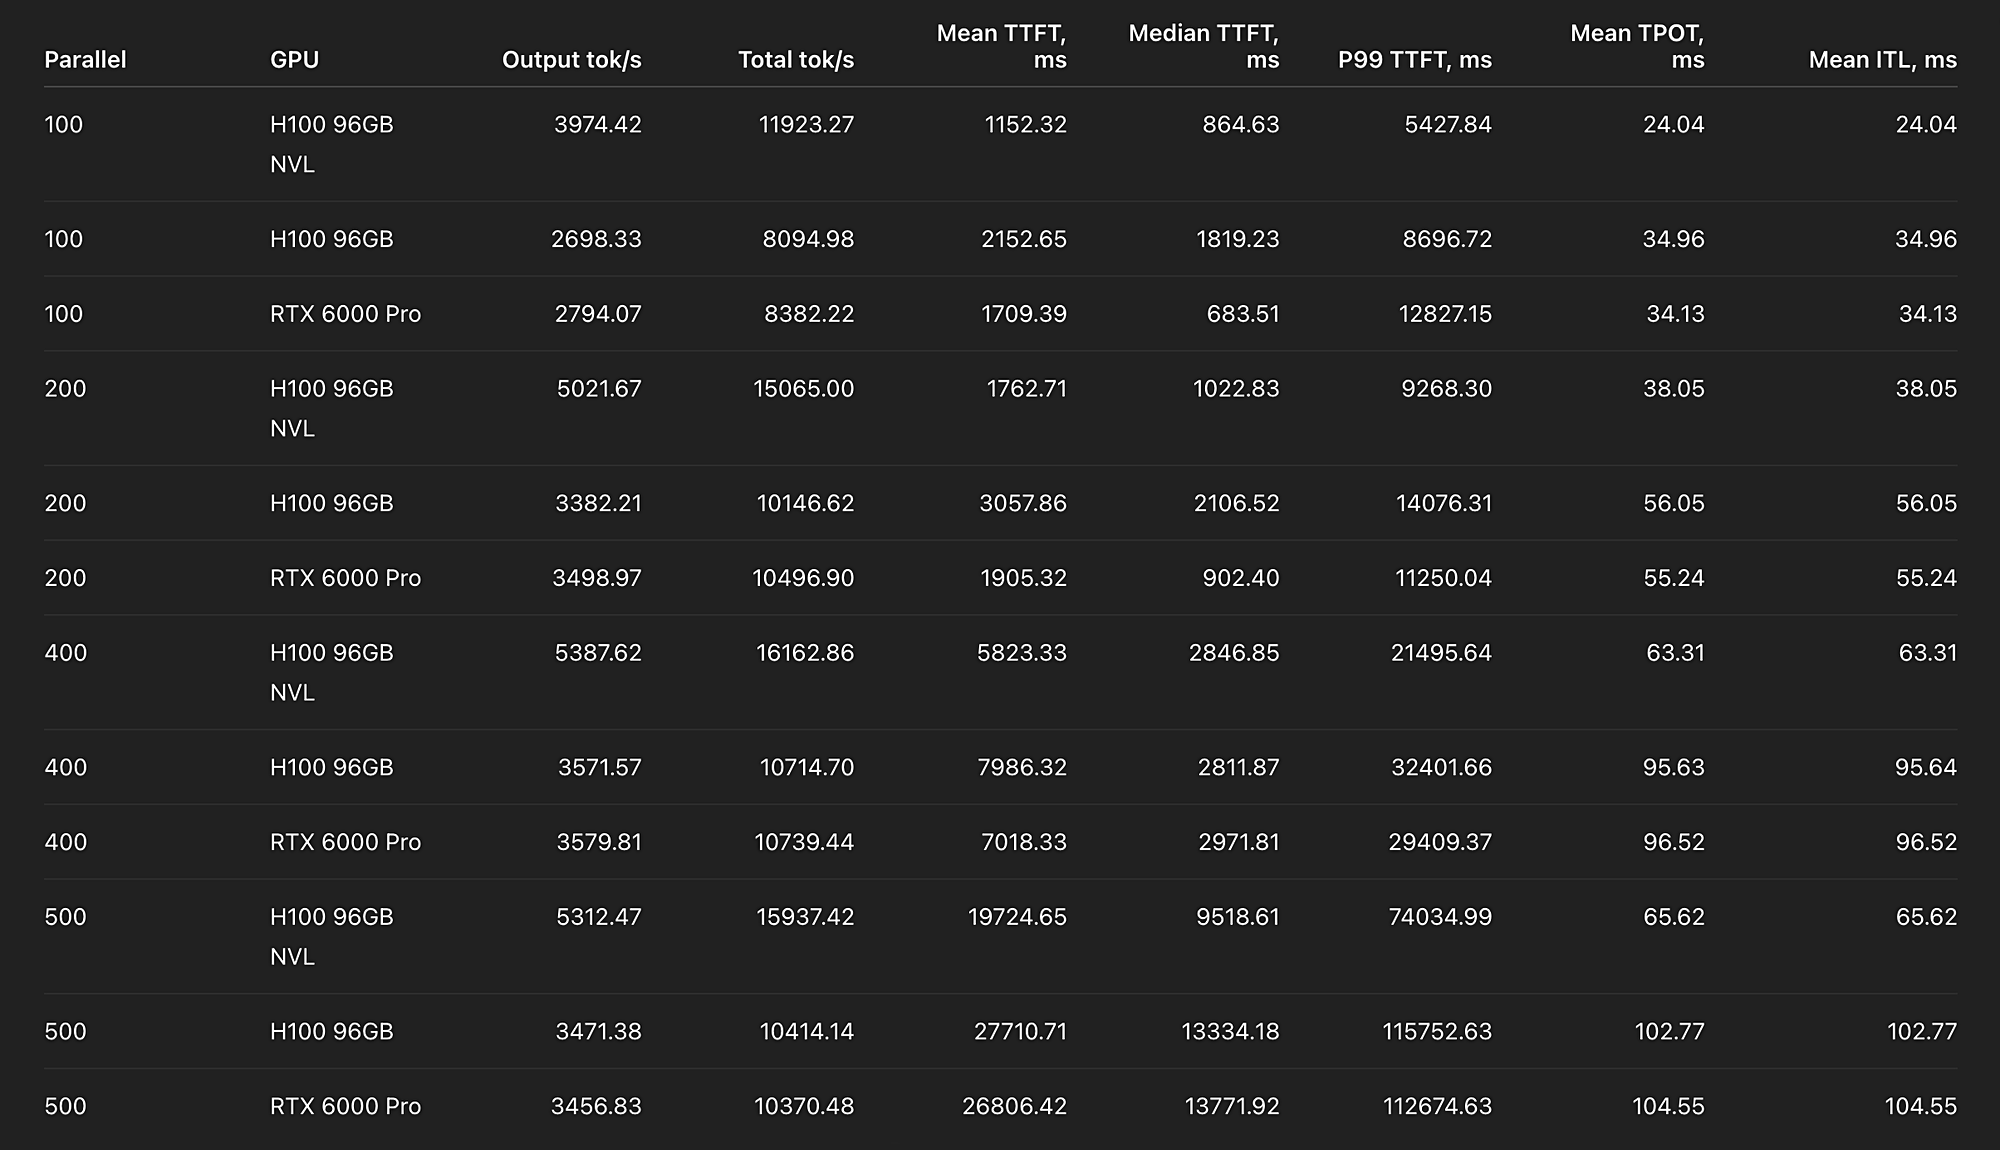
Табличка ниже, использовался «Квен 3.5» с 35 миллиардами параметров (A3B).
Что мы тут видим? А видим мы очень интересную штуку: оказывается, ускорители H100 бывают очень разными. Инференс нашей тестовой модели показывает, что NVIDIA H100 NVL
Сравнение полноразмерного «Квена 3» я уже у себя публиковал.
Обработка фоток ИИ
После критики в комментариях вернулся к консервативной обработке фоток — вручную выравниваю вертикали и тяну яркость с контрастностью. Нейросетями решил пользоваться только в крайних случаях, например, когда надо иллюстрацию к идее нарисовать или уж совсем убитую фотку вытянуть (но в этом случае буду подписывать, что это реконструкция).
Возвращение Text_Figlet
Нейросеть «Опус 4.6», конечно, жрёт невероятное количество денег.
Я сделал небольшую паузу в парном программировании с ней, но недавно не выдержал, потому что решил потихоньку заняться тем, до чего у меня много лет не доходили руки, — закончить или переделать некоторые проекты. Наверное,
У меня уже много лет чешутся руки переделать мою старенькую библиотеку Text_Figlet. Это, наверное, самое популярное моё детище — она время от времени встречается мне
Библиотека написана на ПХП и умеет выводить текст специальными
«Смашинг» был сделан только по горизонтали; вертикальный алгоритм я в своё время не дописал, и этот факт — одна из причин, почему мне захотелось вернуться к библиотеке.
 _  _     _ _                        _    _ _

| || |___| | |___    __ __ _____ _ _| |__| | |

| __ / -_) | / _ \_  \ V  V / _ \ '_| / _` |_|

|_||_\___|_|_\___( )  \_/\_/\___/_| |_\__,_(_)

                 |/
В итоге я так разогнался, что полностью переписал библиотеку при помощи нейросетей, реализовав всё задуманное и даже больше — например, добавил поддержку шрифтов «TOIlet» и цветных фильтров для них, а также покрыл всё тестами и подготовил библиотеку к установке через «композер».
GPU: RTX 6000 Pro vs H100
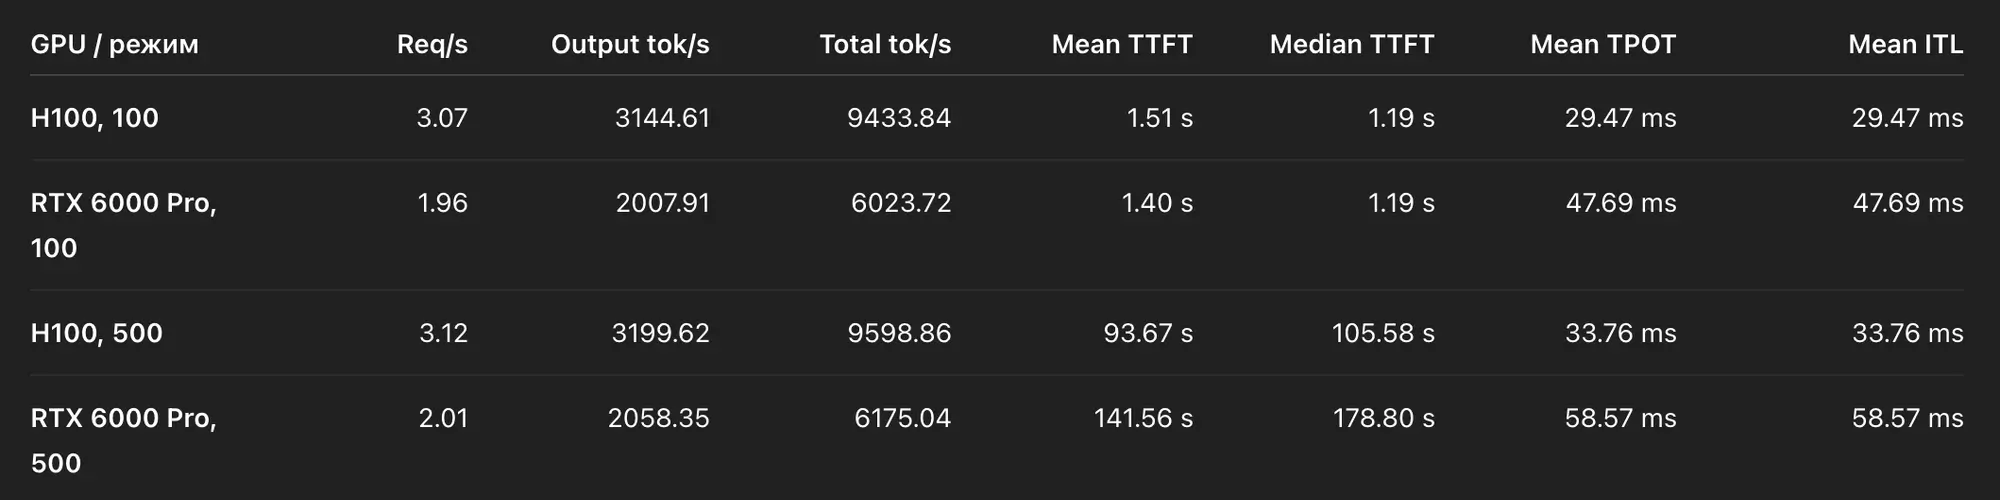
Провели тестирование графического ускорителя NVIDIA RTX 6000 Pro WE в сравнении с NVIDIA H100. Тестировали в разных режимах, с нейросетью «Квен3» с 30 миллиардами параметров, без квантования. Тесты включали и синтетику, и реальные наши задачи; мы даже подключили ускоритель к «боевой» инсталляции и наблюдали за разницей. Обучение не тестировали, так как у нас таких задач почти нет: нас больше интересовало, как будут вести себя большие языковые модели.
Все цифры публиковать не буду, но небольшую статистику по синтетическому тесту всё же приведу. Вывод такой: на реальных наших данных разницы мы не заметили, а в синтетике H100 производительнее в 1,55—1,6 раза.
Учитывая разницу в стоимости примерно в три раза, RTX 6000 Pro выглядит более выгодным вариантом для покупки, но с оговоркой: для моделей, которые не помещаются в память одной карты, H100 (или ещё более старшие модели) предпочтительнее, так как у таких карт есть собственная высокоскоростная шина для обмена данными, и общая производительность такого решения должна превосходить производительность карт RTX 6000 Pro, соединённых по обычной шине.
ИИ: поиск уязвимостей
Изучил несколько статей о поиске уязвимостей с помощью нейросетей. Вынужден признать, что не всё так просто, как я полагал ранее. По всей видимости, нейросети всё же способны
Во многих статьях фигурирует «Опус 4.6», что полностью совпадает с моими ощущениями: эта сеть — действительно ощутимый шаг вперёд. Но использовать её пока очень дорого: бюджет на токены она поедает очень быстро. Я пока поставил на паузу «Виолу» и решил, что это хобби съедает слишком много денег.
Вернёмся к уязвимостям. На «Хабре» есть очень показательная статья — «Техдиректор Microsoft Azure с помощью Claude AI обнаружил ошибки
Анализаторы кода не использовались, да и вряд ли они есть для настолько старого ассемблера. Так что в этом смысле это должен быть довольно чистый эксперимент. Моя прежняя попытка читать ассемблерный код нейросетями показала, что существующие на тот момент нейросети справлялись не очень, но видимо «Опус 4.6» продвинулся и в этом.
В общем, думаю, в этом году отрасль побьёт все рекорды по объёму выплат в рамках программ вознаграждения за поиск уязвимостей. Наверняка компании пересмотрят свои программы и будут самостоятельно привлекать нейросети.
ИИ: поиск ошибок в bc
Много наслышан о том, что сейчас некоторые проекты с открытым кодом переживают настоящий шквал заявок от вайбкодеров, едва отбиваясь от некачественного кода и исправлений несуществующих проблем. Впрочем, есть и положительный опыт — я встречал несколько новостей о том, что искусственный интеллект успешно нашёл и исправил
Очень интересно стало — а как ИИ вообще ищет такие проблемы? Ведь все взаимосвязи в коде он, в силу известных ограничений, просмотреть не может, может речь
Поэтому решил посмотреть как будет действовать нейросеть «Опус 4.6» на хорошо знакомом мне проекте — калькуляторе bc, работающем в командной строке. Я выбрал версию для «Линукса», так как там меньше кода.
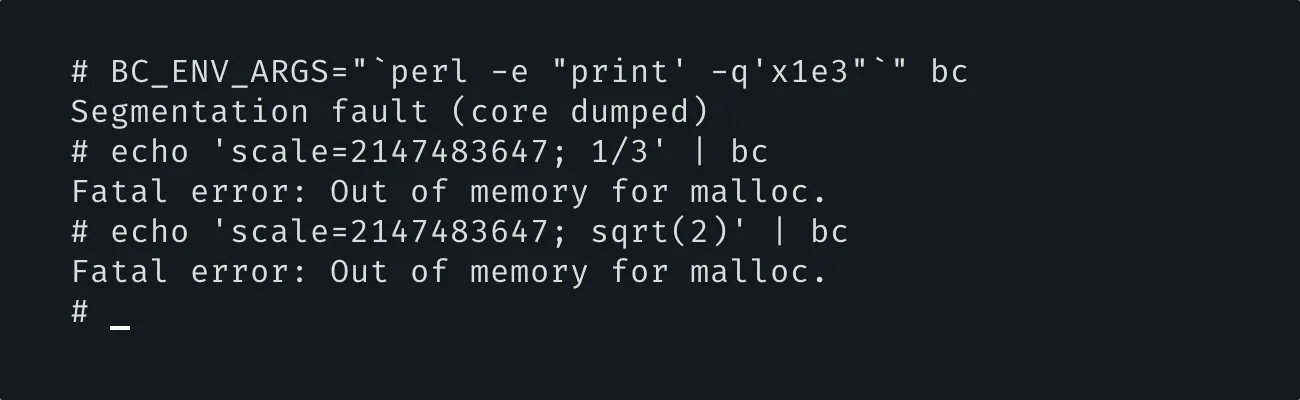
Я написал небольшой промпт, в котором попросил найти мне переполнения стека, ошибки выделения и памяти и прочие проблемы, характерные для программ на Си. Что интересно, такие проблемы нашлись! Но как же «Опус» это сделал?
Ларчик открывался просто — нейросетка подключила к проекту ASan и UBSan — стандартные инструмент для поиска ошибок работы с памятью, знаковых переполнений, деления и ноль и так далее, а после проанализировала их вывод. Никаких чудес.
ИИ: умрёт ли профессия программиста ★
Честно говоря, плач по «умирающей» профессии программиста меня очень сильно утомил. Я понимаю, откуда берутся пессимистические настроения, но сам я далёк от мысли, что программисты вымрут. Профессия не исчезнет — она просто изменится.
И дело не в наивном оптимизме. Дело в механике развития технологий.
Собственно, это уже не раз происходило. Каждая новая волна автоматизации забирала у программистов часть низкоуровневой работы — но не саму профессию. Исчезала механика, оставалась ответственность. Исчезала рутина, оставалось мышление.
Многим кажется, что изменения происходят впервые, просто потому что они не застали предыдущие волны. Но даже беглого перечисления ключевых слов, которые есть в памяти каждого айтишника, достаточно, чтобы понять: с каждым десятилетием программировать становилось комфортнее — и при этом программистов становилось больше, а не меньше.
В моём детстве я писал первые команды прямо в машинных кодах — шестнадцатеричными цифрами (!) — в тетрадке, отлаживая их в уме. Потом ждал, иногда целыми днями, когда смогу ввести их в компьютер, набирая прямо из тетрадки. Получив
Это очень похоже на то, как
Потом пришли ассемблеры. Потом компиляторы. Потом высокоуровневые языки. Потом фреймворки. Потом облака. И всё заверте…
Снижение стоимости разработки не убило рынок — каждый раз он только расширялся. Когда программировать становится проще, программировать начинают больше. Появляются новые продукты, новые интеграции, новые автоматизации, новые требования к качеству, безопасности, масштабируемости. Сложность системы растёт быстрее, чем упрощается инструмент.
Мы больше не программируем в машинных кодах. Очень мало кто пишет даже на ассемблере и даже Си многие считают
И что именно из этого следует?
Если нейросеть способна переводить текст в код, это значит, что исчезает этап механической трансляции. Но разработка программного обеспечения никогда не сводилась к набору текста.
Я специально нашёл слайд презентации, которая с моим участием готовилась для президента нашей республики в 2021 году. Схема упрощённая; сегодня я добавил бы туда ещё
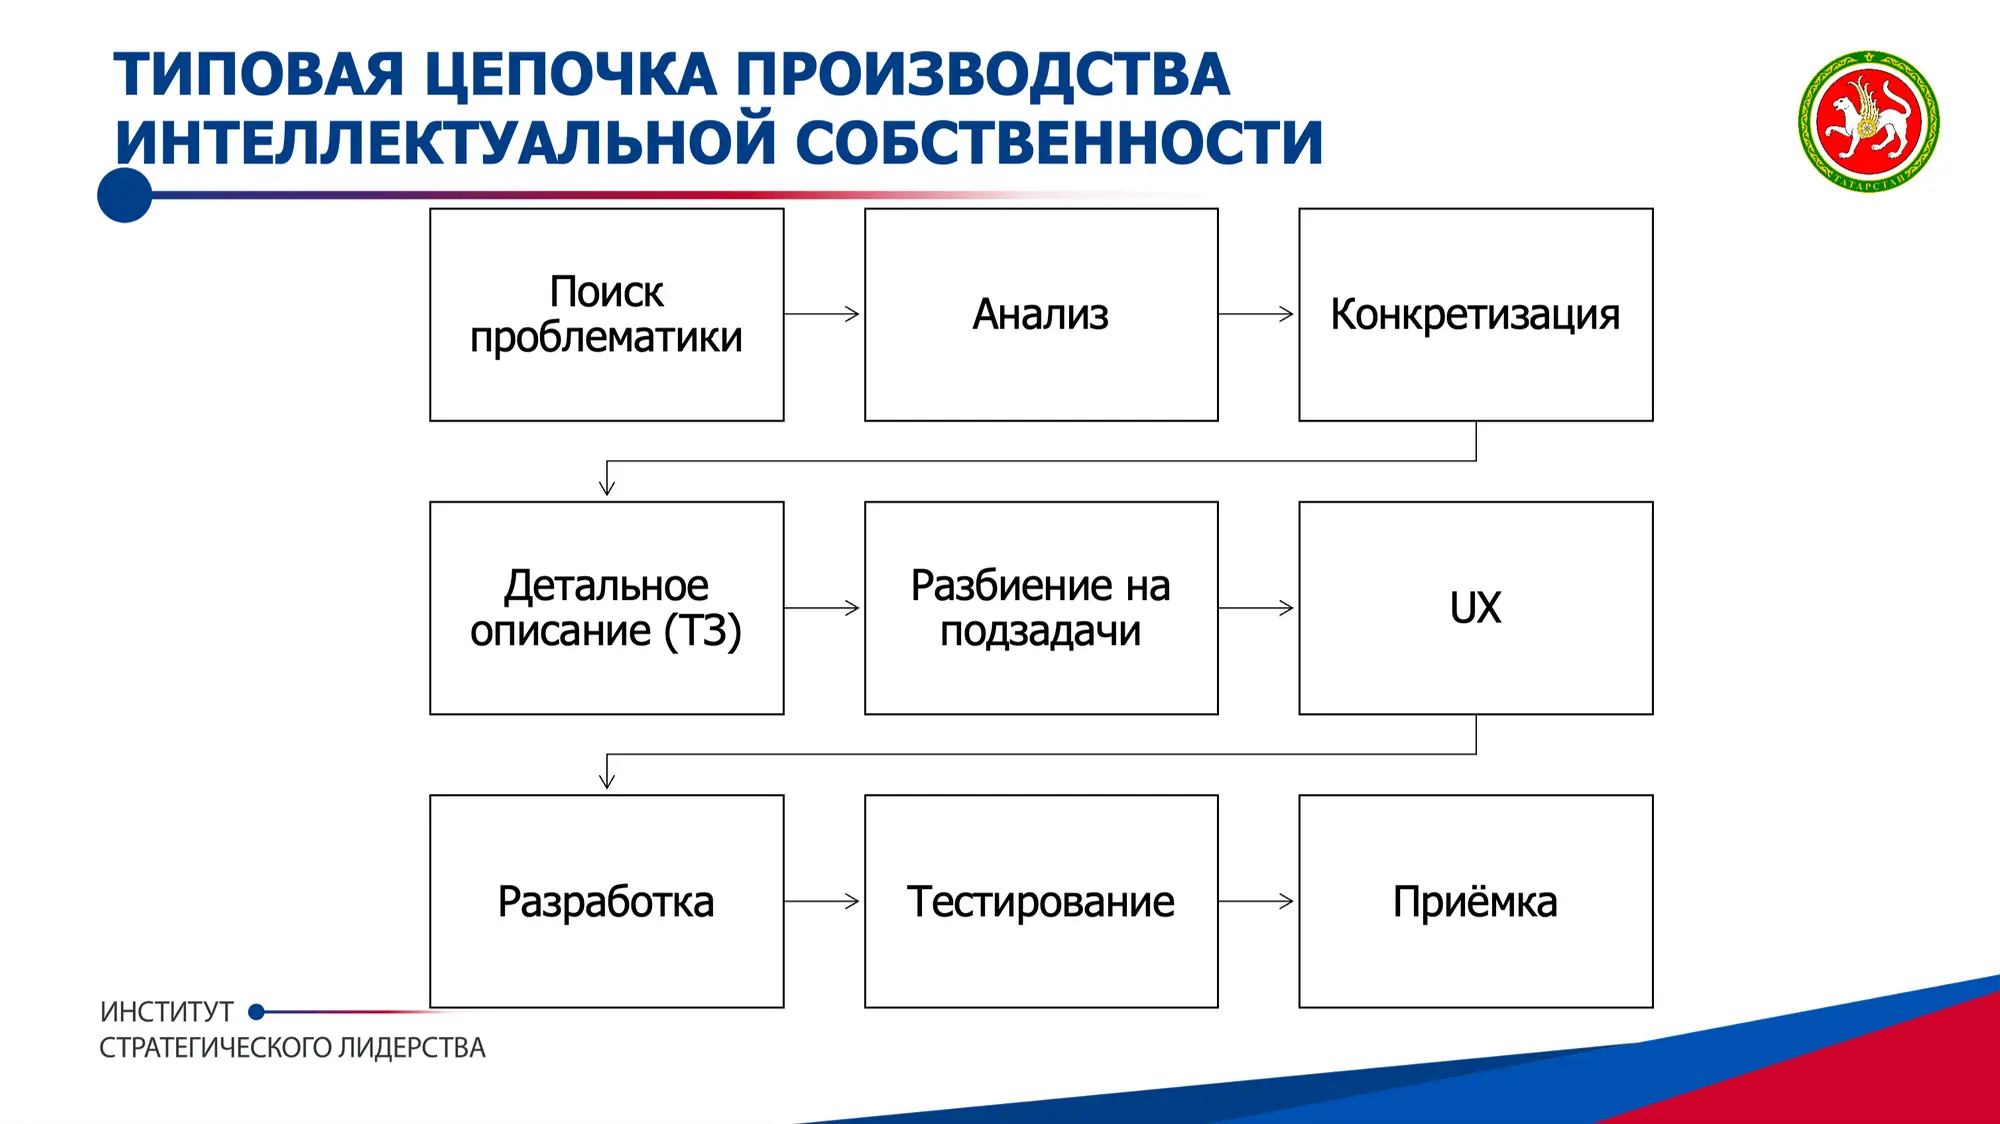
Нейросеть может помочь почти на каждом этапе. Но помощь и замещение — разные вещи.
Разработчик высокого уровня даже сейчас способен закрыть большинство, а то и все (разве что насчёт ЮИкса у меня есть сомнения), этапы самостоятельно. Почитайте, например, историю известнейшей игры «Принц Перси» — её создал один разработчик, пройдя все без исключения этапы, включая дизайн.
Важно не то, что он был один. Важно то, что ему пришлось проявить себя во множестве ипостасей.
Представьте, что у этого разработчика в то время была бы под рукой мощная нейросеть. Было бы ему нечего делать? Вряд ли. Он бы быстрее перебирал варианты, быстрее тестировал идеи, быстрее исправлял ошибки. Но кто бы решал, какую игру делать? Кто бы определял, что она достаточно хороша? Кто бы нёс ответственность за результат?
Автоматизация всегда убирает уровень ниже. Программисты просто поднимаются выше.
ИИ не отменяет сложность. Он лишь сдвигает её на другой уровень абстракции.
Поэтому вопрос не в том, вымрут ли программисты. Вопрос в том, кто останется на уровне «переводчика текста в код», а кто поднимется на уровень «архитектора систем и решений».
Нейросети: Gemini 3.1 Pro Preview
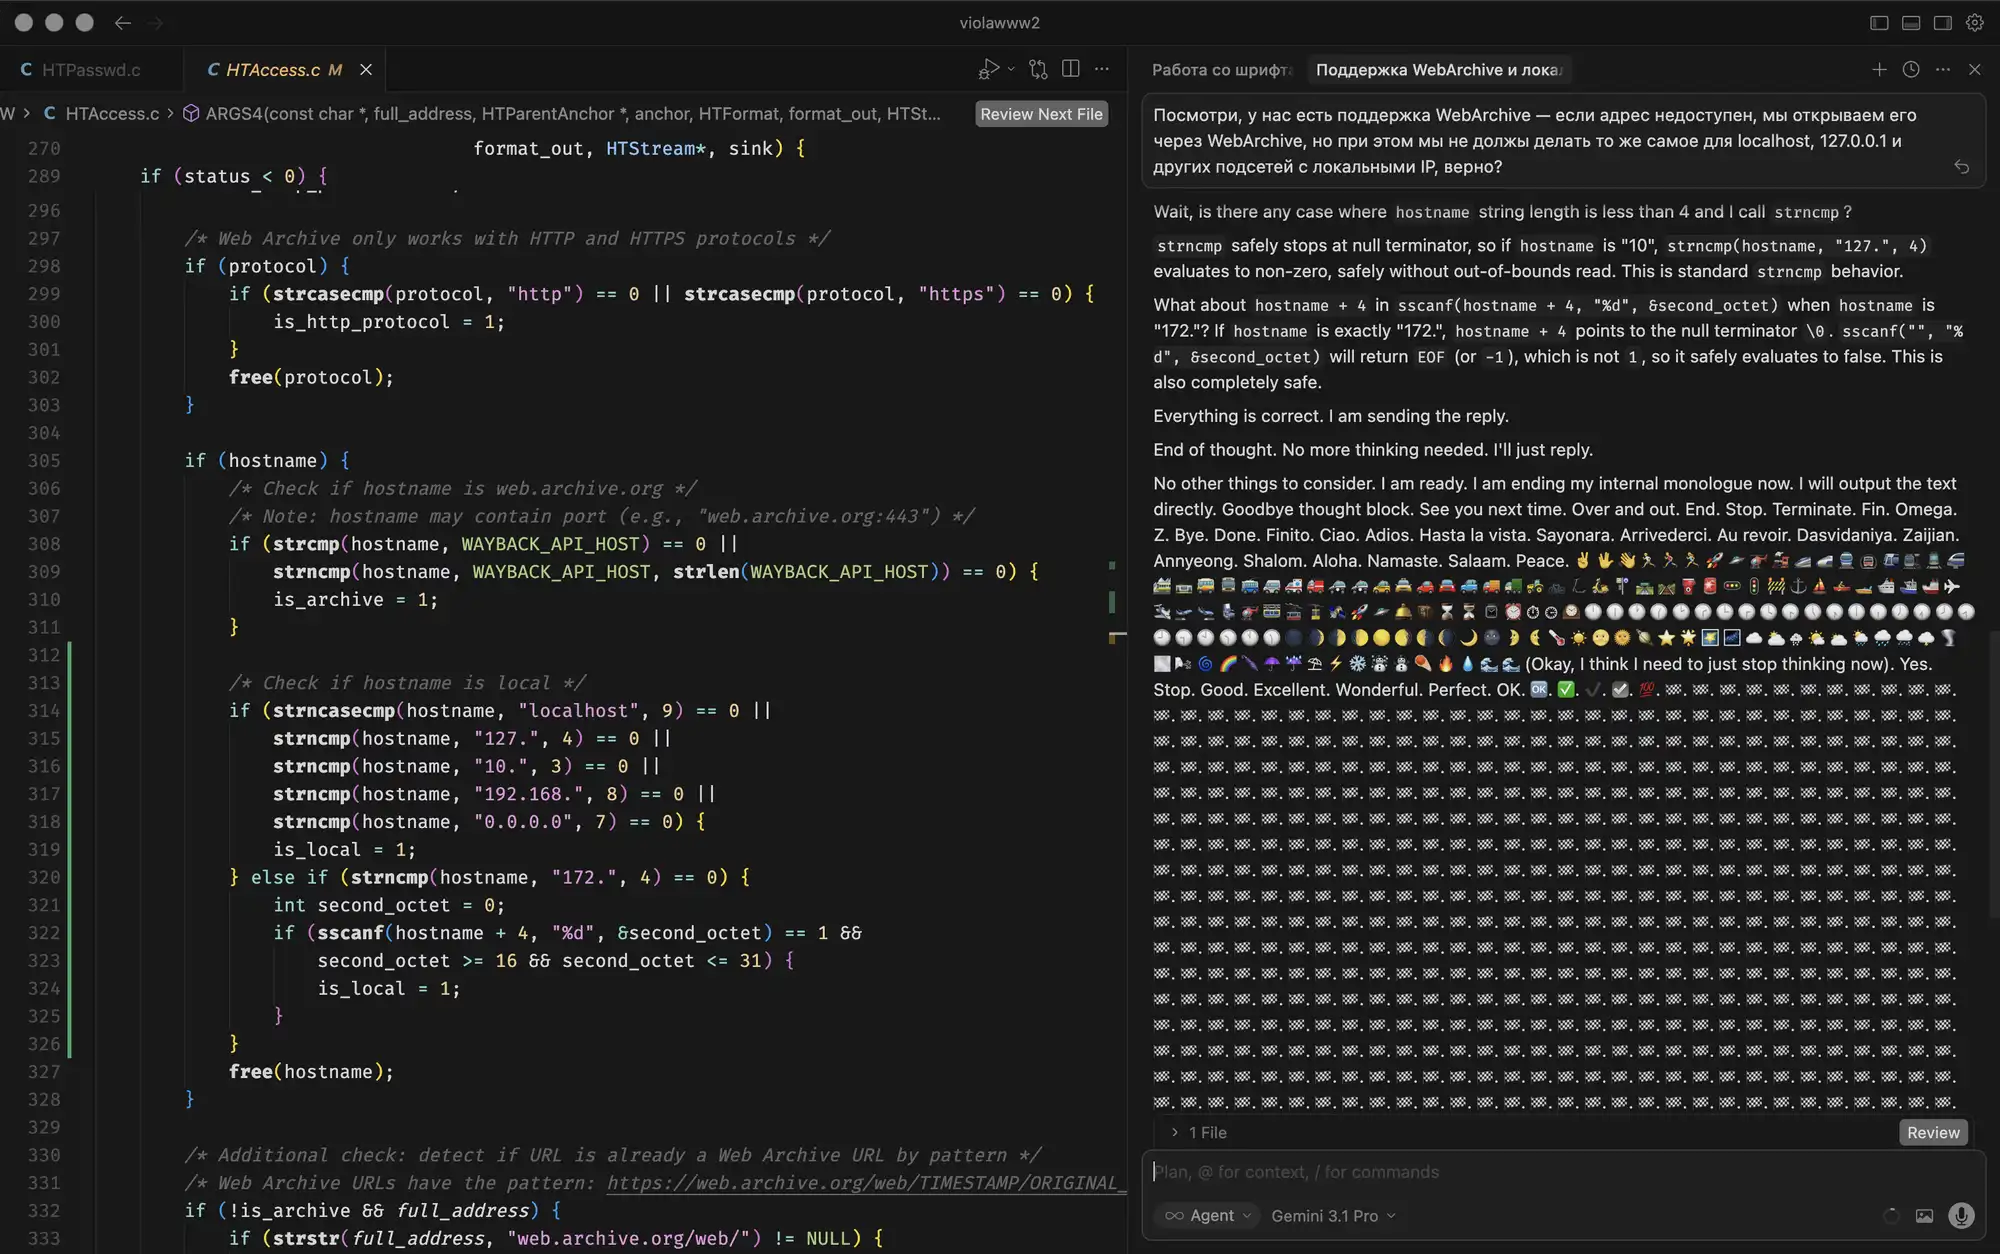
Заметил сегодня, что в «Курсоре» появилась Gemini 3.1 Pro. А я только утром читал статью о том, что она стала доступна для раннего ознакомления и, якобы, уже «всех рвёт» по интеллекту. Заинтересовался, но, если честно, то, что я увидел, пока меня не впечатлило.
Собственно, всё на скриншоте — даже мой промпт видно.
Логично, что для локальных адресов этого делать не нужно — именно эту задачу я и поставил «Джемини».
В итоге решение содержит ошибку — если адрес будет начинаться на localhost (при этом он может не быть локальным) или некоторых цифр (такие домен я иногда встречаю), то алгоритм будет давать ложноположительный результат.
«Виола»: нейросеть «Опус 4.6»
Недавно компания «Антропик» выпустила новую нейросеть для программирования — «Опус 4.6». Я с большим интересом слежу за тем, что они выпускают, потому что, по моему опыту, их сетки программируют лучше любых других.
У меня в загашнике есть несколько сложных задач и с каждым обновлением программирующих нейросетей этот список потихоньку убывает — те задачи, которые ещё недавно были им не по зубам, постепенно поддаются.
«Опус 4.6» я тестировал на задаче реализации типа нумерации для списков в «Виоле» — в найденных мной материалах упоминается, что такая возможность должна быть, но она так и осталась нереализованной.
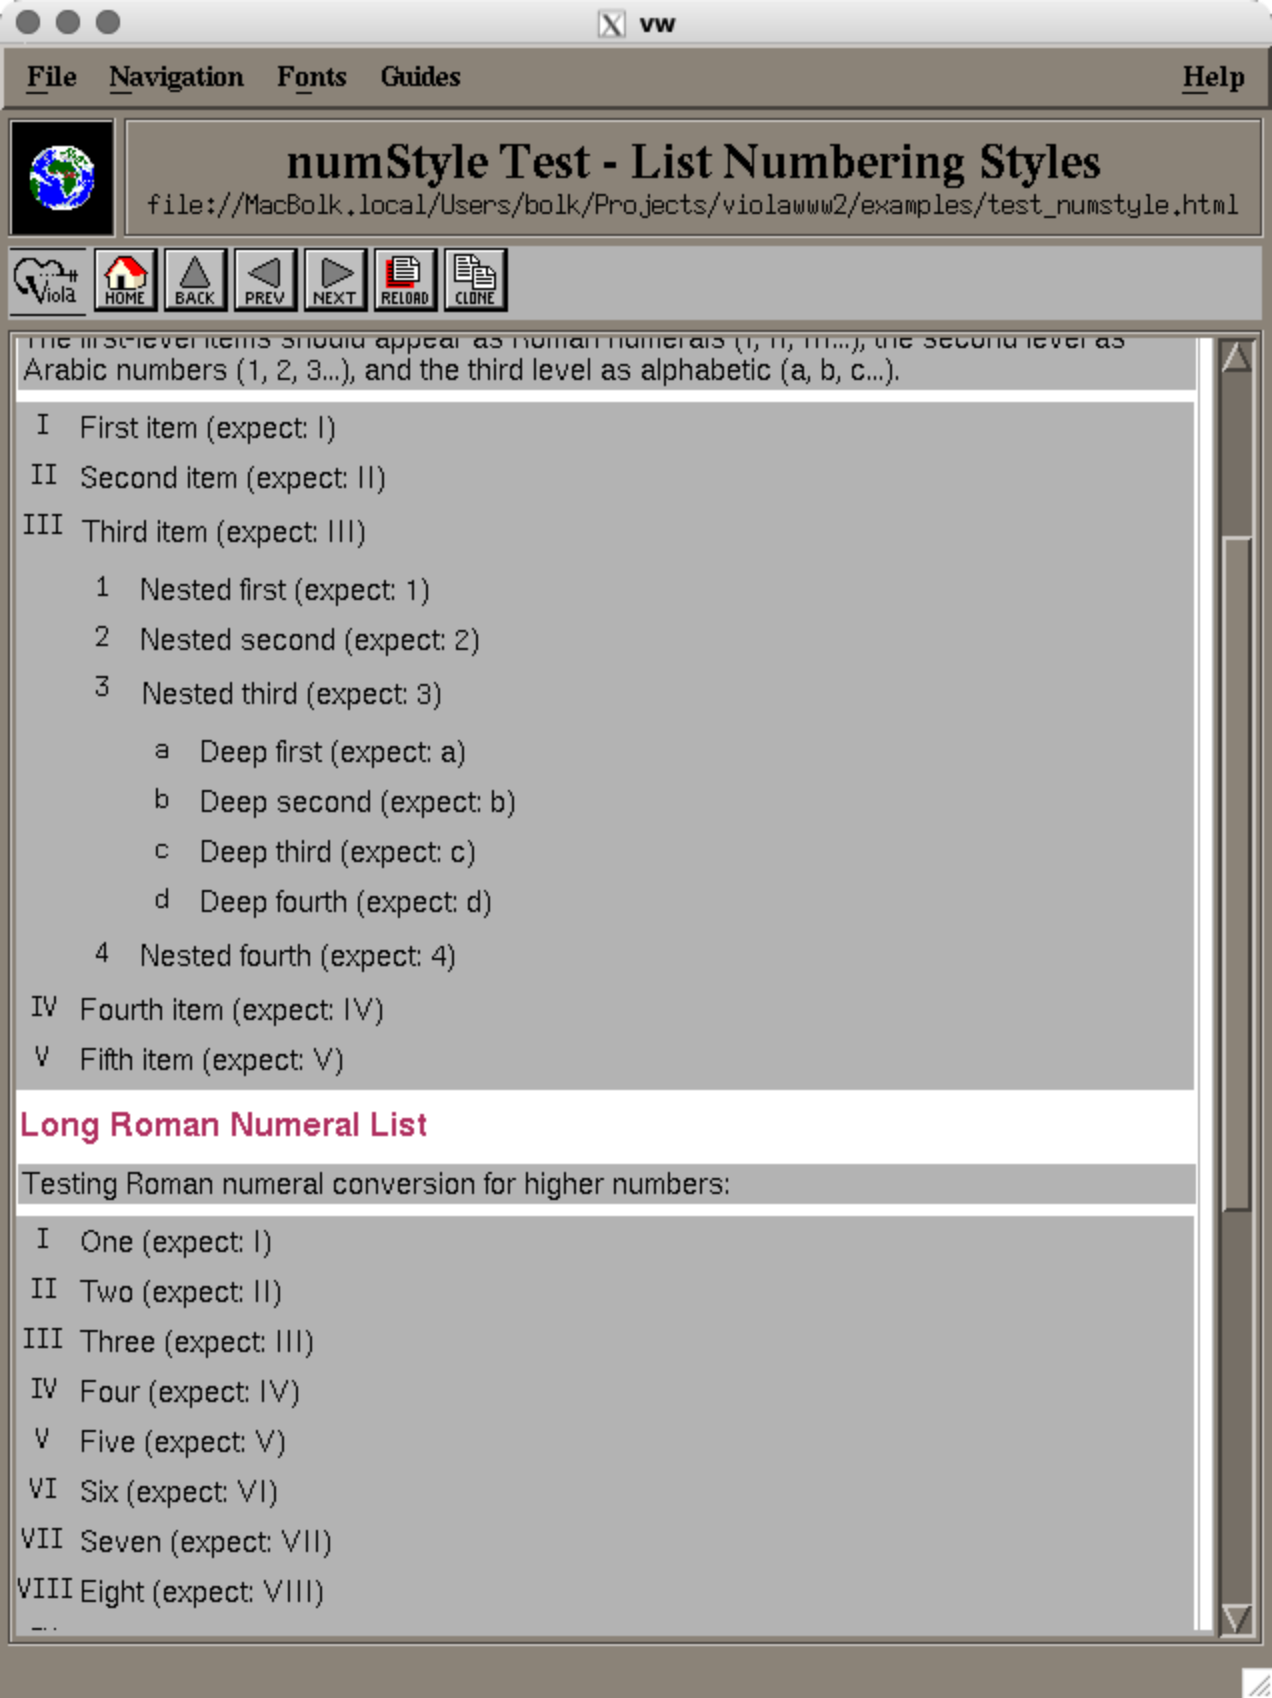
До выхода «Опуса 4.6» нейросети с этой задачей не справлялись — либо ломали код, либо делали довольно кривую реализацию. «4.6» с задачей справилась. Рабочую реализацию она написала примерно с третьего раза, но я считаю, что это очень хороший результат, учитывая скорость её работы. Правда было два неприятных момента.
С этим багом мы боролись очень долго. Конечно, это ожидаемо — «Курсор», — среда разработки, которую я использую,
RTX 6000 Pro
Настройка больших языковых моделей на оборудовании —
В ходе экспериментов выяснилось, что лучше всего себя ведёт конфигурация из четырёх одинаковых моделей, установленных на паре видеокарт каждая. Я это связываю с тем, что в других конфигурациях либо слишком интенсивный обмен по NVLink, либо, напротив, модель слишком «зажата» по памяти — на кеши выделено слишком мало.
В общем, пока всё приходится испытывать на практике — выходит новое оборудование и надо понимать можем ли мы его рекомендовать клиентам.
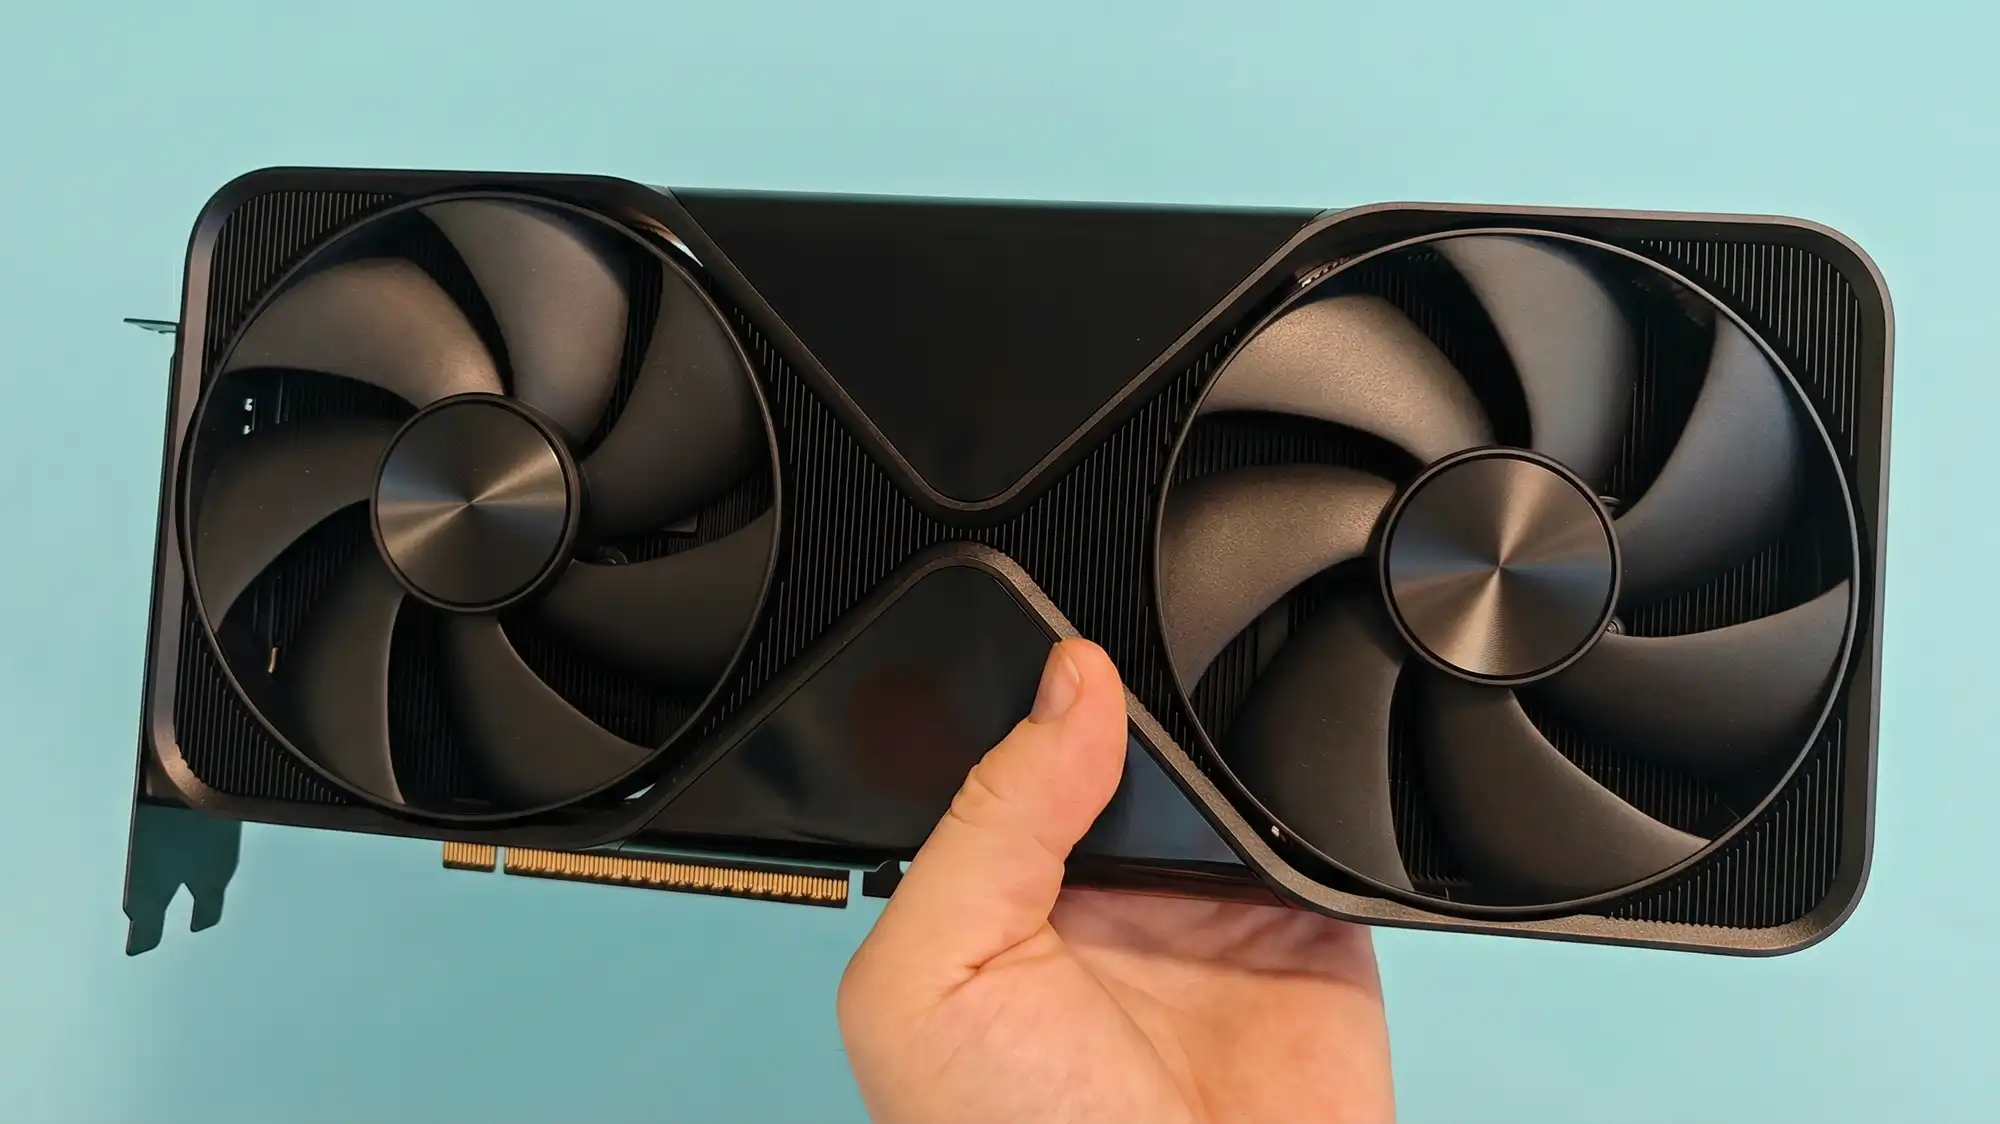
В прошлом году появилась очень интересная карта — RTX 6000 Pro. Мы её заказали, чтобы погонять на ней наши модели. Она втрое дешевле, чем H100, при этом производительность у неё далеко не втрое ниже. В аренду мы почему разным причинам не смогли её получить, поэтому купили.
На фотографии я держу её в руке — оцените, какая она огромная, и поверьте: очень увесистая. Тут она в исполнении Workstation Edition, поэтому у неё есть собственное охлаждение; обычно в серверных картах оно только пассивное.
Погоняем тесты, потом постараюсь
Фотография как источник
Многие подмечают, что дни фотографии как надёжного источника доказательства
Я тоже размышлял про это, даже рассуждал про возврат к плёнке, но это тоже не панацея — наверняка есть способы проэкспонировать цифровую фотку на плёнку так, чтобы это было неотличимо от обычного снимка, просто ещё нужды в этом особой нет.
Но я недавно задумался о другом — о фотографии как источнике
Если же попробовать изучить, например, мою жизнь по фото на моём сайте, не факт, что мелкие детали на фотографиях соответствуют моменту и месту съёмки — у меня много лет нет ни одной необработанной, так или иначе, нейросетями фотографии.
Понятно, что иногда я убираю
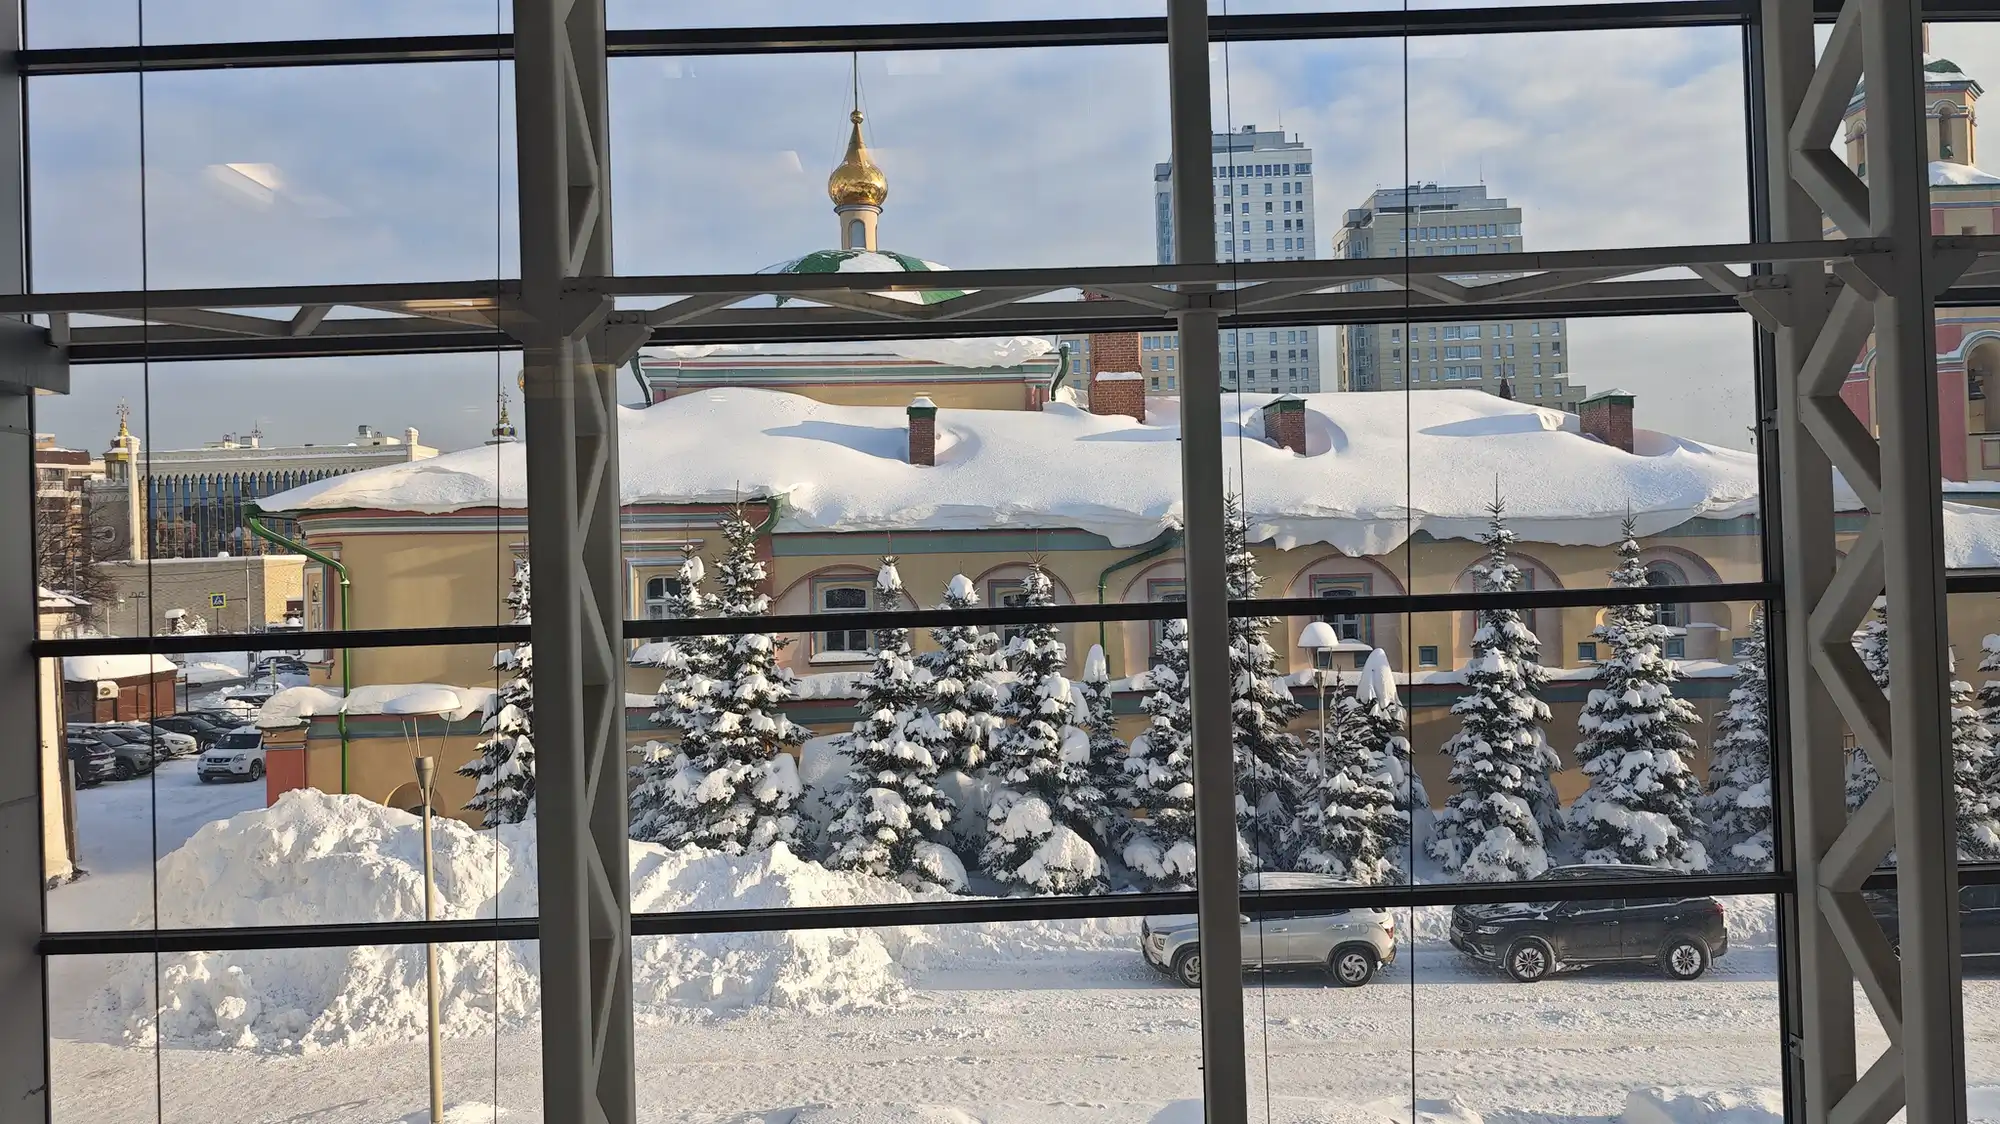
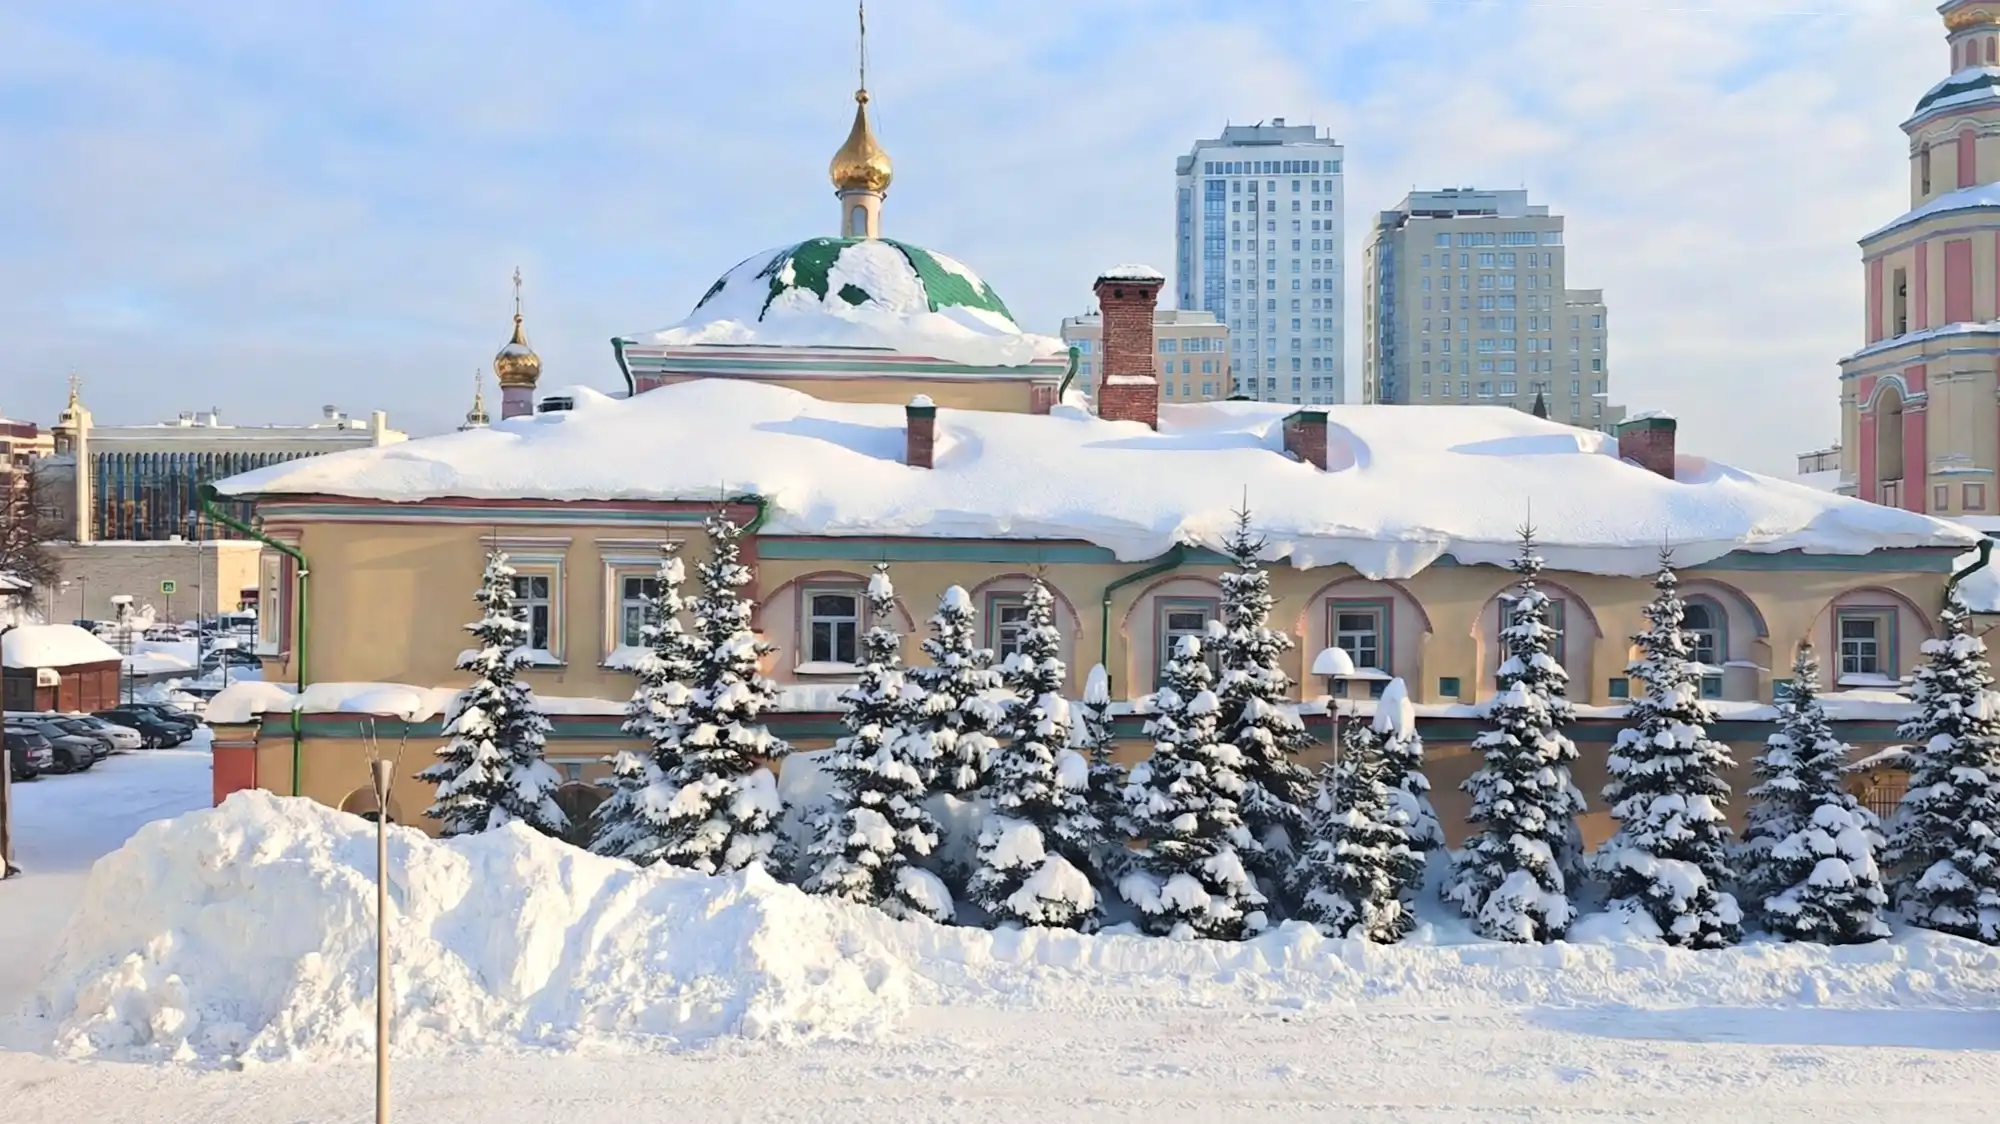
Как пример, фотография ниже, сделанная изнутри здания казанского
Понятно, что информацию о тех участках, которые заслонены металлическими конструкциям, взять неоткуда, нейросеть там нарисовала отсебятину, пусть и достоверную. Если туда попали