программирование
Бу: ООП в bash
ООП к «башу» приделать и до меня пытались, ничего в этом смысле нового, но мне ни одна реализация не нравится, из того, что я видел, всё примитивное и синтаксис кривой, всё время хотелось свою сделать. Вчера вечером заморочился, думал на выходных
Долго мучался с названием, решил, что пусть пока называется «Бу» (
#!/bin/bash
# Evgeny.Stepanischev Jan 2013 /

. b-oo.sh

@Class Base
    @Dim cnt

    @Dim
    __construct() {
        This[cnt]=0
    }

    @Dim
    IncCnt() {
        let 'This[cnt]++'
    }

    @Dim
    GetCnt() {
        [ "$This[cnt]" -gt 1 ] && s=s
        echo $Self said $This[cnt] time$s
    }
@End

@Class Dog Base
    @Dim
    say() {
        $This.IncCnt
        echo 'Bow-wow!'
    }
@End

@Class Car Base
    @Dim
    say() {
        $This.IncCnt
        echo 'Beep'
    }
@End

@Class Proxy
    @Dim obj

    @Dim Static
    getInstance() {
        $1.New Self[obj]
        @Ret $2 $Self[obj]
    }
@End


Proxy.getInstance Car car # создание через «фабрику», через статический метод
Proxy.getInstance Dog dog # создание через «фабрику», через статический метод

$car.say
$car.say
$car.GetCnt # 2, вызывается из родительского класса

$dog.say
$dog.GetCnt # 1, вызывается из родительского класса

Dog.New anothedog # создание через конструктор

$anothedog.say
$anothedog.say

$anothedog.GetCnt # 2, вызывается из родительского класса
Я не стал заморачиваться с модификаторами доступа (хотя может ещё и сделаю), из реализованного: создание объектов, наследование (есть множественное), статические и динамические методы и свойства, конструктор, есть переменная This (текущий объект), Self (текущий класс) и Parent (чтобы вызывать родительские методы).
Всё делается при помощи вызовов, начинающихся с собачки. Вряд ли синтаксис
# !неправильно
obj=$(Dog.New)
obj=`Dog.New`
Чтобы выполнить Dog.New интерпретатор создаёт отдельный процесс, где всё и выполняется, после выхода из этого процесса всё моё колдунство исчезает и от переданного значения толку нет (если у вас не «баш 4», тогда есть способы).
Поэтому конструктор у меня принимает первым параметром имя переменной, куда нужно положить экземпляр класса, а облегчения жизни программисту сделана специальная команда «@Ret», посмотрите как она используется в методе getInstance.
Естественно, в глобальном пространстве создаётся куча всякой магии, но у всего этого есть свои префиксы.
Получение случайного числа 0…255 в bash
Понадобилось получить случайное число в шеле из устройства /dev/urandom, написал небольшую функцию, сохраню у себя, чтобы не потерялась.
getrand() {
    head -c1 /dev/urandom | hexdump -d | sed -E '1!d;s/.+ +0+//'
}
Ещё вариант придумался (но необходим openssl):
getrand() {
    openssl rand 1 -hex | xargs -I. printf "%d" 0x.
}Отгадка: CSS не видно, картинка спрятана
«Уровень один» вчерашней головоломки прошли многие, этот ларчик открывается просто — есть RFC 5988, где описан способ подключать некоторые ресурсы через HTTP-заголовок. Этот RFC поддерживают «Опера» и «Файерфокс». На скриншоте, в средстве для разработчиков «Оперы» заголовок хорошо видно.
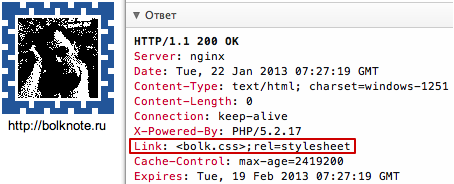
Дальше дело техники, пользуясь тем, что BODY в ДОМе есть всегда, вне зависимости от того указан ли он реально в документе, я накладываю на него стиль, выставляю размеры, обвожу бордюром и аутлайном
Теперь главное.
Есть такой стааааренький формат графики XMB, тестовый формат и по виду явно происходит от заголовочных файлов Си. Про него и не помнит уже никто, важно же в нём то, что
Вот начало одного из файлов, содержащих картинку в формате XBM:
#define _width 300
#define _height 225
static char _bits[] = {
0xbd, 0xf7, 0xde, 0x7b, 0xef, 0xbd, 0xf7, 0xde, 0x7b, 0xef, 0xbd, 0xf7, 0xde, 0x7b, 0xef, 0xbd, 0xf7, 0xde, 0x7b, 0xef, 0xbd, 0xf7, 0xde, 0x7b, 0xef,
0xbd, 0xf7, 0xde, 0x7b, 0xef, 0xbd, 0xf7, 0xde, 0x7b, 0xef, 0xbd, 0xf7, 0x0e, 0x01, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00,
0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00,
0x00, 0x00, 0x00, 0x01, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00…
}
Он тут, кстати, попроще, чем обычно используется, я выкинул название картинки, которое идёт перед подчёркиваниями. Браузеры, видимо, проще относятся к этому формату, работает и так.
У формата тяжёлая судьба, сначала его похоронил «Эксплорер», убрав в версии 6.0SP1 его поддержку
Мне давно хотелось стереть с него пыль
Вот часть CSS из вчерашнего примера:
  background: 20px 20px url(bolk.css#0x5F0xBF0xFF0xDC0x530xF60x870…) no-repeat;
  width: 80px; /*_width 80px*/
  height: 80px; /*_height 80px*/
  border: 7px dashed #259;
  outline: #259 dashed 6px;
  margin: 10px; padding: 3px;
}
Читатели правильно догадались, что после хеша в свойстве «background» записана картинка, но как она оттуда попадает в HTML не догадался никто.
В гонке выкидывания лишнего из картинки в формате XBM победила «Опера», ей нужно было только оставить первую строку «#define», которую она использует в качестве «магического» значения для определения формата,
Итак, откуда взялась картинка?
«Опера» смотрит в свойство «background» и видит там урл с картинкой, часть с хешем просто отбрасывается, в данном случае она не используется и браузер грузит картинку с адреса «bolk.css». «Опера» пытается определить в каком формате пришла картинка, тут нам помогает «магическая» строка «#define», раз она есть, стало быть это XBM.
Дальше браузер ищет в полученном файле «_width» и «_height» с цифрами и находит, считая цифры размерами картинки, после чего ищет первое вхождение «0x…» и двигается по ним, пока не находит их все, это и есть тело картинки, которую надо отобразить.
Головоломка для верстальщика: CSS не видно, картинка спрятана
Хотите голову поломать? Вот вам тест на знание всякого странного, откройте следующий урл в «Опере»:
Ответ завтра. Кажется, во всём интернете так ещё никто не делал.
Выше снимок того что вы должны увидеть на экране, я испытывал под «Оперой» последней версии (12.12) для «Мака», не факт, что под другими ОС всё так же будет.
Вот что видно в консоли, если попытаться скачать этот файл:
bolk@Bolk ~$ wget -O- --user-agent="Opera/9.80 (Macintosh; Intel Mac OS X 10.8.2) Presto/2.12.388 Version/12.12" /files/opera-mystery/
--2013-01-22 00:24:09--  /files/opera-mystery/
Resolving bolknote.ru... 91.230.61.15
Connecting to bolknote.ru|91.230.61.15|:80... connected.
HTTP request sent, awaiting response... 200 OK
Length: 0 [text/html]
Saving to: ‘STDOUT’

    [ <=>                                                                                                                                                   ] 0           --.-K/s   in 0s

2013-01-22 00:24:09 (0.00 B/s) - written to stdout [0/0]
Когда догадаетесь где тело страницы, переходите на уровень два — догадайтесь откуда берётся картинка.
Поиск пропусков в таблице
У нас тут сегодня на работе возникла гипотетическая потребность найти пропуски в конкретной таблице базы данных. Так как я кроме как с MySQL в последнее время ни с чем не имел, прикинул как бы я решил эту задачу там. Получилось
SELECT id FROM (
    SELECT id, id-@prev AS diff, @prev:=id
    FROM
        (SELECT @prev:=NULL) ``,
        sourceofdata
   ORDER BY id
) `` WHERE diff>1
Внутри есть напрасный запрос «SELECT @prev:=NULL», который там только затем, чтобы решение получилось в одну строку.
Может
ASCII art vs. Unicode art
С приходом цветного Юникода некоторые символы могут присутствовать в системе в так называемом «стиле эмодзи», проще говоря в цвете.
«Мак» уже пару версий назад начал их показывать, я слышал, что и Винзоуз тоже
Как бы там ни было, я решил попробовать, что будет, если уменьшить доступные цветные символы до одного пискеля (чтобы остался только преобладающий цвет) и порисовать таким образом картинки в браузере. Получился бы такой
Забегая вперёд, картинка того что вышло из этой затеи — ниже. Cправа — исходник картинки, слева — Юникод, то есть, каждый пиксель этой картинки — один цветной символ Юникода, написанный (или тут надо уже говорить «нарисованный») шрифтом размером 1px.
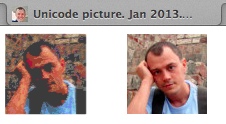
Для начала я выяснил, что единственный браузер на «Маке», который показывает эти символы в цвете, это «Сафари», остальные показывают в лучшем случае в ч/б («Файрфокс», «Хром»), в худшем показывают
Дальше я собрал доступные цветные символы и вывел их в Сафари с размером шрифта в один пиксель и шагом в пять. Шаг нужен, чтобы символы не влияли друг на друга — разводы антиалиасинга выходят за контейнер с буквой и портят соседние символы. Получилась такая картинка:
На «баше» (ну да, я извращенец, но так просто быстрее было) накидал небольшую программу, который из этой картинки генерирует текстовый файл, состоящий из номера символа по порядку и значения цвета в формате #rrggbb:
#!/bin/bash
FILE='color-map.png'

wh=(`file $FILE | grep -oE '\S+ x [0-9]+'`)

function ColorAt {
    convert $1[1x1+$2+$3] txt: | grep -oE '#[0-9A-F]{6}'
}

for (( y=0; y<${wh[2]}; y+=5 )); do
    for (( x=0; x<${wh[0]}; x+=5 )); do
        pos=$(( $x/5 + $y*${wh[0]}/25 ))

        echo "$pos $(ColorAt $FILE $x $y)"
    done
done
Утилита convert, которая используется в скрипте, это часть пакета ImageMagick.
Дальше всё просто, проходим попиксельно по картинке и берём самый близкий цвет, который у нас только есть (формула простая — минимум суммы разностей каждого компонента цвета: красной, зелёной и синей), эту часть я писал на ПХП.
$cached = [];

for ($y = 0; $y<$h; $y++) {
    for ($x = 0; $x<$w; $x++) {
        $cnum = imagecolorat($im, $x, $y);

        if (isset($cached[$cnum])) {
            $outchar = $cached[$cnum];
        } else {
            $mindiff = $outchar = INF;

            $c = imagecolorsforindex($im, $cnum);
            foreach ($colors as $colorandch) {
                list($ch, $r, $g, $b, $ch) = $colorandch;

                $diff = abs($r - $c['red']) + abs($g - $c['green']) + abs($b - $c['blue']);

                if ($diff < $mindiff) {
                    $mindiff = $diff;
                    $outchar = $ch;
                }
            }
            $cached[$cnum] = $outchar;
        }
        echo '<b>', $outchar, '</b>';
    }
}
Я тут ещё кеширую уже найденные цвета,
Если читателям интересно будет, выложу весь пакет. Правда, практического применения, видимо, никакого, мне интересно было сделать и помотреть хватит ли цветов для узнаваемости картинки.
Сокращение ссылок через bit.ly из bash
На «Макрадаре» появилась статья про сокращение ссылок через bit.ly через «Автоматор», хорошая штука, иногда бывает нужно, когда кривой парсер
Вот мой вариант:
TOKEN=<ваш токен, полученный по инструкции выше>
URL="$1"

[[ "$URL" =~ ^https?:// ]] || URL="http://$URL"

path="${URL#*//*/}"
host="${URL:0:${#URL}-${#path}}"
path=$(echo -n "$path" | hexdump -ve '1/1 "x%02X"' | tr x %)

curl 'https://api-ssl.bitly.com/v3/shorten' \
     --data "access_token=$TOKEN" \
     --data 'format=txt' \
--data "longUrl=$host$path"Неразборчиво в ОБД «Мемориал»
Я думал, что в ОБД «Мемориал» записаны данные только тех карточек, данные которых удалось разобрать достоверно. Случайно выяснил, что очень много данных с пропусками.
Решил написать сканер неполных данных, чтобы не перебирать их руками. Никого из родственников, правда, не нашёл, но мало ли, пригодится ещё.
&^ в Google Go
Отличная иллюстрация того как важны мелочи в документации…
Читал чужой исходный код на «Гоу» и обнаружил необычную конструкцию:
v &^= 1 >> nПочесал голову, не понял что это и пошёл читать документацию. Выяснилось, что эту конструкцию я
package main

func main() {
    var test byte = 250

    println(test) // 250 (11111010)

    test = ^test
    println(test) // 5 (00000101)

    test &^= 4   //    (00000100)
    println(test) // 1 (00000001)
}Алгоритм линейного счётчика на Google Go (golang)
Не смог отказать себе в удовольствии и попрактиковаться в «Гоу», написал и выложил на Гитхаб реализацию алгоритма линейного счётчика на Гугл Гоу. Значения, которые надо подсчитать поступают на стандартный вход, есть один параметр командной строки — «size», позволяющий задать размер вектора в битах

Подсчёт на моём ноуте одного миллиона уникальных значений занимает примерно 6,5 секунд. Погрешность с вектором длиной 100 тысяч бит (≈3КиБ) — 7,6%.
Чтобы скомпилировать программу новым (версии 1 и выше) компилятором «Гоу», нужно запустить следующую команду:
go build linear-counter.goАлгоритм линейного счётчика: десять бит в одном бите
Простите за «жёлтый» заголовок, но алгоритм, если не разобраться, похож на магию и мне очень хотелось бы привлечь ваше внимание к нему. Впрочем, я детально в нём разобрался, но всё равно радуюсь, как ребёнок.
Упомянул его в разговоре знакомый математик К.Н., за что ему большое спасибо! По этому алгоритму нашлась замечательная статья «Линейный счётчик», с понятным объяснением, добавить к которому нечего, но я
Сначала для чего алгоритм применяется и чем он замечателен.
Представьте, что вам нужно посчитать количество уникальных значений в огромном объёме данных, если вам это нужно сделать точно, то выбора особого нет — нужно будет сохранять все поступающие значения в память и проверять, не встретили ли мы уже их. Если уникальных значений очень много, это может съесть всю нашу память, но выбора, повторяю нет.
Если же вам годится и приблизительная оценка, можно использовать хеширующую функцию, тогда
Но есть способ лучше! Алгоритм линейного счётчика.
Оказывается, если взять вектор в 1000 бит и 1000 раз установливать в нём в единицу случайный (с равномерным распределением) бит (некоторые биты будут установлены в единицу несколько раз), то нулей останется примерно около 370. Эта оценка получается из 1/e ≈ 0,36787944117… ≈ 0,37, подробнее есть в другой статье на том же сайте.
Таким образом, если мы встречаем битовый вектор длины n, в котором примерно 63% (100 − 0,37 × 100 = 63) единиц, то над этим вектором было произведено n операций установки бита в единицу, при условии, что биты выбирались случайно и равномерно.
Отсюда, если взять битовый вектор достаточной длины, хешировать входные значения

Хорошо это работает только на больших числах, я для наглядности сделал небольшое демо работы алгоритма линейного счётчика, там пятьдесят входных значений и вектор размером в 30 бит. Так как чисел немного, то и результаты иногда скачут сильно, но на миллионах значений погрешность выравнивается.
Список доменов, запрещённых к регистрации в зоне «.рф»
Оказывается существует список доменов, которые запрещено регистрировать в зоне «.рф». Полюбопытствуйте, расширьте свой словарный запас! Старательные люди собирали, там более четырёх тысяч доменов. Например, «взятьзамягкоеместо.рф» или «похабник.рф».
Вот вам ругающийся однострочник на «баше», чтобы учить каждый день новое слово:
curl -so- http://flisti.ru/stop-list.txt |
iconv -f cp1251 | awk -F'[\t\.]' 'BEGIN {srand()} $3 {print rand(), $3}' |
sort -n | awk '{print $2; exit}' | tee >(cut -c1 | tr '[:lower:]' '[:upper:]') |
sed -n '1s/^.//;1h;2p;2g;2p' | tr -d '\n' ; echo '!'
Или можно так:
curl -so- http://flisti.ru/stop-list.txt | iconv -f cp1251 |
awk 'BEGIN {srand()} {print rand()"."$2}' |
sort -nt. | head -1 | cut -f2 -d. |
tee >(cut -c1 | tr '[:lower:]' '[:upper:]') | tail -r | tr -d '\n' | xargs -I? echo ?! | cut -c1,3-
Его можно сильно упростить, если выкинуть часть, которая отвечает за изменение регистра первой буквы (заодно будет работать не только в «баше»):
curl -so- http://flisti.ru/stop-list.txt |
iconv -f cp1251 | awk -F'[\t\.]' 'BEGIN {srand()} $3 {print rand(), $3}' |
sort -n | awk '{print $2"!"; exit}'
Вариант для «баша», но без awk:
curl -so- http://flisti.ru/stop-list.txt |
iconv -f cp1251 | grep -Eo '\s.+рф' | cat -b |
tee >(echo $((`wc -l`*$RANDOM/32768))) | tail -r |
grep -w `head -1` | cut -f3 | cut -d. -f1 | xargs -I? echo ?!Финализированные конструкторы под разными именами
Вчера вечером подумалось, что если в PHP сделать следующее, будет ошибка или нет:
class A {
    final public function a() {
        echo 1;
    }
}

class B extends A {
    public function b() {
        echo 2;
    }
}

$o = new B();
Интересно тут то, что не сразу видно в чём вообще загвоздка. Ну или я бы увидел не сразу, думаю, если бы сам этот пример не придумал. Кажется, все уже отвыкли в PHP от «старых» конструкторов, где конструктором считается метод, имя которого совпадает с именем класса (если нет метода «__construct»).
От осознания этого факта дополнительно отвлекают ничего незначащие имена классов и методов.
Проблема же в том, что в первом классе конструктор финализирован, его дальше переопределять нельзя. Но у второго класса имя конструктора другое. Вот и вопрос — что будет? От PHP можно чего угодно ожидать.
Тем не менее, тут язык выдаст логичную ошибку, которая, правда, способна вызвать лёгкое недоумение своей формулировкой:
Fatal error: Cannot override final A::a() with B::b() in test.php on line 12«Чистый веб» Яндекса
У «Яндекса»
Остался ли там
Скрипт для перевода даты из старого стиля в новый
Часто перевожу даты из  календаря в григорианский (со старого стиля на новый), так как занимаюсь исследованием своих предков. Устал использовать для этого всякие
function Jul2Greg(day, month, year) {
    // «сахар» для создания даты
    var d = function(day, month, year) {
        return new Date(year, month - 1, day, 12, 12, 12);
    }

    var date = d(day, month, year);

    // коррекция дней исходя из года
    var correction = date <= d(28, 2, 1700) ? 10 : 0 | (year / 100 - 17 + 11);

    // корректируем левый конец диапазона
    if (year % 100 == 0 && month < 3) {
        correction--;
    }

    return d(day + correction, month, year);
}Генерируемый задний фон
Я
10 PRINT CHR$(205.5+RND(1));: GOTO 10Выводит вот такой фон (скриншот с «Командора 64», поэтому цвета такие):
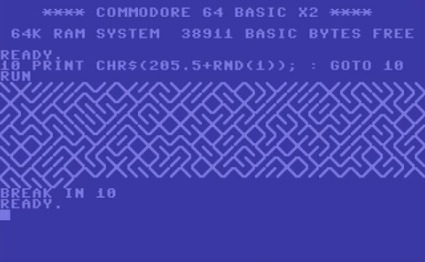
Для тех, кто не понимает этот архаичный язык, перепишу на Пайтоне:
import random; while 1: print random.choice(u'╱╲'),и ПХП:
for(;;) flush(print '/\\'[mt_rand(0, 1)+.5]);На «Хабре» статья пробегала, где автор пытался сделать то же при помощи CSS, не справился и сделал генерацию на серверной стороне — на PHP. Он высказывал мысль использовать для этого JS, но то ли не смог, то ли отбросил её
В общем, решил я попробовать сделать это на стороне клиента, на «канвасе», заодно посмотреть конструкции, которые позволяют ставить «канвас» в качестве задника, давно руки чесались.
Сначала результат (в левом верхнем углу фрагмент нормального размера):
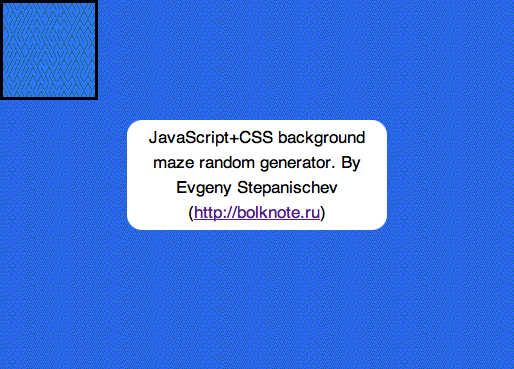
Теперь посмотрим код. Я убрал всё лишнее, подробности можно посмотреть в разделе «Храню»:
!function(c) {
    var ctx = document.getCSSCanvasContext ?
        document.getCSSCanvasContext("2d", "maze", c.width, c.height):
        c.getContext("2d");

    ctx.font      = "10px monospace";
    ctx.fillStyle = '#36f';
    ctx.fillRect(0, 0, c.width, c.height);

    ctx.fillStyle = '#068';

    for (var y = 7, ly = c.height; y < ly; y += 8) {
        for (var x = -1, lx = c.width; x < lx; x+= 4) {
            ctx.fillText("/\\".charAt(Math.random() + .5), x, y);
        }
    }

    if (!document.mozSetImageElement && !document.getCSSCanvasContext) {
        document.getElementsByTagName('body')[0].style.backgroundImage='url(' + c.toDataURL("image/png") + ')';
    }

}(document.getElementById('maze'));
Внутрь функции у меня передаётся объект «канваса» (размером 99×96, подогнан под шрифт).
В первой строке проверяется наличие метода «getCSSCanvasContext», он работает только в браузерах, основанных на Вебките (Хром, Сафари) и позволяет напрямую использовать «канвас» для задника, нужно только в CSS указать идентификатор:
body { background: -webkit-canvas(maze); }Если этот метод недоступен, то я рисую в скрытый тег «канваса», который есть у меня на странице. Вывожу те же самые символы, которые использовались в Бейсике.
Связь «канваса» и задника для браузеров на «Геко» (ФайрФокса и менее известных) в Джаваскрипте не видна, она полностью на стороне CSS:
body { background: -moz-element(#maze); }Эти браузеры позволяют указать в качестве задника что угодно — хоть IFRAME, был бы у него идентификатор. Соответственно, «maze» — идентификатор моего «канваса». Делать больше ничего не нужно, любой элемент с этим «айди» размножится в качестве фона.
В последних строках я проверяют доступен ли метод для указания «-
Масштабирование тега CANVAS
Думаю, многие знают, что у тега CANVAS можно задать размер, а потом смасштабировать его до нужных размеров при помощи CSS.
<canvas width="10" height="10" style="width:100px; height:100px"></canvas>В этом случае, он не меняет свой размер, доступный из кода, но на экране растягивается или сжимается до указанных величин. Иногда это бывает полезно, но есть недостаток — все браузеры, в которых я это пробовал, сглаживают («размывают») содержимое этого тега, что иногда нежелательно.
У меня нет возможности посмотреть под всеми распространёнными версиями браузеров, но, как выяснилось в эксперименте, с современными работает такой трюк, можно указать алгоритм масштабирования для изображений, который для «канваса» тоже работает:
canvas {
    image-rendering: optimizeSpeed; /* old WebKit, Safari, FireFox 3.6+ */
    image-rendering: -webkit-optimize-contrast; /* newer WebKit (CSS3 proposal) */
    image-rendering: -o-crisp-edges; /* Opera 11.6+ (CSS4 prefixed) */
    image-rendering: -moz-crisp-edges; /* FF 6+ (CSS4 prefixed) */
    image-rendering: crisp-edges; /* CSS4 */
}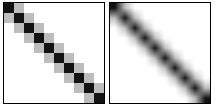
Чтобы была понятно о чём вообще речь — слева на скриншоте версия без сглаживания (с применёнными стилями), справа — со сглаживанием, это я прочертил одну линию:
with (canvas.getContext('2d')) {
        moveTo(0, 0);
        lineTo(10, 10);
        stroke();
    }
Я снабдил код комментариями, чтобы было видно где это работает. К сожалению, в Эксплорере ничего не получится,
Добавлено позднее: похоже, у Хрома тоже проблемы. На разных ОС может работать или нет.
Теннис на CSS-анимациях
Я тут решил прикинуть для себя недостатки CSS-анимации, поэтому написал «теннис» на HTML и CSS. В кавычках, потому что играть в него невозможно: можно лишь управлять при помощи мышки «ракеткой», а шарик в этот момент будет летать из угла в угол, ни на что не реагируя.
Я было начал писать программу, которая рассчитает мне более длинную траекторию мяча, чтобы соударения выглядели повеселее, но поленился обработать все восемь комбинаций соударения, хотя вспомнить тригонометрию было весело.
Префиксы для всех браузеров в коде ставить не стал, оставил только для «вебкита» (будет работать в «Сафари», «Хроме» и «Яндекс.Браузере»), всё равно все браузеры собираются начать их поддерживать, так зачем же стараться?
Так вот, анимации в ЦСС — интересная штука, позволяющая простыми средствами плавно менять свойства объектов на странице, мне понравилось. Но у неё есть недостаток, на мой взгляд — анимируется ровно один элемент и у неё нет состояний.
Т. е. я не могу посмотреть в каком состоянии сейчас находится анимированный элемент, чтобы привязать к этому событию
По этой причине я не смог написать полноценный теннис — у меня просто нет средств, чтобы связать между собой положение мяча и ракетки.
Из других найденных недостатков — далеко не все свойства нормально анимируются, например, с фоновыми картинками
Кстати, гениальные ребята, которые для Интернет Эксплорера
Наведение порядка в PHP (версия 5.5.0)
Нужно ещё похвалить авторов PHP за то, что они действительно стараются навести порядок в языке. С каждой версией он становится немного логичнее.
Например, теперь уже можно сделать вот так:
[
    POW => function($x) { return $x*$x; },
    SIN   => function($x) { return sin($x); },
][$selector]
Правда, всё ещё нельзя вызвать функцию сразу. В 5.5.0 будет работать вот такая вещь:
if (empty(somefunc())) { /* … */}Но то же самое нельзя сделать с isset, так как сложно сказать что это будет значить — в языке нет отдельного неопределённого значения переменной, она бывает только недекларированной; функция, конечно, может её вернуть, но на самом деле вернётся NULL, а isset от значения NULL — «ложь».
Появилась возможность использовать list внутри цикла следующим образом:
foreach ($somehash as list($key, $value)) { /* … */ }И сделано ещё несколько мелочей, но работы впереди ещё много.
Генераторы в PHP 5.5
Самым большим нововведением (и очень важным для языка) в PHP 5.5.0 будут генераторы. Я установил себе
Посмотрите на код, который я написал, пока мы ждали всех участников встречи, на которую я был приглашён:
<?
function enumerate($arr)
{
    $i = 0;

    foreach ($arr as $value) {
        yield [$i++, $value];
    }
}

function ifilter(callable $predicate = null, $arr)
{
    if ($predicate === null) {
        $predicate = 'boolval';
    }

    foreach ($arr as $value) {
        if ($predicate($value)) {
            yield $value;
        }
    }
}

function islice($arr, $start, $stop)
{
    if (is_array($arr)) {
        reset($arr);

        for ($i = $start; $i > 0 && each($arr); $i--);

        for ($i = $stop - $start + 1; $i > 0 && list(,$value) = each($arr); $i--) {
            yield $value;
        }
    } else {
        for ($i = $start; $i > 0 && $arr->valid(); $i--) {
            $arr->next();
        }

        for ($i = $stop - $start; $i > 0 && $arr->valid(); $i--) {
            yield $arr->current();
            $arr->next();
        }
    }
}

$array = [10, 20, 30, 33, 40, 50, 60];

$gen = islice(
    enumerate(
        ifilter(
            function($x) { return ($x % 10) === 0; },
            $array
        )),
        1, 4
    );

foreach ($gen as $value) {
    print_r($value);
}
Три генератора, пропускающие через себя данные, обрабатывают массив, всё работает. Названия взяты из Пайтона. Первый нумерует входящий поток данных (возвращает пары номер и значение), второй фильтрует значения через функцию, третий отрезает заданную часть от входных данных.
Концепция генераторов проста, как герань. PHP поддерживает два способа их создания (как и Пайтон), но мне милее оператор yield. Работает он примерно как return, но при повторном входе в функцию её выполнение происходит не сначала, а с того места, откуда управление было возвращено при помощи yield. Можно ещё передавать значения внутрь генератора, но я про это сейчас не буду. Вцелом, получаются настоящие ленивые вычисления — всё это вызывается ровно тогда, когда это реально нужно.
Генераторы, обычно, работают с итерируемыми объектами — возращают их и/или принимают. Итерируемый объект, проще говоря, это то, по чему можно пробежаться циклом. Генераторы, кстати, тоже итерируемые.
И вот тут опять проявляются недостатоки PHP: отсутствие общей логики, непродуманность.
Массив тут до сих пор примитивный тип и он требует иной способ обработки. Посмотрите на генератор islice, тут проблема видна во всей красе. Начинается она уже с хинтинга, я не могу потребовать от $arr быть типа array, потому что на вход может прийти другой генератор, и указать класс генератора тоже не могу — массив ему не принадлежит. Думаю, следует ожидать появления нового типа «iterable», как это уже случилось с callable.
Вторая проблема ещё более серьёзная. У массива нет методов (он же примитивный тип), а генераторы,
Мне кажется, PHP следует развивать класс ArrayObject, который уже присуствует в языке и делать прозрачное преобразование примитивных типов в объекты (как это происходит в JavaScript), это решило бы некоторые проблемы.