юникод
Поддержка Юникода во «Флиппере Зеро»
Если помните,
Видно, что авторы не подумали о поддержке Юникода, поэтому он там работает
Ситуацию можно было бы немного улучшить простым патчем — надо всего лишь поменять в функции canvas_glyph_width тип входного параметра с char на uint16_t (эта функция возвращает ширину символа в пикселях) и она начнёт работать с кодировкой
Две недели назад я подумал — почему бы не попробовать предложить этот патч авторам прошивки. Если не примут, то может быть хоть в дискуссию вступят, всё польза. Скачал разработческую версию ядра, сделал правку и закинул патч.
Сегодня патч приняли без лишних слов. Вот это да, не ожидал! Справедливости ради, это небольшое изменение, которое не должно ничего сломать. Теперь хорошо бы подумать как сделать так, чтобы в остальном АПИ поддержка Юникода заработала. А там, кажется, малой кровью не обойдёшься.
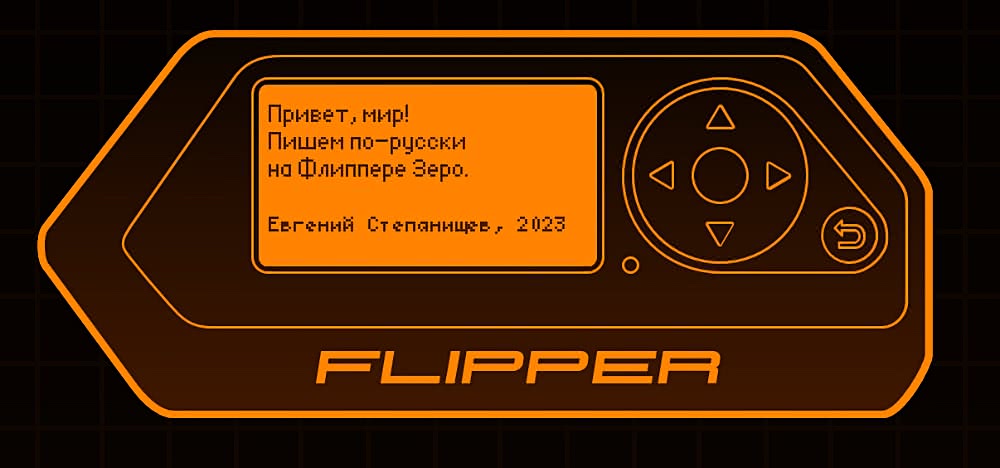
Пишем на «Флиппере Зеро» по-русски
★
Вкратце: в русским текстом работать можно, но сложно, код лежит на «Гитхабе».
Не мог не обратить внимание, что несмотря на приличное количество русскоязычных авторов программ для «Флиппера Зеро» и российское происхождение устройства, в софте под него нигде не обнаружилось ни одной буквы
Стало интересно — а есть ли вообще в устройстве поддержка русского языка? Сел вечерком за исходники прошивки и оказалось, что однозначного ответа на заданный вопрос нет. Частичная поддержка есть и её можно заставить работать, но она работает как будто по недосмотру — никто её не собирался делать, так случайно вышло.
Сейчас расскажу, что я имею ввиду и постараюсь покороче, никто сейчас не любит длинные тексты.
Внутри «Флиппера» довольно много всякого АПИ для вывода текста, от незатейливого, выводящего строку в заданные координаты, до довольно навороченного, умеющего переносить и выравнивать текст. К сожалению, с русскими буквами оно работать не умеет.
Под капотом у этого АПИ — очень известная в своей нише библиотека U∞g2, у которой по историческим, видимо, причинам есть два набора функций для работы со строками. Одни принимают только однобайтовую кодировку ASCII, другие работают в Юникоде.
АПИ «Флиппера», к сожалению, использует функции, которые с Юникодом работать не умеют. К счастью,
Первый из них — canvas_set_custom_u8g2_font.
Чтобы
Вот как я это делаю:
#include <u8g2/u8g2_fonts.c>
// …
canvas_set_custom_u8g2_font(canvas, u8g2_font_haxrcorp4089_t_cyrillic);
Файл u8g2/u8g2_fonts.c внутри себя содержит шрифты в особом формате, можно открыть его прямо в текстовом виде и посмотреть как всё устроено.
Шрифт мы выбрали, теперь надо
Плохая новость в том, что строки в коде мы обычно пишем в кодировке
Но canvas_draw_glyph, как можно понять из названия, выводит только один символ. Как же вывести строку? Достаточно просто — надо вывести её посимвольно, сдвигая координату на ширину символа. Звучит просто, но как это сделать?
Тут нас ждёт очередная засада. Дело в том, что canvas_glyph_width, которая должна бы это делать, принимает на вход только char, при том, что нижележащая u8g2_GetGlyphWidth преспокойно работает с Юникодом.
Поэтому я сделал просто — выдрал реализацию u8g2_GetGlyphWidth себе в исходники. В итоге мякотка моего решения выглядит вот так:
void unicode_draw_utf8_str(Canvas* canvas, uint8_t x, uint8_t y, char* str) {
    FuriStringUTF8State state = FuriStringUTF8StateStarting;
    FuriStringUnicodeValue value = 0;

    for(; *str; str++) {
        furi_string_utf8_decode(*str, &state, &value);
        if(state == FuriStringUTF8StateError) furi_crash(NULL);

        if(state == FuriStringUTF8StateStarting) {
            canvas_draw_glyph(canvas, x, y, value);
            x += unicode_GetGlyphWidth(&canvas->fb, value);
        }
    }
}
Тут unicode_GetGlyphWidth — скопированная реализация u8g2_GetGlyphWidth, а furi_string_utf8_decode используется для кодирования
«⠀» (Braille Pattern Blank)
Недавно один из символов Юникода немного потрепал мне нервы — в одном из структурированных файлов, содержащих пользовательский ввод встретилось
Случаи, когда
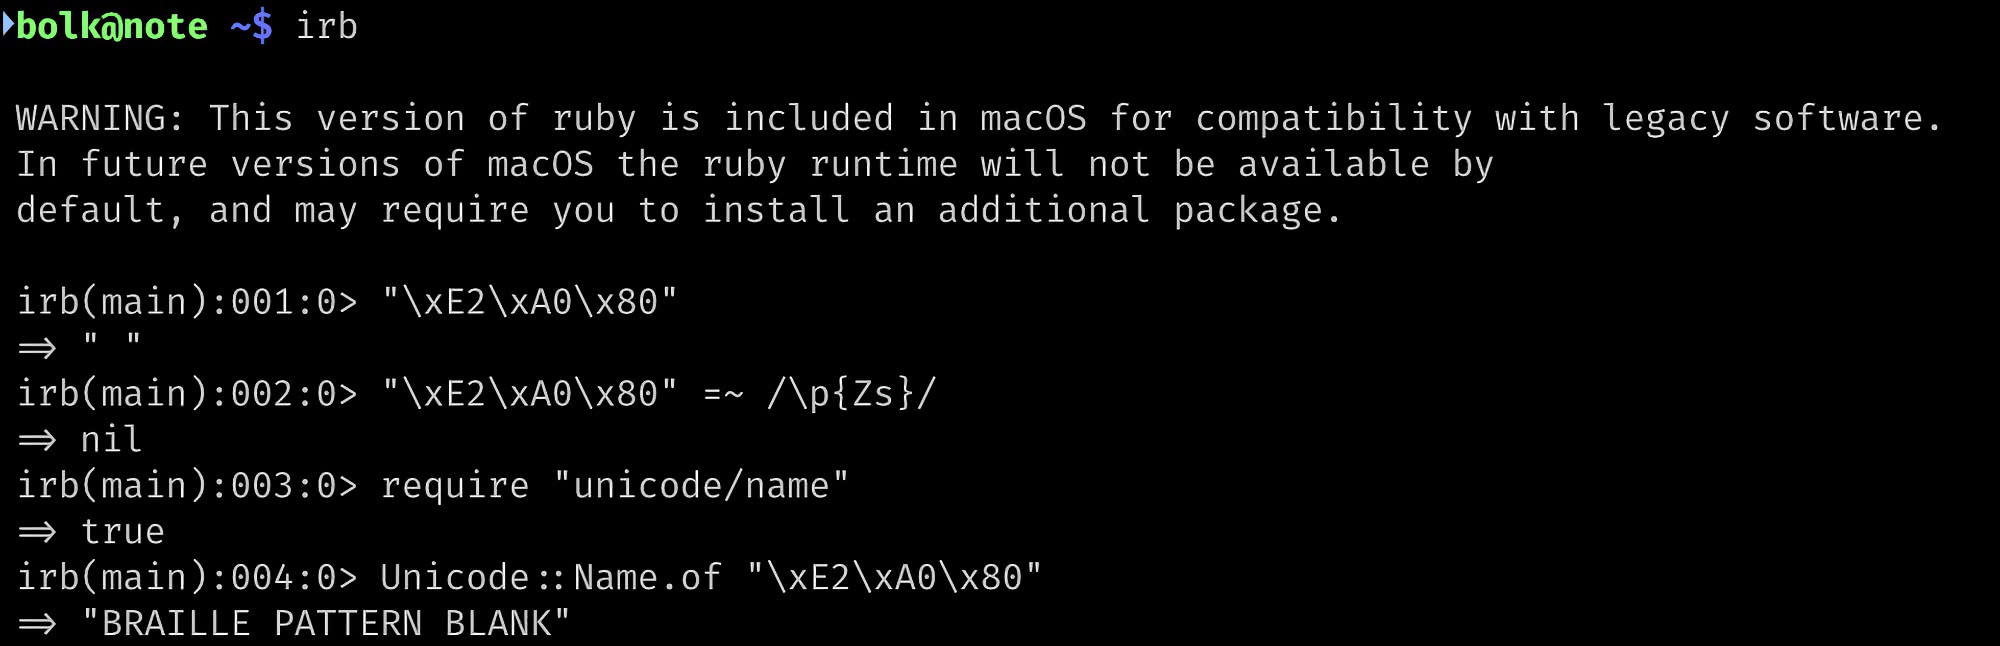
Вот и в этот раз
Этот пробел — странный символ, библиотеки для работы с Юникодом не считают его пробельным, но во многих шрифтах он визуально неотличим от пробела. Как его ввёл пользователь — непонятно, может случайно через
Библиотека libiconv конвертировать его отказалась, хотя, как по мне, он вполне может быть сконвертирован в обычный пробел, что мы теперь и делаем.
Политкорректный Unicode 8
Я всё ждал, когда это появится, и вот наконец в восьмом Юникоде обнаружились модификаторы цвета кожи. Модификаторов в Юникоде — пруд пруди, это специальные символы, которые сами по себе ничего не значат — они привносят
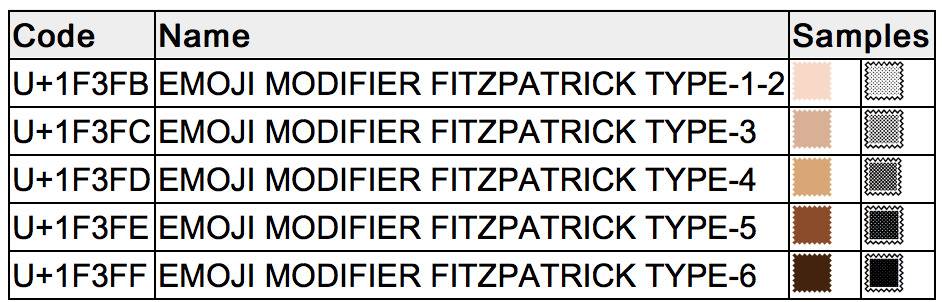
Вот восьмой Юникод вводит модификаторы цвета (на картинке выше), при комбинировании с которыми цветные «эмоджи», которые уже давно входят в Юникод, могут менять свой цвет:
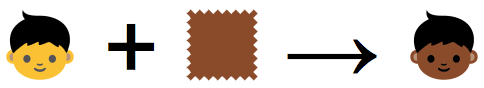
Юникод всё усложняется и усложняется, чувствую, однажды они придут
I � Unicode
Давайте я вам про Unicode ещё раз расскажу?
Как известно, в памяти компьютера числа представлены битами, которые группируются в байты. Один байт может хранить одно из 256 значений (поскольку состоит из восьми бит, каждый из которых может хранить одно из двух). Следовательно, числа, значения которых > 255 хранятся в больше, чем одном байте.
Например, числа до 65535 можно уместить уже в двух байтах: в так называемом старшем записывается сколько раз полных 256 содержится в числе, а в младшем — остаток: старший × 256 + младший.
В зависимости от типа процессора, порядок, в котором записаны в памяти старшие и младшие байты, различается. Собственно, мне хорошо известны только две системы: младший записывается первым (как в процессорах Intel) и старший записывается первым (в процессорах ARM, которые стоят в смартфонах). Есть ещё смешанная, но с ней я не сталкивался. Системы эти носят имена:
Есть ещё системы, которые умеют переключать порядок (те же ARM) и называются
Термины
Сюрприз для непрограммистов: буквы в памяти компьютера тоже представлены числом. Это просто номер по порядку в компьютерном алфавите. Так девочки в нашем классе «кодировали» записки: вместо букв ставили номер позиции в алфавите.
Было принято очевидное решение — выделять на символ не один байт, а несколько. Так появился стандарт Unicode, где огромному количеству символов дано своё число и закреплены начертания, стандарт дополняется и новые версии выходят почти каждый год.
Система кодирования Unicode, где выделяются два байта, называется
Так как способов хранения чисел, не умещающихся в памяти у нас несколько, то системы подразделяются
Первого апреля
BOM. BOM расшифровывается как «byte order mark» (признак порядка байт) и ставится внутри файлов упомянутых двух- и четырёхбайтных кодировок. Если BOM внутри файла не встретился, принимается порядок
Теперь непрограммистам будет трудно.
Пока всё было достаточно просто, но человечество придумало ещё одну кодировку —
Трудность в том, что
Итак. Каждый символ в кодировке занимает от 1
Тут надо вспомнить что такое биты. Бит — единица информации, мельче не бывает, у него всего два значения — 0 или 1. Байт состоит из 8 битов, биты очень удобно записывать в позиционной двоичной системе: 00001011. «Позиционная» тут означает, что значение числа зависит от его позиции. Кстати, это привычная нам система. В числе «22» две двойки, но у первой значение в десять раз больше, чем у второй. Это десятичная позиционная система. В двоичной, каждая более левая однёрка будет больше в два раза своей соседки.
Таким образом число 1011 расшифровывается из двоичной как 1 × 23 + 0 × 22 + 1 × 21 + 1 × 20 = 1 × 8 + 1 × 2 + 1 × 1 = 8 + 2 + 1 = 11 в десятичной системе.
В первом символе нужно посчитать количество бит со значением «1» до первого нуля. Это общее количество байт, которым записан данный символ. Если количество байт — один (это вроде как специальный признак), то вы нашли не первый байт символа.
У нас в примере количество бит до первого нуля — два. Значит, буква записана двумя символами — первый это тот, на которым мы находимся и второй — который следует за ним. Каждый байт
Могу рассказать
Интересный символ в Unicode
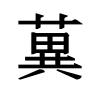
Как вы думаете, если ли в Unicode символ однолетного травянистого растения из семейства шелковичных, который большая часть альтернативно настроенных к обществу подростков носит в виде узнаваемого символа, а некоторые даже и пробовали курить?
Естественно, символа, в упомянутой мной узнаваемой форме, нет. И не будет. Но на планете Земля есть иерогифические языки, где многие базовые слова состоят из одного символа. В Unicode эти символы нужно включать. Так вот. Альтернативно настроенным повезло — в таблице есть символ, который в переводе обозначает это упорно неназываемое мной слово. Его же можно увидеть на картинке слева.