sectorc
Ещё о печати строк в SectorC (лонгрид)
Недавно познакомился с интересным компилятором подмножества языка Си — SectorC. Он интересен тем, что влезает в один сектор (512 байт), но позволяет писать вполне реальные программы. В реализованном языке очень многого нет, тем не менее, это очень интересное достижение и мне было интересно поразбираться как всё сделано. Кстати, результат автора мне удалось в несколько приёмов уменьшить на несколько байт.
Для того, чтобы рассказать в чём смысл, надо для начала немного углубиться в то как работает этот компилятор.
Компилятор, когда разбирает код, делит его на токены по пробелу, после каждый токен хешируется функцией atoi в двухбайтовое число и уже по нему определяется является ли встреченное ключевым словом языка, либо именем функции или переменной.
В последнем случае, имя, преобразованное в число, будет в машинных кодах использовано как смещение, указывающее на ячейку со значением переменной или с указателем на тело функции.
Отсюда следует, что последовательно называющиеся переменные — a, b, c и так далее, с будут в памяти располагаться последовательно со смещением в два байта, точностью до переполнения. При этом их даже не обязательно определять — переменная с любым именем существует с начальным нулевым значением.
Идём дальше.
В языке есть любопытная операция — &, позволяющая получить адрес переменной, который, напомню, равен одновременно хешу (atoi) к её имени. Для однобуквенных имён это позволяет по полученному адресу восстановить код символа — надо поделить полученное значение на два и добавить 48 — код символа 0.
Таким образом, передав в функцию адреса & H, & e, & l, & l, & o, мы сможем восстановить из них символы и составить из них слово Hello. Если записать эти адреса в переменные, которые располагаются в памяти подряд, можно, читая память последовательно, выводить закодированную строку.
Есть ли в языке способ прочитать
Теперь всё вышесказанное можно соединить в следующий довольно компактный код:
void print_str()
{
    print_str_pointer = & _0;
    while( *(int*) print_str_pointer ){
        print_ch = ( *(int*) print_str_pointer >> 1 ) + 48; print_char();
        print_str_pointer = print_str_pointer + 2;
    }
}

void main()
{
    _0 = & H; _1 = & e; _2 = & l; _3 = & l; _4 = & o; _5 = 0;
    print_str(); // Hello
}return в SectorC
Вчера перед сном пришло в голову, что один из недостатков языка SectorC, — отсутствие конструкции return, можно отчасти компенсировать средствами самого языка. Достаточно написать функцию return(), которая будет делать две вещи — возвращать значение (об этом ниже) и прерывать выполнение функции из которой её вызвали.
Я уже достаточно знаю об его внутренностях, чтобы понимать как это можно сделать.
Второе реализовать совсем просто, тут мне помогает некогда богатый опыт программирования на Ассемблерах. SectorC транслируется напрямую в машинный код, а значит адреса возвратов из функций хранятся на стеке. Так что надо всего лишь удалить верхний адрес возврата и мы вернёмся не в функцию, которая нас вызвала, а на уровень выше. Я делаю это командой pop ax.
Теперь посмотрим на первую задачу.
Как я уже писал язык устроен так, что присваивание переменных друг другу происходит через регистр AX, таким образом, присваивая переменную самой себе, мы помещаем её в этот регистр. Этот факт используется в стандартной библиотеке языка, так что можно считать, что это стабильное поведение.
Напрашивается следующая реализация, — перед вызовом присваиваем возвращаемую переменную самой себе, в функции return() записываем содержимое AX
Моя реализация вместе с примером использования ниже:
void return()
{
    // mov [&return], ax
    asm 163; asm 236; asm 229;
    // pop ax (clear stack from prev return address)
    asm 88;
}

void random()
{
    // xor ax, ax    int 0x1A         xchg ax, dx
    asm 49; asm 192; asm 205; asm 26; asm 146;
    // xor dx, dx    mov cx, 10
    asm 49; asm 210; asm 185; asm 10; asm 0;
    // div cx         inc dx  xchg ax, dx
    asm 247; asm 241; asm 66; asm 146;
    return();
}

void function()
{
    i = 0; while( i < 20 ){
        random();
        if( i >  return ){
            i = i; return();
        }
        i = i + 1;
    }

    i = 0; return();
}

void main()
{
    function();
    print_num = return; print_u16();
}
Кстати, возникает любопытный сторонний эффект — так как через AX делается не только присваивание, а вообще все операции, то функция return() захватывает любое последнее вычисленное выражение, что тоже может быть удобно.
Деление в SectorC
Очень неудобно, что в языке SectorC нет деления. Я сначала думал, что это
Но сегодня для интереса я попытался добавить в код новый токен для деления и оказалось, что места хватает. Закинул автору
Впрочем, SectorC устроен так, что в программе можно использовать машинные коды. Можно написать деление прямо в них, если воспользоваться ассемблером.
При этом надо знать две вещи: присваивание значения переменной происходит через регистр AX, так что присвоив переменную саму себе, можно записать в AX её значение, и второе — если посчитать atoi (см. мою вчерашнюю заметку) для имени переменной и умножить получившееся число на два, можно получить ячейку, где хранится значение этой переменной.
Так вычисленный результат можно будет положить куда вздумается.
Объединив всё вышесказанное, получим такой результат:
int div_a; int div_b; // input
int div_result;

void div()
{
    div_b = div_b;             // mov ax, [&div_b]
    asm 145;                   // xchg cx, ax
    asm 49; asm 210;           // xor dx, dx
    div_a = div_a;             // mov ax, [&div_a]
    asm 247; asm 241;          // div cx

    asm 163; asm 48; asm 193;  // mov [&div_result], ax
}

void main()
{
    div_a = 35500; div_b = 113; div();
    print_num = div_result; print_u16(); // «314»
}SectorCFuck
Очень интересно устроен разбор файла программы в компиляторе SectorC, который я ковыряю вечерами из любви к ненормальному программированию. Для тех, кто успел позабыть, напомню — этот компилятор занимает один сектор (512 байт) и способен выполнять программу на подмножестве Си.
Когда смотришь на код такого маленького объёма, сразу возникает вопрос — каким чудом удалось туда запихнуть грамматику языка Си, даже если
Автор использует реализацию функции atoi, которая превращает любые строки в шестнадцатибитное числа:
unsigned short sectorc_atoi(const char *s)
{
    unsigned short n = 0;
    for (;;) {
        char c = *s++;
        if (!c) break;

        n = 10 * n + (c - '0');
    }

    return n;
}
Все токены, которые встречаются в программе, обязательно разделяются пробелами (за исключением ;, для него есть специальная обработка). Это позволяет довольно просто парсить программу — любой токен скармливаем atoi, получаем число и по таблице смотрим с чем имеем дело.
Если в таблице число не находится, значит это переменная, её численное значение, умноженное на два, даёт двухбайтовую область памяти, где надо взять значение. Для чисел, видимо, есть
Перед запуском программа проходит через линтер, который не является частью компилятора. Он нужен для поиска ошибок в коде и коллизий в получившихся хешированных значениях. В последнем случае линтер останавливается с ошибкой, показывая хеши каких токенов совпали между собой.
Если линтер выключить, можно достигнуть интересного эффекта. Для каждого токена можно вычислить коллизию позаковыристей и написать всю программу без букв и цифр. SectorC как будто бы «из коробки» предназначен для запуска обфусцированного кода.
Ниже программа, выводящая «Hello» (её надо запускать без линтера):
<**^ ')'|] /=]
    -_.@" -[ )~( /@< $^+>\() /<'
    -_.@" -[ /<'' /@< $^+>\() /<'
    -_.@" -[ ,[~ /@< $^+>\() /<'
    -_.@" -[ +^^` /@< $^+>\() /<'
    -_.@" -[ /<(' /@< $^+>\() /<'
,[_
Я поленился и не стал рассчитывать разные значения для одинаковых токенов, которые упоминаются несколько раз, но можно сделать и это, тогда восстановление исходного текста будет безумно затратной задачей.
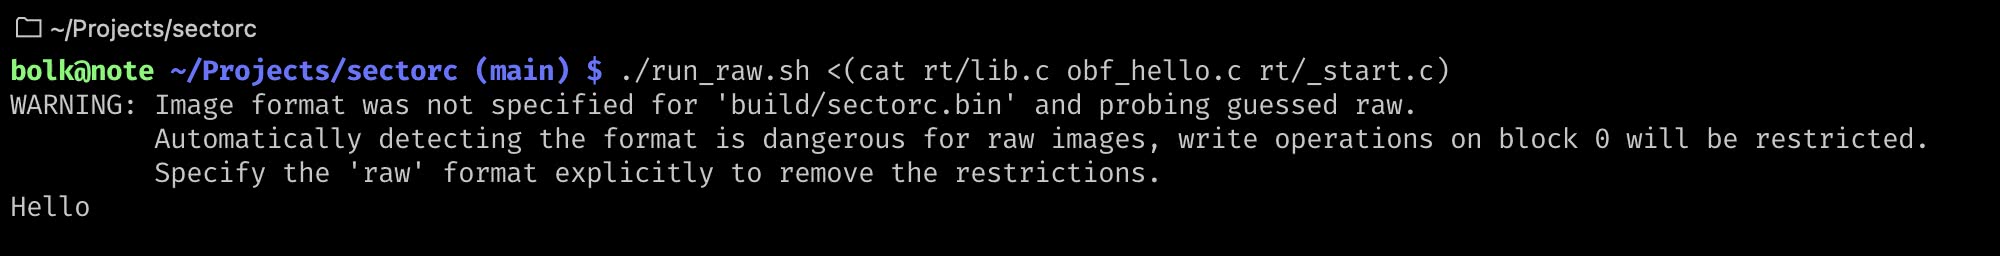
Обфусцированный таким образом листинг, запускающий файл и программу для поиска коллизий выложил на «Гитхаб», можно посмотреть подробности там.
Кстати, такое развлечение, когда мы не используем в программе
Свёртка строк на SectorC (лонгрид)
Вчера я обещал рассказать что я придумал, чтобы компактнее выводить строки в языке SectorC. Напомню, это компактный компилятор подмножества Си, который занимает один сектор (512 байт).
Для начала посмотрим что доступно в компиляторе для вывода текста. В самом языке для этого ничего нет, но если заглянуть в стандартную библиотеку языка, которая подключается автоматически, то можно увидеть там функции print_char(), print_u16() и print_i16(), предназначенные, соответственно, для вывода символа, заданного его кодом, целого числа без знака и целого числа со знаком.
Соответственно вывод «Hello» выглядит так:
print_ch =  72; print_char(); // H
print_ch = 101; print_char(); // e
print_ch = 108; print_char(); // l
print_ch = 108; print_char(); // l
print_ch = 111; print_char(); // o
Очень многословно. Когда я вчера написал «песню о пиве» в таком формате, программа получилась чересчур длинной. Мне захотелось
Код задаётся целым типом int, который имеет в этом языке 65536 значений. Поскольку мне нужны не все буквы, выглядит так как будто в одно число можно запихнуть несколько знаков. Но сколько?
Для начала посмотрим сколько символов вообще используется. Цифры меня не интересуют (числа выводятся отдельной функцией), поэтому выкинем их:
import sys
from collections import Counter
data = Counter(x for x in ''.join(sys.stdin.readlines()) if x > '9' or x < '0')

print(data)
Вот что получилось:
Counter({' ': 2306, 'e': 1305, 'o': 1108, 't': 903, 'l': 702, 'b': 601, 'n': 600, 'a': 598, 's': 497, 'r': 403, 'f': 300, 'w': 300, '\n': 298, 'd': 298, 'h': 202, ',': 200, '.': 200, 'u': 100, 'T': 99, 'i': 99, 'k': 99, 'p': 99, 'm': 4, 'G': 1, 'N': 1, 'y': 1})Двадцать шесть символов. Жаль не шестнадцать, было бы удобно хранить — как я говорил выше, значений в целом типе помещается 65536 штук. Какая связь? Чтобы это понять, разберёмся откуда взялось число 65536.
Оно вытекает из особенностей машинного хранения. Минимальная единица хранения — бит, хранит всего два состояния, — биты, в свою очередь, собраны по восемь штук в байты. Тип int в данном случае — это два байта.
Отсюда получается, байт — восемь бит по два значения или 2⁸ = 256 значений, два байта — 256² = 65536. В десятичной системе выглядит довольно бессмысленно, но если перейти на шестнадцатеричную, где цифры записываются от 0…9, A…F, с префиксом 0x (он ставится чтобы различить две формы записи числа), то становится понятнее.
Тогда число 65536 будет выглядеть как 0xFFFF — визуально распадается на два байта по 256 (0xFF) значений или на четыре полубайта по 16 (0xF).
Я решил хранить символы в полубайтах. Поскольку символов у меня 26, а в полубайте помещается 16 значений, то одно значение пришлось занять префиксом — если он встречается, то мы используем вторую таблицу символов. Под префикс я выделил 0xF. Таким образом, в одном int можно закодировать от двух до четырёх символов.
Например, число 0x2F40 или 0x2 0xF 0x4 0x0 означает, что мы смотрим второй символ в первой таблице, потом переключаемся на вторую (так как встретили 0xF) и смотрим там четвёртый символ, а символ 0x0 имеет специальное значение, — он не выводится и нужен для того, чтобы у нас была возможность закодировать строку, которая короче, чем могла бы поместиться.
В первую таблицу я поместил самые часто встречающиеся символы, во вторую — те, что встречаются реже. Получилось намного компактнее. Например, строка «hello» в моём алфавите выводится вот так:
s = 21023; ps(); s = 53; ps(); // 0x521F, 0x35Поскольку по техническим причинам число проще обрабатывать с конца, то я разворачиваю ту часть строки, которая кодируется. Это легко заметить по тому, что префиксное значение 0xF у меня находится в конце числа 0x521F.
Код для преобразования строк в такую форму выглядит следующим образом:
input = 'hello'

from itertools import *
# основная таблица
t0 = [' ', 'e', 'o', 't', 'l', 'b', 'n', 'a', 's', 'r', 'f', 'w', '\n', 'd']
# и дополнительная
t1 = ['h', ',', '.', 'u', 'T', 'i', 'k', 'p', 'm', 'G', 'N', 'y']

# поиск символов в таблицах
def conv(ch):
    try:
        yield t0.index(ch) + 1
    except ValueError:
        yield 0xF
        yield t1.index(ch) + 1

# подготовка к разбиению по группам, которые будут кодироваться вместе
def make_shifter():
    pos = 0
    gr  = 0

    def shifter(v):
        nonlocal pos
        nonlocal gr

        if pos == 4:
            pos = 0
            gr += 1

        # префикс переключения таблиц не может остаться в одиночестве,
        # поэтому мы не можем оставить его в хвосте
        if pos == 3 and v == 0xF:
            pos = 1
            gr += 1
        else:
            pos += 1

        return (v, gr, )
    return shifter

shifter = make_shifter()

# нумеруем группы символов
gen = (shifter(x) for x in chain(*(conv(ch) for ch in input)))
# собираем группы символов вместе
gen = groupby(gen, key = lambda x: x[1])

# двигаемся по собранным группам, собираем их в число
for x in gen:
    sum = 0
    for y in list(x[1])[::-1]:
        sum *= 16
        sum += y[0]

    print("s = {}; ps(); ".format(sum))
Теперь только осталось запрограммировать декодирующую часть в SectorC. У нас будет две функции — одна достаёт из числа по одном полубайту за раз, вторая преобразовывает полубайт в соответствующий символ. Как всё работает в деталях объяснять не буду, покажу с минимальными комментариями.
Первая выглядит совсем просто:
int s; // input
void ps() {
    while( s ){
        c = s & 15;
        c2c();
        s = s >> 4;
        if( s == ( 0 - 1 ) ){ s = 0; } // signed workaround
    }
}
Напоминаю, что вы языке у функции нет аргументов и возможности вернуть значение — всё делается через глобальные переменные, поэтому код выглядит странновато.
Строка с комментарием нужна, так как число у нас знаковое (то есть возможные 65536 значений делятся пополам, часть значений считается отрицательным, другая часть — положительными). У отрицательных чисел есть особенность — битовый сдвиг (>>) хоть и считается эквивалентом деления на два, но из минус единицы ноль не делает.
c2c тут — как раз функция, которая должна преобразовывать код в символ (
Сначала я так и сделал, но выглядело, опять же, громоздко. В итоге, переделал чуть попроще: код сравнения выделил в короткую функцию x(), а пару что во что превращается закодировал в один int:
int c; // input
int x;
void x() { if( c == ( x >> 8 ) ){ print_ch = x & 255; } }
После такого кодирования функция
void c2c() {
    c = c + shift;
    x =  288; x(); x =  613; x(); x =  879; x(); x = 1140; x(); x = 1388; x();
    x = 1634; x(); x = 1902; x(); x = 2145; x(); x = 2419; x(); x = 2674; x();
    x = 2918; x(); x = 3191; x(); x = 3338; x(); x = 3684; x(); x = 4200; x();
    x = 4396; x(); x = 4654; x(); x = 4981; x(); x = 5204; x(); x = 5481; x();
    x = 5739; x(); x = 6000; x(); x = 6253; x(); x = 6471; x(); x = 6734; x();
    x = 7033; x();

    if( c != 15 ){ print_char(); }
    shift = 0; if( c == 15 ){ shift = 15; }
}
Как видите, код 0xF (15) устанавливает флаг сдвига значений shift, который в следующий раз складывается с кодом (c + shift) и сдвигает значение на следующем декодировании. Заметно, что нигде нет else, потому что этого оператора в языке тоже нет!
Как будто бы рассказал всё.
Вместо вывода — интересный своей компактностью компилятор, автору моё уважение, — я даже и не подозревал, что в таком малом объёме можно уложить полноценный язык! Очень и очень круто!
99 бутылок: SectorC
Мне тут попеняли в комментариях, что я совсем забросил раздел, в котором я пишу на разных языках программирования американскую считалочку про пиво на стене. Я
Пора возобновить.
76. SectorC — очень маленький компилятор подмножества языка Си. Помещается в один сектор — 512 байт, отсюда и название. Язык очень сильно урезанный, но всё равно меня поражает как автор запихнул имеющееся в такой малый объём.
В языке нет строк и операторов
Самые распространённые в выходном тексте буквы я кодирую полубайтом от 0x1 до 0xE, а более редкие — байтом от 0xF1 до 0xFC. Завтра попробую описать это чуть подробнее.
Немного так же печалит, что нет локальных переменных, параметров и возвращаемых значений — всё передаётся через глобальные переменные, как в ранних Бейсиках. Кроме того, немного
// Written by Evgeny Stepanischev https://bolknote.ru
// SectorC

int c; // input
int shift; int x;

void x() { if( c == ( x >> 8 ) ){ print_ch = x & 255; } }
void p() { print_ch = c; print_char(); }

void c2c() {
    c = c + shift;
    x =  288; x(); x =  613; x(); x =  879; x(); x = 1140; x(); x = 1388; x();
    x = 1634; x(); x = 1902; x(); x = 2145; x(); x = 2419; x(); x = 2674; x();
    x = 2918; x(); x = 3191; x(); x = 3338; x(); x = 3684; x(); x = 4200; x();
    x = 4396; x(); x = 4654; x(); x = 4981; x(); x = 5204; x(); x = 5481; x();
    x = 5739; x(); x = 6000; x(); x = 6253; x(); x = 6471; x(); x = 6734; x();
    x = 7033; x();

    if( c != 15 ){ print_char(); }
    shift = 0; if( c == 15 ){ shift = 15; }
}

int s; // input
void ps() {
    while( s ){
        c = s & 15;
        c2c();
        s = s >> 4;
        if( s == ( 0 - 1 ) ){ s = 0; } // signed workaround
    }
}

void bottle()  { s = 17249; ps(); s = 596; ps(); }
void of_beer() { s = 6961; ps(); s = 41510; ps(); }
void on_wall() { of_beer(); s = 5937; ps(); s = 8692; ps(); s = 22721; ps(); print_char(); }
void o_more()  { s = 40723; ps(); s = 675; ps(); }

int b; // input
void bottle_b() {
    if( b == 0 ){ s = 55; ps(); }
    if( b > 0 ){ print_num = b; print_u16(); }
    bottle();
    if( b != 1 ){ c = 115; p(); } // s
}

void main() {
    shift = 0; b = 99;

    while( b > 0 ){
        bottle_b(); on_wall();

        s = 303; ps(); /* ', ' */ bottle_b(); of_beer();
        c = 46; p(); // '.'
        print_newline();
        b = b - 1;

        s = 2143; ps(); s = 4735; ps(); s = 4723; ps(); s = 31806; ps();
        s = 59265; ps(); s = 35057; ps(); s = 409; ps(); s = 5231; ps();
        s = 936; ps(); s = 59215; ps(); s = 303; ps();

        bottle_b(); on_wall(); c = 46; p(); // '.'
        print_newline(); print_newline();
    }

    c = 78;  p(); /* 'N' */ o_more(); bottle(); c = 115; p(); // 's'
    on_wall();
    s = 28975; ps(); /* ', n' */ o_more(); bottle(); c = 115; p(); // 's'
    on_wall();
    c = 46;  p(); // '.'
    print_newline();

    s = 5039; ps(); s = 16692; ps(); s = 4639; ps(); s = 41801; ps();
    s = 30738; ps(); s = 1566; ps(); s = 53071; ps(); s = 913; ps();
    s = 4767; ps(); s = 41887; ps(); s = 4850; ps();
    b = 99; bottle_b(); on_wall(); c = 46; p(); // '.'
}