программирование
Apache2
Материал довольно старый, уже упоминался во множестве специализированных форумов, тем не менее мне недавно, в который раз, довелось стать участником спора «Apache 1.xx versus Apache 2.xx», поэтому небольшая цитата из небольшой статьи «Apache 1 vs Apache 2 Performance» (Ilia Alshanetsky):
- Apache 2 is about 4% faster then Apache 1 at serving static pages.
- Apache 2’s mod_deflate is over 60 percent faster then Apache 1’s mod_gzip at real time compression of static HTML pages.
- Serving PHP via Apache 2 is 27 percent slower then via Apache 1 DSO and 31 percent slower then Apache 1 static.
На этом,
Скажи спасибо, сволочь!
Фраза из руководства по MySQL (вариант руководства на русском):
Благодаря этому удобному синтаксису, в сервере MySQL не поддерживается оператор ANSI SQL || для конкатенации строк: вместо него используется функция CONCAT().
«Благодаря… не поддерживается»? Не вижу причин благодарить.
Распознавание CAPTCHA MTC
МТС сделал у себя на сайте защиту спама в сервисе отправки SMS. Защита, надо сказать плюшевая — усреднением помехи убираются почти подчистую, дальше распознать цифры очень просто — я пробовал. Удалось добиться стопроцентной вероятности распознавания.
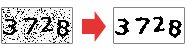
Алгоритм на этот раз не публикую даже из исследовательских целей. Алгоритм для Beeline потом был использован в одной
Кстати, подходящее время вернуться к разговору о защите от спамовых роботов, специализирующихся на форумах, гостевых книгах и т. п. Поводом послужила попытка Helix (aka Ulitka) усовершенствовать предложенные мною методы CAPTHA.
Как уже было сказано, метод CAPTHA — помещение на картинку некого кода, который человек должен прочитать и ввести в особое текстовое поле, обладает следующим недостатком — слишком простое изображение читается роботом, слишком сложное — уже с трудом читается человеком и отпугивает посетителей.
Предлагаю, умозрительно, поискать другие способы защиты от роботов, в стороне от методов CAPTCHA. Скажем, некоторые форумы генерируют для каждого пользователя или хоста, заходящего к ним, идентификатор, который может зависеть, от IP
Всё бы ничего, но хорошие спамовые программы давно содержат средства для быстрой настройки обхода таких средств защиты — идентификатор легко изымается из кода страницы и отсылается серверу. Тем не менее, этот путь мне кажется плодотворным.
Как известно, в браузерах есть скриптовые языки. Наиболее распространённым является JavaScript — его понимает максимальное количество современных браузеров. Код на этом языке включается прямо в страницу браузера «как есть», что делает заимствование кода на JavaScript часто минутным делом. Это положение вещей не устраивает некоторых разработчиков, что привело к появлению (обычной для интерпретируемых языков) защиты — программ изменяющих код таким образом, чтобы его было трудно прочитать человеку (такие программы часто называют «obfuscator»).
Обычно такие программы изменяют имена пользовательский функций, процедур и переменных, убирают форматирование и, иногда, модифицируют сам код программы. Даже программисту средней руки вполне по силам создать неплохой obfuscator, делающий над строкой такие преобразования, чтобы JavaScript смог восстановить исходную строку, а написание
Таким образом, объединение «маркеров», которыми помечаются пользователи
Sort в PHP
Оказывается функция sort в PHP не использует установки локали в PHP4. Косвенно это можно узнать из руководства:
Sorting type flags:
SORT_REGULAR — compare items normally
SORT_NUMERIC — compare items numerically
SORT_STRING — compare items as strings
SORT_LOCALE_STRING — compare items as strings, based on the current locale. Added in PHP 5.0.2
Параметр SORT_LOCALE_STRING появился только в PHP 5.0.2. На мой взгляд, это очень странно. Valshooter рекомендует в этом случае использовать
usort($fruit, 'strcoll');правда, в том случае, если локаль у вас UTF8 вряд ли сортировка вернёт осмысленные данные.
Мой mod_autoindex
Испокон веков в Apache (внимание! речь идёт об Apache 1.x) существует модуль mod_autoindex — в комментариях в его исходном коде есть дата, видимо написания первой версии — 23 марта 1993 года. С тех пор модуль, очевидно, претерпевал
С 1993 года HTML обогатился таблицами и каскадными стилями (CSS). Вряд ли сейчас
В моём портфолио есть несколько проектов, где приходилось изобретать
Стандартный модуль Apache позволяет менять, в этом плане:
- header, т. е. часть над списком файлов (HeaderName, SuppressHTMLPreamble)
- footer, часть под списком файлов (ReadmeName)
- размер иконок (IconWidth, IconHeight)
- внешний вид иконок (AddIcon, AddIconByType, AddIconByEncoding)
- убирать из списка некоторые столбцы (SuppressLastModified, SuppressSize, SuppressDescription)
- изменять описание файла (AddDescription)
- и весьма ограниченно менять внешний вид выводимой информации (FoldersFirst, SuppressColumnSorting и т. п.)
Чаще всего этого для «упаковки» списка файлов в дизайн очень мало. Для облегчения задачи интеграции вывода mod_autoindex в дизайн я несколько усовершенствовал этот модуль. Всё по порядку.
Что умеет новый модуль
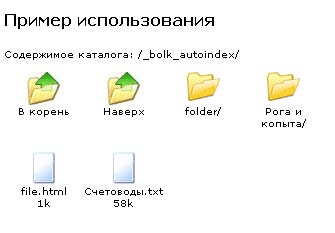
- Режим FancyIndex всегда включен и не выключается. Вряд ли найдётся много людей
не использующих этот режим. - В основном режиме (об этом подробнее — чуть ниже) таблица файлов выводится при
помощи тега TABLE, где у большинства объектов (например, у первой строка, чётных
и нечётных строк) прописаны идентификаторыCSS-классов, из чего следует, что внешний
вид таблицы вы легко сможете задать при помощи файла стилей. - Новая опция, позволяющая включить в листинг файла ссылку на корень сайта
(IndexOptions +RootFolder, при использовании не забудьте добавить иконку,
например так: «AddIcon /icons/back.gif .») - Появилась возможность перенести Description в отдельную (новую) строку
(IndexOptions +DescriptionAtNewRow) - Появилась возможность локализовать (перевести на родной язык) текстовую
информацию модуля (директивы ParentStr, RootStr, NameStr, SizeStr, DescriptionStr, LastModifiedStr). - С первой страницы (если пользователь находится в корне сайта) убрана
ссылка «Parent Directory», ведущая в этом случае, на ту же самую страницу. - Появился новый режим вывода, основанный на теге SPAN (именно он на иллюстрации),
в частности, количество иконок в строке в этом режиме зависит от ширины окна браузера
(IndexOptions +BoxWidth=N +BoxHeight=N +MaxIconHeight=N)
Новый режим вывода
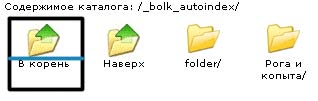
Новый режим вывода включается автоматически, если были использованы параметры BoxWidth и BoxHeight. Эти два параметра отвечают за размер прямоугольника, в который заключена иконка (на иллюстрации выделено чёрным) и, по сути, определяют расстояние между соседними иконками.
Размер этот нужно выбирать исходя из размеров иконки, текста названия файла и строки, где выводится размер файла, плюс некоторое пространство, необходимое для обеспечения зазора между соседними иконками. Есть ещё один параметр — MaxIconHeight, выбрать его просто — это всего лишь максимальная высота иконки в вашем наборе. Нужен этот параметр для того, чтобы подписи к иконкам располагались на одном уровне (на иллюстации — синяя линия).
В этом режиме под иконкой выводится имя файла, размер и дата модификации (если, конечно, не были использованы опции SuppressLastModified и SuppressSize), описание файла выводится в аттрибут «title» тега SPAN, охватывающего иконку и надписи (если не была использована опция SuppressDescription) — вы можете использовать DHTML, чтобы выводить информацию из title в статусную строку, всплывающую подсказку и т. п.
Пример
Файлы для вывода информации так, как это изображено на иллюстрации выглядят так:
Файл «.htaccess»:
IndexOptions +SuppressHTMLPreamble +NameWidth=*
IndexOptions +SuppressLastModified +FoldersFirst +RootFolder +DescriptionWidth=*
IndexOptions +BoxWidth=80 +BoxHeight=80 +MaxIconHeight=33

HeaderName /_bolk_autoindex/.HEADER.html
ReadmeName /_bolk_autoindex/.FOOTER.html
ParentStr "Наверх"
RootStr "В корень"
NameStr "Имя"
SizeStr "Размер"
DescriptionStr "Описание"
Файл «.HEADER.html»:
<head>
    <title></title>
    <style type="text/css">
    td,
    body { background-color: white; font-family: Verdana,Tahoma; font-size:10px }
    a    { color: black; text-decoration:none }
    .cell0, .cell1 {text-align: center}
    a:hover { text-decoration: underline }
    </style>

</head>
<body>
<h4>Пример использования</h4>
Содержимое каталога:
<!--#echo var="DOCUMENT_URI" encoding="none" -->
<br clear="all" /><br />
Файл «.FOOTER.html»:
</body>Где взять и как установить
Файл можно взять у меня на сайте (ZIP, около 15Кб), для установки нужно переписать его на место старого модуля (каталог src/modules/standard) и перекомпилировать Apache. Проблемы и их решения
Часто, помимо имени файла, его размера и даты создания, хочется вывести другую полезную информацию — например, разрешение для картинок, ID3 теги для MP3 файлов и так далее. Для этой цели я рекомендую воспользоваться полем «Description» и директивой «AddDesription». Задачей модуля не является и, надеюсь, не будет являться (иначе это приведёт к снижению производительности) автоматический вывод информации такого рода. Напишите скрипт (кстати, возможно позднее я его выложу), который пробежит по каталогам и добавит эту информацию в соответствующие .htaccess файлы и вызывайте его далее по мере необходимости.
Один из заказчиков попросил предоставить пользователю возможность самому выбирать какой вид листинга файлов он хочет получить — табличный или в виде иконок. К сожалению, у Apache 1.x нет методов переключения конфигурации в зависимости
<VirtualHost example.com:80>
...
AccessFileName .htaccess .htaccess-table
...
</VirtualHost>

<VirtualHost example.com:443>
...
AccessFileName .htaccess .htaccess-icons
...
</VirtualHost>
где прописаны одно общее имя
По всем вопросам, с пожеланиями по улучшению — добро пожаловать в мой почтовый ящик, он есть на моём сайте внизу каждой страницы.
myPHPinfo
Известно, что некоторые хостеры отключают функцию phpinfo из соображений безопасности. Неприятно, но часто приходится мириться и делать
Именно для таких случаев я написал myPHPinfo — программу на PHP, эмулирующую вывод функции phpinfo, насколько это возможно, конечно. Инструкции, ссылки для скачивания и изучения примеров работы есть в специальном разделе сайта.
Наученный горьким опытом даю совет: если вам кажется, что «зачем это нужно, если есть phpinfo», то перечитайте текст выше — там как раз об этом.
Новый 8sender
Обновился 8sender (PHP) — программа, позволяющая отправлять
Новое в этой версии:
- Имена передаваемых файлов записываются ещё и в тему письма.
E-mail отправителя теперь можно не указывать — в этом случае
система автоматически подставит «admin@example.com»
Напоминаю, что для того, чтобы использовать эту программу, вам нужен интерпретатор языка PHP (минимально — файлы php.exe и php4ts.dll).
Для удобства тех, кто работает под Windows я сделал специальный файл — 8sender.bat. Скачивать и запускать нужно его, в пределах видимости скрипта должен быть расположен файл php.exe — той же папке или в любой папке, указанной в системной переменной PATH.
Плохие новости владельцев Windows 95/98/ME — вам придётся указать SMTP сервер для отправки сообщений. Инструкцию по запуску можно получить, запустив программу без параметров.
Будущее CAPTCHA
Кажется, перед разработчиками начинает маячить проблема роботов, оставляющих спам в форумах или выполняющих автоматическую регистрацию (часто — для того чтобы спамить в тех форумах, где анонимно это сделать не получается).
Традиционно, разработчики либо мирятся с неизбежным злом, либо используют так называемый
Если сильно исказить картинку, пользователь может не понять (со мной такое бывало), что на ней, собственно, изображено и после первой же неудачно попытки ввода уйти — робота же это не смутит. Если, скажем, вероятность распознавания составить всего лишь 20%, ничего не мешает роботу сделать несколько попыток до успеха.
Второй недостаток… Недавнее изобретение спамеров — метод «леммингов». Спамер открывает порносайт и… предлагает всем желающим войти, в качестве «платы», ввести код, написанный на картинке. Картинка берётся с сайта «жертвы». Как только «лемминг» вводит код,
Разновидность этого
Защиту от техники леммингов, в общем случае, я предложить не берусь — разве что отлавливать подозрительную активность
Образы.
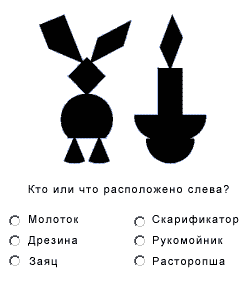
Незаслуженно редко используют в качестве
- Они предлагают пользователю ввести слово
целиком. Пользователю неудобно. Я предлагаю использоватьradio-кнопки , вероятность
угадывания роботом увеличивается, но смотри пункт 2. - Они ничего не делают в случае неправильного ответа. Единственное, что сразу приходит
в голову — сразу блокировать IP нарушителя. Делать так можно, но существует
опасность заблокировать весьdialup-пул какого-нибудь провайдера, всех пользователей
какого-нибудь NATили прокси-серверов.
Пользователь (см. иллюстрацию)
может не попасть по «зайцу»(кто-то отвлёк, мышка заела) и выбрать «дрезину», но
он не за что не кликнет в «рукомойник». Человек, в здравом уме, не спутает зайца с рукомойником.
Ошибки позиционирования для близлежащих элементов можно и нужно прощать, за остальные —
наказывать: для этого IP переходить к другому, более неприятномуCAPTHA-методу ,
заставляя вводить слово целиком. - Они не пытаются запутать робота. Базу картинок, можно слить, если спам на
данный сервер очень важен или у спамера много свободного времени,
составить hash каждой иллюстрации и занести в базу.
Несложно увеличить стоимость взлома — достаточно выводить не одну картинку, а, например,
вывести в одну картинку сразу три изображения и туда же (в картинку) писать вопросы вида:
«что изображено на картинке в центре».
Количество вариантов изображения увеличивается
до N*M*S, где N — количество изображений в базе, M — количество изображений, печатаемых
в одну иллюстрацию, S — количество вариантов фраз. Важно, кстати, не делать изображения
фиксированными по ширине — иначе их легко будет разделить. Проявите фантазию — изображения
можно чуть масштабировать, инвертировать или перечеркнуть, фразу — писать в случайном месте
и так далее. Число вариантов увеличивается настолько, что базу можно и не менять. А методы
разделения и распознавания изображения по его участку не сработают.
Figlet.
История FIGlet началась весной 1991 года. Frank Sheeran написал другу автора первой версии Ian Chai письмо, где в качестве подписи использовалась строка, написанная
С тех пор появилось несколько версий подобных программ, библиотеки на различных языках, я сам, относительно недавно, написал библиотеку Text_Figlet для PHP (скоро войдёт в PEAR). В данный момент доступно примерно 420 шрифтов для написания.
Шрифт в изображении можно уменьшить, например, до 4 пикселей и фраза на экране будет занимать вполне приемлемое пространство. Жизнь спамера осложняется не только тем, что количество шрифтов довольно велико, но и эффектом „smushing“ (горизонтальная склейка), который используется в некоторых шрифтах. Посмотрите внимательно на написанную фразу — соседние буквы в ней „склеены“.
В начале было слово…
В начале было слово, но записать его, думаю, было нечем — Богу вряд ли нужна авторучка с бумагой, а людей тогда ещё не было. Первые люди писать тоже не могли, но могли говорить. Так что голос — довольно древнее средство общение, но с его распознованием у роботов всё ещё большие проблемы.
Некоторые сервисы (LiveJournal), например, используют альтернативный
Активный контент.
Надеюсь, этот метод распространения не получит распространения — я такой контен недолюбливаю, но спам не люблю ещё больше. В браузерах есть такая вещь как плагины — наиболее распространнёными, наверное, можно считать Flash и Java — два языка программирования, на которых вполне можно написать приложение выводящее текст или цифры.
Разобраться в том, как это приложение работает, чтобы понять что оно выводит роботу не по силам. В принципе, можно было бы давать
Animated GIF.
Несколько более простая разновидность предыдущего метода не требующая отдельного плагина — Animated GIF. Если бы вы смогли разыскать
Хитрость заключается в том, что GIF позволяет создавать анимации, где каждый кадр может иметь свою локальную палитру. Предел палитры в GIFе, как мы знаем — 256 цветов. Но никто не говорил, что нельзя записать 10 кадров, в каждом из которых было бы по максимуму цветов и которые были бы все одновременно видны. В результате мы получим 2560 цветов. Неплохо для начала.
Подобная идея приходила в голову не одному только Лебедеву, конечно. Картинка — одна из иллюстраций из статьи True Color GIF, где в формате GIF используются 32796 цветов. Заливка, которую вы видите, нужна лишь для демонстрации — в „Ководстве“ Лебедева GIF, содержащий 1792 цвета отображался без заливки, сразу целиком.
Пора, наверное, уже сказать к чему я клоню, если вы ещё сами не догадались. Разбор GIF’a, скомпонованного подобным образом — задача довольно сложная. Писать можно полноцветными буквами, части которых находятся в разных кадрах, играя с их перекрытием (например, заслонять символы или их части).
Безусловно, задача решаемая — нужно только последовательно разобрать все кадры и наложить их один на другой, но для этого нужно уметь работать с animated GIF, да и правильно наложить один кадр на другой — в общем, тут есть где споткнуться спамеру.
Сессии в SSI
Один из проектов, в разработке которого я участвовал в недавнем времени, расчитывался на огромную посещаемость (забегая вперёд, скажу — проект действительно стал исключительно посещаемым), в связи с чем пришлось разрабатывать и использовать технические решения, позволяющие проекту не «падать» под огромными нагрузками.
В частности, была разработана система кеширования, которую можно охарактерировать как «всё по максимуму в в HTML, остальное — включаем через SSI и фреймы». Поскольку на сайте используются пользовательские сессии, сложилась ситуация, когда сессию должны могли инициировать и скрипты (язык программирования — PHP, основной сервер — Apache 1.x), включенные через SSI. Тут надо заметить, что
Trans_sid использовать нельзя, скрипты, включенные через SSI заголовок выдать не могут и, следовательно, проставить сессию в cookie — тоже. Сначала я, было, решил полностью отказаться от SSI и работать исключительно с iframe, но подумал — нельзя ли Apache заставить генерировать идентификатор сессии самостоятельно?
Оказалось — можно. Первое, что пришло в голову — использовать модуль mod_unique_id к Apache — я слышал об этом модуле, но никогда его не использовал. Внимательно прочитав инструцию к модулю, я понял, что это совсем не то, что нужно — модуль генерирует уникальный идентификатор для каждого запроса:
This module provides a magic token for each request which is guaranteed to be unique across «all» requests under very specific conditions. The unique identifier is even unique across multiple machines in a properly configured cluster of machines.
Внимательно пролистав список официальных модулей Apache, я нашёл в списке mod_usertrack — модуль, маркирующий пользователей при помощи cookie. Обычно он используется для того, чтобы различать пользователей в логах
Проведя испытания, я столкнулся с вполне ожидаемыми трудностями — во время первого запроса, когда сервер только что отослал cookie клиенту, в переменной PHP \_COOKIE$ пусто — cookie ещё не пришли от клиента назад и, соотвественно, не были записаны в эту переменную.
В PHP есть функция apache_response_headers, возвращающая массив всех заголовков, выдаваемых
<?php
function U_sid()
{
    // Если идентификатор уже есть в cookie, возвращаем его
    if (isset($_COOKIE['Apache'])) return $_COOKIE['Apache'];

    // Иначе - ищем его в ответе Apache
    $responce = apache_response_headers();
    foreach (preg_split('/s*;s*/', @$responce['Set-Cookie']) as $chunk)
    {
        list($key, $value) = explode('=', $chunk, 2);
        if ($key == 'Apache') return $value;
    }

    return null;
}
«Apache» — это имя cookie, которое проставляет Apache. Далее — всё просто, в php.ini отключаем «session.use_trans_sid» и «session.use_cookies», чтобы запретить PHP создавать сессии, в .htaccess помещаем директивы модуля mod_usertrack:
CookieFormat Compact CookieTracking on CookieStyle CookieА в библиотечный файл (или наши файлы PHP, поближе к началу), вызов необходимых, для создания сессии, функций:
<?php
// Узнаём идентификатор сессии
if (($sid = U_sid()) !== null)
{
    // Если он не null, создаём сессию
    session_id($sid);
    session_start();
}
В итоге мы получаем
Решение проблемы box-model
В журнале kukutz’a на сайте NPJ появилась заметка «Решение проблемы
Известно, что есть как минимум два варианта
бокс-модели: W3Cшный, когда в ширину блока включен только размер содержимого (контента), майкрософтовский, когда в ширину блока включается ещё padding и border.
Майкрософтовский, надо сказать, куда более понятен и интуитивен.
Сегодня мы рассмотрим, как, проиграв в валидируемости ваших CSS, попросить все браузеры придерживаться Майкрософтовской
бокс-модели.
Для чего нужен SQLite
Открылся Wiki по SQLite. Цитата:
В Web sqlite уготовано место исключительно блогов и прочего где минимально количество записей.
sqlite превосходен, когда большое количество запросов, и когда операции записи редки, и редко задействуют несколько таблиц.
При более-менее сложных операциях плохо, ибо блокировку отдельных строк он не умеет, и во время транзакции блокирует базу целиком (даже не отдельную таблицу).
Тест nginx
Тестировал сегодня nginx. Отключил все ненужные модули (кстати, если будете компилировать
Так или иначе, 0W лидирует по скорости и обладает более пригодным для моих задач возможностями. Но и nginx очень хорош, думаю, если будет развиваться, может стать достойным конкурентом остальным решениям.
Тестирование веб-серверов
Прислали ссылку на тестирование различных
Итак. Лучше всех справился
Выбор веб-сервера
Вопрос к уважаемой публике: имеется
Tux —
X15 —
ZeroWait — решение, которое было выбрано. Характеристики устойчивости, защищённости и скорости неизвестны, но с задачей справляется. Два недостатка — почти полная неизвестность (а значит и неизвестная степень безопасности) и очень слабая документированность.
8sender
Написал программу (2.65Кб), позволяющую отправлять вложения в формате bolk quoted printable. На PHP. Вкратце напомню — это формат, который, в отличие от остальных форматов вложений (quoted printable, UUE, Base64), минимально увеличивает размер файла. Основные почтовые клиенты его понимают.
Утилита
php 8sender.php mail@example.com bolk@example.net big.tiffОпционально первым параметром можно указать адрес вашего SMTP, он должен быть первым после ключа -t. Если его не указать, программа попытается самостоятельно определить MX получателя. Для работы под Windows желателен PHP 4.3.0 и выше.
php 8sender.php -t smtp.example.com mail@example.com bolk@example.net big.tiffПосле запуска программа покажет диалог
Сколько книг прочёл
Через три дня — 19 сентября. 19 сентября 2003 года я начал вести список книг, которые читаю. За три дня я вряд ли успею ещё
Кстати, для подсчёта количеста прочитанных книг нужна всего одна строчка — нужно просто посчитать количество строк, начинающихся с даты. Я немного побаловался — подсчитал количество этих строк на разных языках, тех, которые были под рукой.
Perl:
print scalar grep {/^\d+\.\d+/} <>Unix Command Line Utils:
grep -E "^[0-9]+\.[0-9]+\."|wc -lPHP:
echo preg_match_all('/^\d+\.\d+\./m', file_get_contents('php://stdin'), $m);Windows NT CMD:
@SET C=0 & FOR /F %%I IN ('findstr "^[0-9][0-9]*\.[0-9][0-9]*\."') DO @SET /A C+=1 @ECHO %C%Windows Script Host (JScript):
for (i = 0; !WScript.StdIn.AtEndOfStream;)
if (/^\d+\.\d+\./.test(WScript.StdIn.ReadLine())) i++ WScript.Echo(i)
Microsoft Word Visual Basic:
Sub Макрос1()
Cnt = 0
With ActiveDocument.Content.Find
   .Text = "^#^#.^#^#.^#^#^#^#"
   .Execute
   While .Found
       .Execute
       Cnt = Cnt + 1
   Wend
End With
MsgBox Cnt
End SubCompnews
Полюбовавшись на сайт, я написал письмо всем известному Лебедеву — рассказал ему об идее и реализации. В ту пору я с ним переписывался на почве JUnix. Лебедев, казалось, идею не оценил, но, через некоторое время, у студии Лебедева появился проект «Закладки» — с моей идеей в основе, только проектам было предложено самим регистрироваться как источник информации (об RSS в России тогда слышали только единицы).
Через некоторое время проекты загнулись — и мой, и его брат. Зато, несколько позже, появился «Мой Яндекс». Идея всё та же, только на этот раз, поскольку времена были уже другие, для импорта данных были использованы RSS.
Идея, как известно, ничьей собственностью не является и речь идёт вовсе не о плагиате. Я вот о чём — могу ли я, интересно, считаться одним из отцов проекта «Мой Яндекс»?
Устранение потерь при кодировании почтовых аттачей в base64
Как известно,
Прошло время, текст в электронных письмах давно уже не только английский, а стандарты кодирования текстовых файлов до сих пор используют только латинские буквы (плюс цифры и некоторые символы, такие как плюс, миную, слеш и так далее). Мне пришло в голову — а что если попробовать кодировать файлы всем полем допустимых символов. Сейчас, когда появились письма
Из всех вариантов кодирования, а их три (Base64, UUencode
Я же задался целью проверить, что же будет, если попробовать передать файл, где поле допустимых символов расширено до максимума. Сразу скажу — эксперимент удался. Можено эксперементально внедрять новый формат кодирования писем. Назовём его Bolk
Я написал небольшую программу на PHP, которая в качестве параметра использует имя файла, который нужно закодировать, а на выход выдаёт этот файл в формате понятном почтовому клиенту. Таким образом, если её запустить как «php -q 8qp.php somegif.gif > somename.eml» и открыть получившийся файл вашим почтовым клиентом, внутри вы должны увидеть свою картинку.
<?php
    // Example 1. 8qp.php
    // Written by Evgeny Stepanischev aka BOLK
    $bound = 'BOLKNOTE.RU';

    $mime = getimagesize($argv[1]);
    $mime = $mime['mime'];

    $str = file_get_contents($argv[1]);
    $len = filesize($argv[1]);

    echo <<<HEADER
Content-Type: multipart/mixed;
        boundary="----{$bound}"

------{$bound}
Content-Type: $mime; name="{$argv[1]}"
Content-Disposition: attachment; filename="{$argv[1]}"
Content-Transfer-Encoding: quoted-printable


HEADER;

    $np = array (0, 10, 13, 61);

    for ($i = 0; $i<$len; $i++)
    {
        $code = ord($str{$i});

        echo in_array($code, $np) ?
        '='.strtoupper(str_pad(dechex($code), 2, '0', STR_PAD_LEFT)):
        $str{$i};
    }

    echo "rn------{$bound}--";
Для эксперимента я выбрал наугад две картинки. JPEG и GIF. И вот что получилось в итоге. «TheBAT!» — это наименование моего почтового клиента.
Случайный GIF: исходный размер — 33590, мой
Случайный JPEG: исходный размер — 28144, мой
В случае
Эксперименты на первом же попавшемся Sendmail показали, что,
Последняя беда поставила меня в тупик. Правда, ненадолго. Вспомнив, что большинство клиентов умеют открывать письма в формате EML я решил пойти на хитрость — прикрепить моё письмо как аттачмент другого, замаскировав моё письмо под обычный текст — Sendmail вряд ли проверяет аттачи глубже одного вхождения. А чтобы письмо максимально адекватно воспринималось почтовым клиентом, я дал ему disposition inline и убрал из него все служебные поля. Попробовал отправить — получилось. В TheBat видно только лишнее пустое поле — беда небольшая.
<?php
    // Example 2. 8qp_next.php
    // Written by Evgeny Stepanischev aka BOLK

    $bound  = '3D1E1C92aaBF00D';
    $bound2 = '3D1E1C92xxBF00D';

    $mime = getimagesize($argv[1]);
    $mime = $mime['mime'];

    $str = file_get_contents($argv[1]);
    $len = filesize($argv[1]);

    echo <<<HEADER
From: <mailbox@sample.com>
To: mailbox@sample.com
From: mailbox@sample.com
Content-Type: multipart/mixed;
 boundary="----------{$bound2}"

------------{$bound2}
Content-Type: message/rfc822; name="1.eml"; charset=utf-8
Content-Disposition: inline; name="1.eml"
Content-Transfer-Encoding: 8bit

Content-Transfer-Encoding: 8bit
Content-Type: multipart/mixed;
        boundary="----{$bound}"

------{$bound}
Content-Type: $mime; name="{$argv[1]}"; charset=utf-8
Content-Disposition: attachment; filename="{$argv[1]}"
Content-Transfer-Encoding: quoted-printable


HEADER;

    $np = array (0, 10, 13, 61);

    for ($i = 0; $i<$len; $i++)
    {
        $code = ord($str{$i});

        echo in_array($code, $np) ?
        '='.strtoupper(str_pad(dechex($code), 2, '0', STR_PAD_LEFT)):
        $str{$i};

        if ($i && ($i % 512) == 0) echo "=rn";
    }

    echo "rn------{$bound}--",
    "rn------------{$bound2}--";
Полный размер письма после такой двойной «упаковки» увеличивается незначительно. Кстати говоря, Opera 7.0 с таким письмом не справилась. Возможно, в силу старости — текущая версия этого пакета — 7.61b. Для интереса я отправил письмо на мои ящики на серверах Mail.ru и Gmail.com. Оба сервера вполне достойно справились с задачей, единственно, что Gmail не принимал письмо, пока я не указал charset как
Патч к IMP/Horde
Если при работе с webmail IMP/Horde у вас выдаются ошибки в функции imap_fetchbody, попробуйте применить мой патч. Порядок применения:
- Разместить в папке lib, с названием, например, bolkpatch.php.
- В файлах lib/IMP.php и view.php после блока строк require_once надо ставить строку
require_once IMP_BASE . ’/lib/bolkpatch.php’; - Заменить в этих двух файлах все вызовы imap_fetchbody на imap_fetchbody2.
- Установить модуль PEAR Mail_Mime (pear install Mail_Mime)
// IMP patch. Written by Evgeny Stepanischev
function imap_fetchbody2(&$imap_stream, $msg_number, $part_number, $options = NULL)
{
    $params = array(&$imap_stream, &$msg_number, &$part_number);
    if ($options !== NULL)
    $params[] = &$options;

    $str = @call_user_func_array('imap_fetchbody', $params);

    if ($str == '' || $str === FALSE)
    {
        array_splice($params, 2, 1);

        $mail = @call_user_func_array('imap_fetchheader', $params).
                @call_user_func_array('imap_body', $params);

        require_once 'Mail/mimeDecode.php';

        $decoder =& new Mail_mimeDecode($mail);
        $structure = (array) $decoder->decode(array('include_bodies' => true));

        return isset($structure['parts'][$part_number-1]) ?
                $structure['parts'][$part_number-1]->body :
                $structure['body'];
    }

    return $str;
}WinAPI и PHP
Так случилось, что в PHP существует три модуля расширения — два для PHP4 и один для PHP5, позволяющих обращаться к Windows API. Способы их вызова различны, плюс ко всему, положение усугубляется тем, что модули расширения имеют одинаковые имена, документация есть только по первому из них, тогда как в комплект PHP включается второй.
Ниже — результат моей потребности выяснить как же это всё работает. Прежде всего стоит заметить, что w32api не работает с mod_php, если старая версия вызывает ошибку при попытке повторного вызова в то же child, то новая вызывает ошибку сразу. В режиме CGI и с PHP5 я таких экспериментов не проводил.
Итак, ниже — реализация функции link (hard link) для Windows NT. Под CLI пример работает как с PHP5, так и с PHP4. Конечно, для того, чтобы пример заработал, нужна файловая система, поддерживающая hard links. Под моей NTFS5 (Windows XP) ссылки ставятся.
// Written by Evgeny Stepanischev (aka BOLK)
if (PHP_OS == 'WINNT') {
    // Модуль расширения FFI для PHP5
    if (extension_loaded('ffi') || intval(PHP_VERSION) >= 5 && @dl('php_ffi.dll')) {
        function link($target, $link) {
            $api = & new ffi("[lib='kernel32.dll'] int " . "CreateHardLinkA( char *link, char *target, long *attr);");
            return (bool)$api->CreateHardLinkA($link, $target, NULL);
        }
    } else
    // Модуль расширения w32API для PHP4
    if (extension_loaded('w32api') || @dl('php_w32api.dll')) {
        // Старая версия модуля
        if (function_exists('w32api_register_function')) {
            if (!function_exists('CreateHardLinkA')) {
                @w32api_register_function('kernel32.dll', 'CreateHardLinkA', 'bool');
            }
            if (function_exists('CreateHardLinkA')) {
                function link($target, $link) {
                    return CreateHardLinkA($link, $target, NULL);
                }
            }
        } else {
            // Новая (примерно с версии PHP 4.3.0)
            function link($target, $link) {
                $api = & new win32;
                $api->registerfunction("bool CreateHardLinkA" . "(string &link, string &target) From kernel32.dll");
                return $api->CreateHardLinkA($link, $target);
            }
        }
    }
}