Иллюстрации из книги «Евгений Онегин»
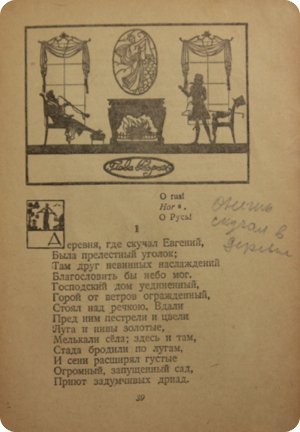
У нас дома лежит книга «Евгений Онегин» Пушкина, издательство «Художественная литература» 1936 года. Жена перечитывает. А мне нравятся иллюстрации. Я сфотографировал некоторые из них, мне даже логотип нравится.
Моя Казань (видео)
Видео к торжественной передаче флага Международной федерации студенческого спорта от Китая России, которая состоялась в рамках церемонии закрытия Всемирных летних студенческих игр 2011 года. Мэр Казани Ильсур Метшин получил флаг из рук мэра Шеньженя (в 2013 году Казань принимает у себя «Универсиаду»).
Ночевал в Авиагородке
Если вы, как я вчера, опоздаете на самолёт и вам придётся искать ночлег в Домодедове, рекомендую — Галина Васильевна (+7 916 626 64 69). За две тысячи рублей (если вас двое — по 1500 с каждого) разместит вас у себя в квартире в Авиагородке на улице Туполева. Квартира чистая, правда с советским ремонтом, комната отдельная. Гостиница в аэропорту, для сравнения, стоит 6700 за обычный номер.
Такси до места (и обратно — в аэропорт) стоит 200 рублей, ехать — минут
Авиагородок (бывший посёлок
Кстати, забавно — водитель такси, который вёз меня оттуда спросил «в аэропорт куда?».
ЭЦП
На конференции «Осенний
ЭЦП (электронная цифровая подпись) сейчас, фактически, используется не для того, для чего была придумана. Её назначение — кратковременное подтверждение подлинности переданного документа. К примеру, я получил письмо и мне нужно убедиться, что оно действительно пришло именно от того адресата, которые указан в поле отправителя. Стандартный протокол обмена письмами мне этой уверенности не даёт. А ЭЦП — пожалуйста.
Я открываю письмо, по подлинности ЭЦП убеждаюсь, что всё в порядке, дальше ЭЦП мне не нужна.
В электронных документооборотах не так. Там ЭЦП используется для подтверждения подлинности документа в долгосрочном периоде — годы, десятки лет, в перспективе, возможно, сотни (если речь идёт о долгосрочных договорах между государствами, например).
Чтобы не было возможности подделать документ, изменить его содержимое, применяется ЭЦП. Как правило, доступ к хранилищу, где он размещается, имеют сотни людей, причём многие из них — на запись. С течением времени, количество людей, имевших теоритическую возможность подмены документа, увеличивается —
Но. Надёжность ЭЦП, фактически, основана на сложности математических задач, заложенных в алгоритм электронной цифровой подписи. Эти задачи выбраны таким образом, чтобы подделка подписи требовала огромных вычислительных ресурсов. Последнее с успехом может быть заменено использованием более скромных ресурсов
В чём проблема. Мы все с вами наблюдаем современные темпы развития техники, пройдёт пара лет
В долгосрочной перспективе использования ЭЦП это проблема — при хранении документов десятки и сотни лет, риск подмены документов, особенно важных, где игра стоит свеч возрастает многократно.
Конечно эту проблему следует смотреть и в разрезе обеспечения доступа к самому хранилищу, но то, что нужны
С физическими (например, бумажными) носителями несколько проще — подделку нужно изготовить заранее, если упустить шанс, то его уже больше не представится. Насколько я знаю, пока нет технологии, которая могла бы «состарить» чернила, бумагу, а так же начеркать загогулину обычной подписи, так чтобы эксперты не смогли её отличить от подлинных, оставленных на других документах. А в её отсутствие, подделка вряд ли возможна.
Можно увеличивать длину ключа, (фантазирую) применять ключи, занимающие десятки килобайт. Шифрование будет крайне медленным, но для важных документов можно и потерпеть. Но вот вопрос — если через двадцать лет появятся квантовые компьютеры, которым такая длина ключей «на один зуб», что будем делать? Как видно, простого выхода из ситуации не существует.
Sublime Text 2 (совет)
Поставил по совету коллег с прежней работы себе текстовый редактор «Sublime Text 2», всё хорошо, одна проблема — файлы с кодировкой CP1251 он открывает неправильно, приходится переоткрывать через «File → Reopen with Encoding → Cyrillic (Windows 1251)».
Покопался по настройкам, нашёл выход. Нужно зайти в настройки (на «Маке», как обычно — ⌘+,) и добавить между фигурными скобками вот такую настройку: «»fallback_encoding«: „Cyrillic (Windows 1251)“». Мой файл настроек сейчас почти пустой и выглядит вот так:
// Settings in here override those in "Default/Base File.sublime-settings", and
// are overridden in turn by file type specific settings. Place your settings
// here, to ensure they're preserved when upgrading.
{
    "fallback_encoding": "Cyrillic (Windows 1251)"
}
Тач-интерфейс
Я тут задумался над русским аналогом
Записались с женой в спортзал
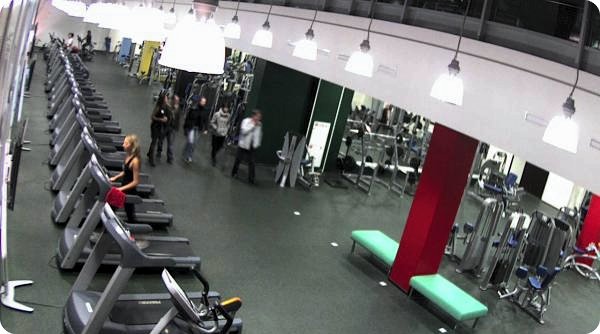
Ура! Записались с женой в спортзал на 15 месяцев (абонемент на год + три месяца в подарок). Спасибо жене — нашла и выбрала программу для нас, будем ходить. Записались
Если промотать до 15 октября, примерно до 18:50, можно нас там увидеть на нескольких кадрах — слева инстуктор, потом я, в центре жена, а дальше ещё одна пара, которой тоже показывали залы.
Расширение для «Альфреда» для перевода текста
Решил перейти на «Альфред» — замену «Спотлайта» на «Маке». Мне его Вадим Макеев мельком показал на конференции в Самаре.
Главная причина — под «Альфред» легко писать расширения. Писать их можно на обычном Баше, Экшнскрипте или в Автоматоре.
Для этого я купил «Паверпак» (£12), который позволяет ставить и использовать расширения (сам «Альфред» бесплатный) и «Граул» ($1,99), позволяющий создавать собственные всплывающие нотификации в системе.
Скачать расширение можно по следующей ссылке:
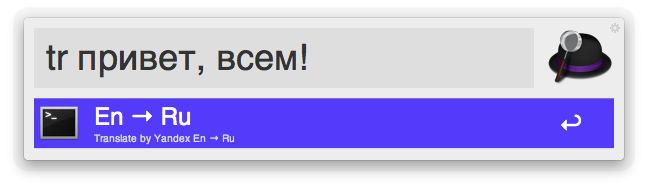
Перевод делается через сервис «Яндекса». Результат показывается через «Граул».
Поставить расширение проще простого — в закладке «Extensions» есть поле, где написано «Drop to install», туда надо перетащить скачанное расширение и всё, дело сделано.
Ещё раз про 28:00
Например, на сайте «Мосгортранса» висит расписание автобусов (Дофин, спасибо за ссылку!), где, в частности, написано, что автобус №115 отправляется «от к/ст. “Марьино”
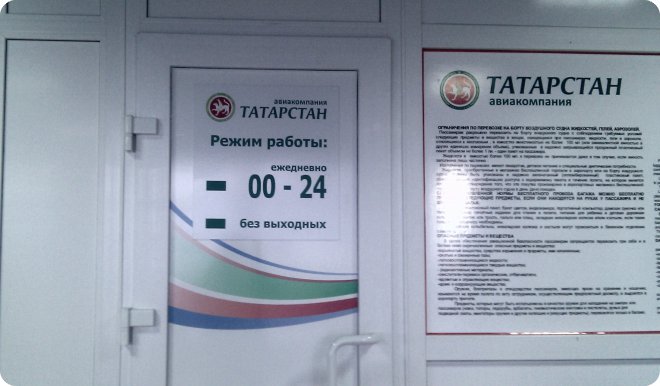
А вот этот снимок я сделал, когда прилетел в Казань пару месяцев назад, это расписание справочной авиакомпании «Татарстан» в казанском аэропорту:
CSS hack for FireFox 6
Меня тут попросили сделать
x::-moz-progress-bar, body {
    background: orange; /* FF 6.0+ */
}

@-moz-document regexp(".*") {
    body {
        background: orange; /* FF 6.0+ */
    }
}
Проверено на Firefox 6.0 и 7.0.1.
TOEFL
Сегодня прошёл письменный тест TOEFL
Заметил две вещи: мне сложно определять ошибки в фразе, я привык отталкиваться от того, что фраза написана без ошибок, и мне тяжело воспринимать американскую речь, которая была в тесте. Речь на английском ведущего нашего теста я воспринимал естественно и не задумываясь. Возможно, конечно, что он специально выбирал выражения попроще, но думаю, что всё дело в том, что она была просто «чистой» — он не склеивал слова и не «жевал» окончания.
Оптимизиция шрифтов с «Гугл фонт АПИ»
Благодаря Мицголу невозбранно узнал о существовании у «Гугл фонт АПИ» параметра «text», где можно перечислить буквы, которые вы будете использовать в шрифте. Это сильно сокращает размер скачиваемого шрифта. Напоминаю, «Гугл фонт АПИ» — это специальное АПИ для браузеров, позволяющее использовать свободные шрифты из коллекции Гугла. Шрифты подготавливаются автоматически, в зависимости от того, что поддерживает браузер:
bolk@Bolk ~/Projects/Ttt/exp (master) $ wget -O - --user-agent='Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; Trident/5.0)' http://fonts.googleapis.com/css?family=Rock+Salt 2>&-
@font-face {
  font-family: 'Rock Salt';
  font-style: normal;
  font-weight: normal;
  src: url('http://themes.googleusercontent.com/static/fonts/rocksalt/v1/Q94aHXFHGip10K5uxi1jOPY6323mHUZFJMgTvxaG2iE.eot');
  src: local('Rock Salt'), local('RockSalt'), url('http://themes.googleusercontent.com/static/fonts/rocksalt/v1/Q94aHXFHGip10K5uxi1jOD8E0i7KZn-EPnyo3HZu7kw.woff') format('woff');
}

bolk@Bolk ~/Projects/Ttt/exp (master) $ wget -O - --user-agent='Opera/9.00 (Windows NT 5.1; U; en)' http://fonts.googleapis.com/css?family=Rock+Salt 2>&-
@font-face {
  font-family: 'Rock Salt';
  font-style: normal;
  font-weight: normal;
  src: local('Rock Salt'), local('RockSalt'), url('http://themes.googleusercontent.com/static/fonts/rocksalt/v1/Q94aHXFHGip10K5uxi1jOKCWcynf_cDxXwCLxiixG1c.ttf') format('truetype');
}

bolk@Bolk ~/Projects/Ttt/exp (master) $ wget -O - --user-agent='Mozilla/5.0 (X11; Linux i686; rv:6.0) Gecko/20100101 Firefox/6.0' http://fonts.googleapis.com/css?family=Rock+Salt 2>&-
@font-face {
  font-family: 'Rock Salt';
  font-style: normal;
  font-weight: normal;
  src: local('Rock Salt'), local('RockSalt'), url('http://themes.googleusercontent.com/static/fonts/rocksalt/v1/Q94aHXFHGip10K5uxi1jOD8E0i7KZn-EPnyo3HZu7kw.woff') format('woff');
}
Для примера. Пусть у меня выбранный шрифт используется в двух фразах: «NEWS» и «ABOUT US», тогда строка запроса для этих двух заголовков будет выглядеть следующим образом (повторяющиеся буквы опущены, «%20» — это пробел):
http://fonts.googleapis.com/css?family=Rock+Salt&text=%20NEWSABOUTЕсли сравнить размер шрифта без указания используемых букв и с ними, то разница выйдет более чем существенная:
bolk@Bolk ~/Projects/Ttt/exp (master) $ wget -O- `wget -O- 'http://fonts.googleapis.com/css?family=Rock+Salt' 2>&- | awk -F' '/http/{print $6}'` 2>&- | wc -c
  125136
bolk@Bolk ~/Projects/Ttt/exp (master) $ wget -O- `wget -O- 'http://fonts.googleapis.com/css?family=Rock+Salt&text=%20NEWSABOUT' 2>&- | awk -F' '/http/{print $6}'` 2>&- | wc -c
    6801
Как видно, размер файла сократился более чем в 18 раз!
Казань ✈ Москва ✈ Казань
19 и 20 октября буду в Москве, на отраслевой конференции «Осенний
Признаюсь честно, я — робот
Не смог я пройти тест Тьюринга.
Санскрит
Спасибо Илье Бирману за ссылку на потрясающую лекцию академика Андрея Анатольевича Зализняка про санскрит «О языке древней Индии». Я, кстати, пребывал в заблуждении, что санскрит — прадедушка большинства европейских языков, тех что называют индоевропейскими. Оказывается, нет:
И сейчас прекрасно известно, что
всё-таки санскрит — это просто одна из ветвей индоевропейских языков; он не более праязык, чем любой другой известный нам язык, а настоящий праязык индоевропейцев в подлинном своем виде ни в каких письменных документах не сохранился. И вообще этот праязык на несколько тысяч лет глубже во времени, чем любой самый древний письменный памятник, которым мы располагаем. А все индоевропейские языки к моменту, от которого до нас доходят какие бы то ни было памятники, уже прошли даже не несколько веков, а несколько тысячелетий развития от общего праязыка.
Лекция действительно интересная, я насладился хорошим литературным языком, которым она изложена и провёл много параллелей со своим прежним опытом. Вот истоки восточной витееватости, последствия разделения литературного языка и языка плебеев:
С другой стороны, потребность выражаться изысканно ведет к тому, что в хорошем классическом санскрите корову никто коровой не назовет. А назовут ее обязательно
какой-нибудь «пестроходящей», «молочноглазой» и т. д. Змея никогда не будет названа змеей, хотя для этого есть прекрасное простое слово, родственное русскому. Но это слово простецкое, низкое, в хорошей литературе оно употребляться не должно, это был бы низкий плебейский стиль.
Вот почему в литовском (который очень близок к санскриту) часто слышно окончание
Так вот, литовский занял бы первое место среди живых языков по сохранности древнего числа слогов. Он сохранил окончание именительного падежа -ас. Ростов будет
по-литовски Ростовас. Почему? Потому что это -ас так же необходимо в современном литовском, как и три тысячи лет назад в санскрите.
Теория относительности
Сейчас много разговоров о том, что в одном из экспериментов скорость нейтирино оказалась выше скорости света. Якобы, это ставит под сомнение теорию относительности Эйнштейна.
Чтобы вспомнить что такое теория относительности, рекомендую
Поддержка MJPEG в «Опере»
Как я уже писал, «Опера» иначе показывает MJPEG, не как остальные браузеры. Если открыть
А мне хочется смотреть
Вдохновившись библиотекой добавляющей нативную поддержку APNG в браузер, я подумал, что я ничем не хуже и смогу добавить поддержку MJPEG в «Оперу». Получился небольшой userjs, который я, естественно, выложил на «Гитхаб».
Идея такая — находим картинку во всех тегах IMG, у которой расширение «mjpg». Через XHR получаем с сервера видеопоток, копим кадр, подменяем найденную картинку и так далее.
Работает начиная с 12 версии браузера, которая ещё не вышла (кстати, в позавчерашней сборке сломали userjs напрочь) — в предыдущих версиях XHR слабоват по возможностям для этого.
Больше всего я бился с декодированием бинарных данных. Последняя версия «Оперы» поддерживает тип ответа arraybuffer (а вот blob не поддерживается), но если его выбрать, то данные в цикле
Кстати, быстрее всего у меня получилось декодировать не циклом, а регулярными выражениями, дальше тормозит уже не мой код, а способ получения отдельного кадра — каждый раз я соединяюсь с сервером заново. Можно бы накапливать кадры пачкой и потом их сбрасывать, но у меня нет задачи смотреть трансляции футбола, у меня дом, который не бегает и полученной скорости мне вполне хватает
В общем, получился довольно небольшой код — 94 строки. Если вы не в курсе как устанавливаются скрипты userjs, то это очень просто. В интернете есть много инструкций на эту тему. Только напоминаю, что «Опера» нужна двенадцатая, причём в сборке за седьмое октября userjs сломаны.Посмотреть код.
// ==UserScript==
// @name        MJPEG+Opera - Add to Opera MJPEG support
// @author      Evgeny Stepanischev aka Bolk
// @version     1.00
// @namespace   /files/opera-mjpeg.js
// @modified    2011-10-09
// @include     *
// ==/UserScript==

opera.addEventListener('BeforeEvent.DOMContentLoaded', function() {
    if (opera.version() < 12) return;

    var BolkMJpeg = function (url, img) {
        var req = new XMLHttpRequest();
        img.src = 'about:blank'; // Сброс картинки, чтобы прекратить передачу

        // Асинхронно забираем кадр при помощи XHR, нам придёт видеопоток
        var start = function (url) {
            req.open("GET", url, true);
             // Свежепридуманный хитрый хак, позволяет получить данные в UCS-2
            req.overrideMimeType('image/jpeg');
            req.send(null);
        }

        // Хитрыми путями восстанавливаем порядок байт в reponse, там сейчас UCS-2,
        // получаем просто последовательность байт
        var reqbytes = function (n, l) {
            return escape(req.response.substr(n, l)).
                replace(/([^%]|%[^u].|%u....)/g, '<$1>').
                replace(/<%u(..)(..)>/g, '%$2%$1').
                replace(/<%(..)>/g, '%$1%00').
                replace(/<(.)>/g, '$1%00');
        }

        // заменяем картинку на бинарные данные
        var draw = function (bin) {
            img.src = 'data:image/jpeg,' + bin;
        }

        // На изменение состояние входных данных собираем по частям JPEG
        req.onreadystatechange = function () {
            // состояние «3» — данные пошли, но ещё не кончились
            if (req.readyState === 3) {
                var hnd = setInterval(function () {
                    // по заголовку получаем размер данных
                    var header = unescape(reqbytes(0, 300)).toLowerCase();

                    var idx = header.indexOf('content-length:');

                    if (idx > -1) {
                        // 15 — длина заголовка
                        var len = parseInt(header.substr(idx + 15), 10);
                        var headend = header.indexOf("\r\n\r\n");

                        // дожидаемся конца заголовка
                        if (headend > -1) {
                            var resp = reqbytes(0, len);
                            // умножаем всё на три, так как reqbytes даёт esc-последовательность
                            // вида %XX%XX…
                            len *= 3;
                            headend = (headend + 4) * 3;

                            // если собрали весь JPEG, обрываем соединение
                            // и начинаем новый цикл. Мы могли бы собирать кадры и дальше, но
                            // это съест всю память со временем
                            if (resp.length >= len + headend) {
                                req.abort();
                                resp = resp.substr(headend, len);

                                draw(resp);
                                clearInterval(hnd);

                                start(url);
                            }
                        }
                    }
                }, 100);
            }
        }

        start(url);
    };

    // ищем картинку, у которой расширение mjpg
    var imgs = document.getElementsByTagName('IMG');
    for (var i = 0, len = imgs.length; i<len; i++) {
        if (/\.mjpg$/.test(imgs[i].src)) {
            BolkMJpeg(imgs[i].src, imgs[i]);
            break;
        }
    }
}, true);
Невероятно плохо
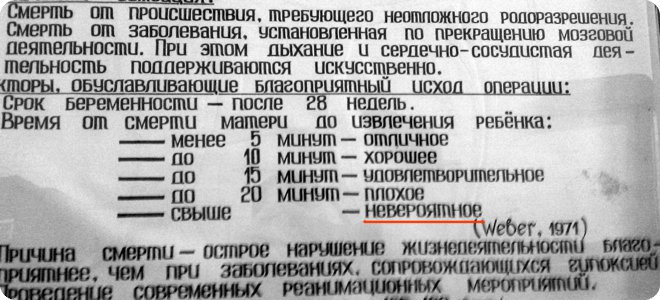
Кажется я никогда не сталкивался с тем, чтобы отдельностоящее слово «невероятно» использовали для отрицательной оценки. «Невероятно», во всех случаях употребления без богатой эмоциональной обвязки вокруг однозначно воспринимается мной как восхищение.
Фотография сделана в третьем роддом города Казани, с одного из плакатов около
MJPEG, MPNG, MGIF, MSVG
Я вчера показывал вам «телевизор» про фестиваль в Самаре. Сделано очень просто — уменьшил все сделанные там снимки до 66×44 и сконвертировал их в анимированный ГИФ. Мелковато, конечно, но что делать — ГИФ
У JPEG есть свой формат анимации, если так можно выразиться, а точнее — скорее простенький формат видео, так как формат анимации, в моём представлении, помимо кадров должен содержать себе
Мне давно хотелось посмотреть что у этого формата внутри, сегодня наконец посмотрел. Всё оказалось крайне просто.
В данном случае, MJPEG — формат стримминга (потоковой подачи) видео. Собственно, это даже не формат, а простое соединение JPEG и специального заголовка
Смысл этого заголовка — содержимое которое пришло раньше заменяется тем, что пришло позже. То есть MJPEG — это просто последовательность картинок, у которых этим заголовком указано — когда приходит следующая картинка, ею надо заменить предыдущую. Внутри выглядит это вот таким образом.
Content-type:  multipart/x-mixed-replace;boundary=СТРОКАРАЗДЕЛИТЕЛЬ

--СТРОКАРАЗДЕЛИТЕЛЬ
Content-type: image/jpeg
Content-length: 232311

…бинарное содержимое первой картинки…

--СТРОКАРАЗДЕЛИТЕЛЬ
Content-type: image/jpeg
Content-length: 47474

…бинарное содержимое второй картинки…
СТРОКУРАЗДЕЛИТЕЛЬ надо выбирать так, чтобы она не встретилась в бинарных данных изображения.
Браузерам этот заголовок достался от фирмы Нетскейп, которая
Например для «Оперы», нужно выдавать данные с задержкой, то есть показали один кадр, ждём пару секунд, ничего с сервера не отдаём, потом следующий. Иначе, «Опера» «хитрит» — показывает следующий кадр, не дожидаясь загрузки предыдущего. Если канал хороший, то мы увидим только последний кадр.
«Файрфокс» единственный, кто хорошо справляется с тем, что кадры могут быть разных размеров — он отображает их правильно, «Опера» масштабирует по первой картинке, «Хром» и «Сафари» глючат — иногда пропускают кадр, иногда ничего не показывают, иногда показывают нормально.
Самое приятное в этом формате — что все современные браузеры считают его картинкой, то есть тег IMG его преспокойно показывает.
Любопытно, что браузеры позволяют сжимать содержимое всего файла и даже каждого кадра отдельно, то есть можно в заголовке кадра поставить
Так что, если вы задумались сделать аналог
Фестиваль «404» в Самаре

Меня тут все спрашивают, как прошёл фестиваль «404» в Самаре. Отлично прошёл, друзья мои! Но у меня совершенно не было времени хотя бы удалить дубли фотографий и выложить оставшееся. Поэтому предлагаю взглянуть на фестиваль в маленькое (66×44) окошко моего импровизированного телевизора. Скорее всего читателям трансляций (в ЖЖ, «Ярушке» и так далее) не будет видно самого телевизора, только картинку, так что заходите на сайт.