Распознаватель «Тессеракт»
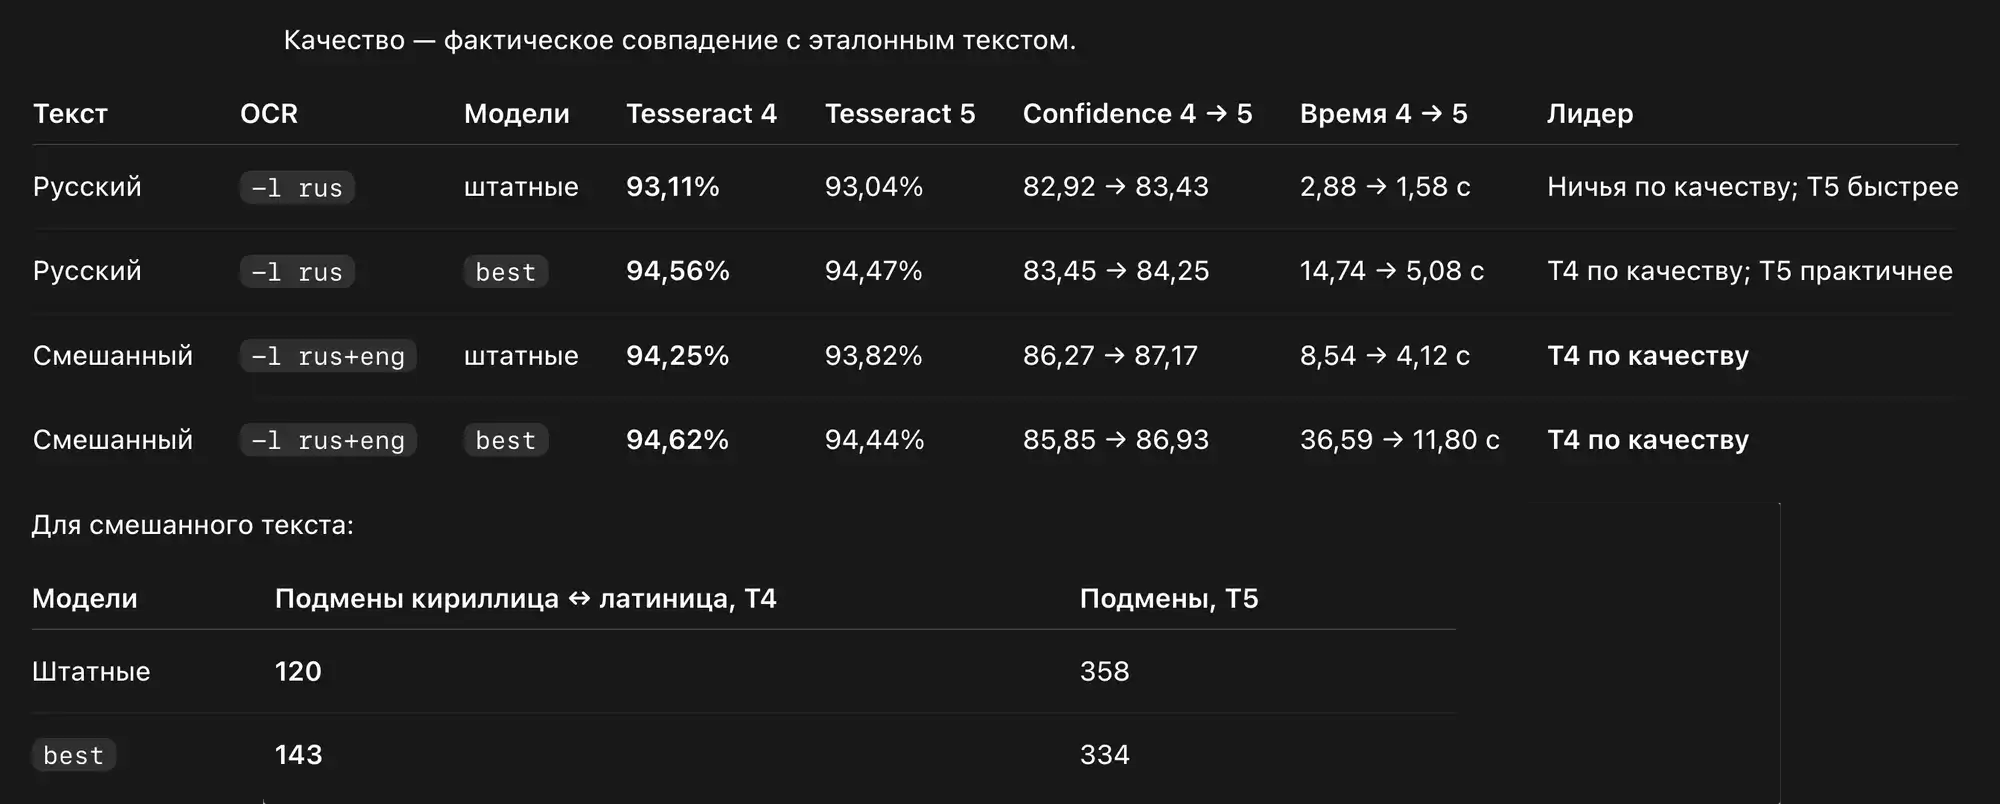
При помощи нейросети протестировал пятую версию «Тессеракта» — проекта с открытым исходным кодом для распознавания текста. Тестировал на двух скачанных книжках, текст которых был переведён в картинки и искусственно зашумлён.
Мы до сих пор используем четвёртую версию, и у меня была надежда, что в пятой версии режим rus+eng, в котором одновременно распознаются русский и английский тексты, работает не так отвратительно, как в предыдущей версии.
Надежда не оправдалась. «Пятёрка» по качеству в этом режиме даже уступает «четвёрке», хотя во всех режимах работает значительно быстрее.