Какая модель у меня запустится?

Как узнать какая нейромодель у запустится на конкретной видеокарте? Вот, например, приходит к нам заказчик и говорит — у нас есть только две Nvidia T4, запустится ли на ней модель, которую вы используете? Как быстро ответить на этот вопрос?

Судя по спецификации, каждая T4 имеет на борту 16 гигабайт видеопамяти. Для целей, на которые нам выделяют видеокарты, мы используем модель Qwen 3-30B, то есть у неё 30 миллиардов параметров.

Каждый параметр хранится в двух байтах, плюс процентов 20 надо накинуть на всякие буферы. В итоге, получается, что нам нужно 30×2+20% = 80 гигабайт. 20% я грубо накидываю, можно вычислять точнее, но для прикидки сойдёт.

Две карты по 16 могут работать вместе, современные фреймворки так умеют, то есть совокупно у нас всего 32 гигабайта. То есть модель не умещается?

Полная модель не уместится, но есть квантованные версии. Дело в том, что модели хранят свои параметры в виде чисел с плавающей точкой. Чем точнее мы храним эти числа, тем лучше работает модель (в своих пределах, конечно). Если памяти у нас мало, хорошее решение — снизить точность. Модель от этого «поглупеет», но это может оказаться некритично.

Мы выбрали квантование в 4 бита, то есть по половинке байта на модель. Таким образом, потребуется 30×0,5+20% = 18 гигабайт. Чуть-чуть не влезаем на одну видеокарту, но прогноз такой, что две должно хватить.

Большую группу пользователей эти видеокарты не вывезут — всё-таки мощность у них невелика, но для небольших организаций (десятки человек) на наших задачах работать будет.
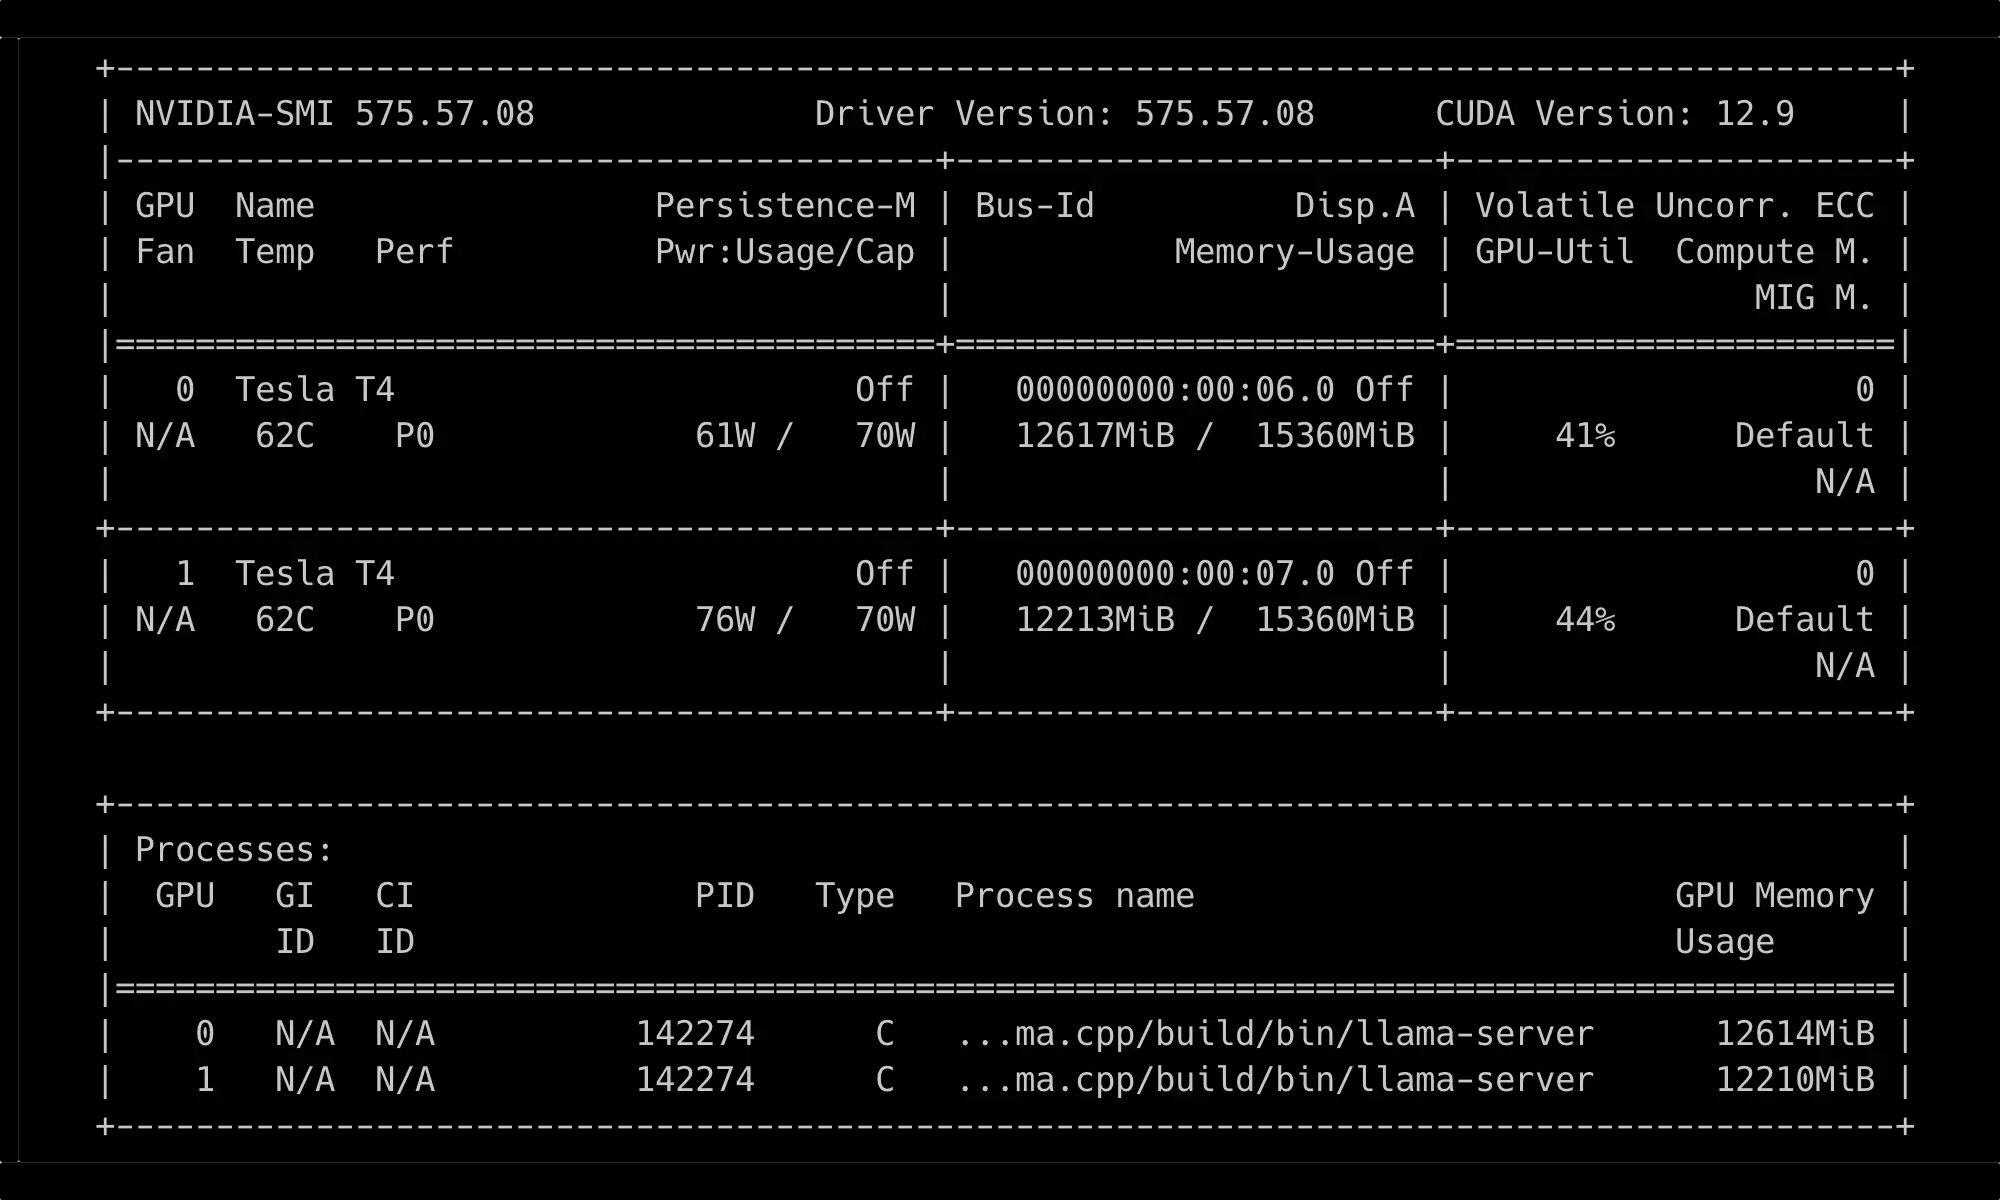
Таблица NVIDIA-SMI: две GPU Tesla T4 (62°C, ~12.6 ГБ VRAM, 41–44% util), процесс llama-server (PID 142274) использует обе карты.
Квантованная модель Qwen3-30B, работающая на 2×Nvidia T4 16 ГБ

Комментарии 11

Oleg № 1
Похоже, это расчет для контекста в 8k токенов. Не слишком полезно под задачи agentic coding, например. Модель вообще-то поддерживает до 128k. Но в этом случае, выходит нужно уже 130 гигов! Не хило.

https://apxml.com/models/qwen3-30b-a3b
Евгений Степанищев автор № 2
Для скромных задач в данном случае модель, да. Но и карты очень старые.
Oleg № 3
Но можно использовать ОЗУ, насколько я понимаю. Цена — более низкий показатель tokens-per-second.
Евгений Степанищев автор № 4
Это выход для одного пользователя с высоким уровнем терпения :) называется cpu offload, да)
Oleg № 5
Хорошая статья на эту тему: https://medium.com/@lyx_62906/context-kill … 85e8035632
Евгений Степанищев автор № 6
Я всё это знаю, но моя цель была рассказать как сделать быструю прикидку. Ну и кроме того, на скриншоте масса документации по поводу того как вообще эта модель запустилась, а то иногда перебирать версии — долго очень.
Oleg № 8
Это понятно. :) Просто часто натыкаюсь на статьи, в которых запускают большие модели на относительно скромном железе. При это оказывается, что модель квантизованная, а контекст — всего 8k. Пользователь, привыкший к полной облачной версии, будет разочарован. Хотя если это все учтено в требованиях, то проблем, конечно же, нет.
Евгений Степанищев автор № 9
Тут, кстати, что-то мне вспоминается, контекст был больше. Если не ошибаюсь, что-то вроде 32к.

Ну и тут молель у нас не для чата используется, так что пользователи и не знают насколько она простенькая.
sarman № 10
Доброго! Вот такая статья попадалась недавно, может пригодится

https://apxml.com/posts/best-local-llms-fo … series-gpu
Евгений Степанищев автор № 11
Спасибо! Смысл тех расчётов, что я дал — быстро прикинуть практически в уме. Как я уже писал, можно, конечно, и точнее считать.