Ещё про «Словохват»
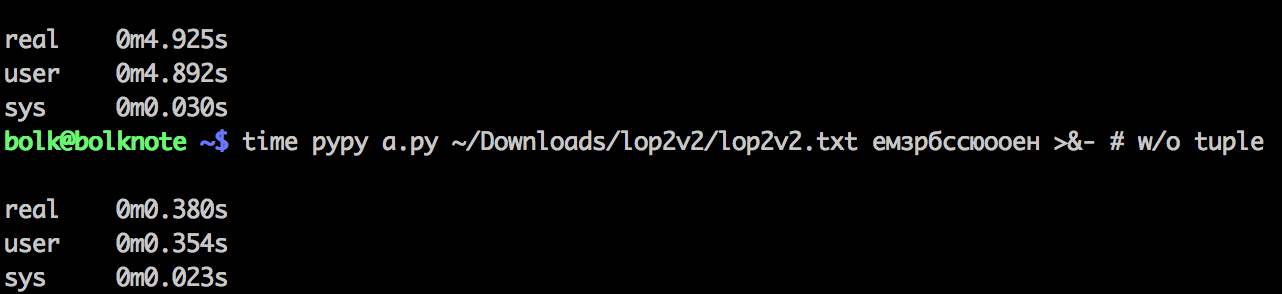
Хорошая иллюстрация на тему как можно ускорить программу на порядок, убрав из неё одно слово. Первый и второй запуск отличаются только одним — в первом случае в моей программе для игры в «Словохват» присутствует преобразование типа set в tuple, а во втором этого нет.
Поиск наличия значения в set происходит многократное быстрее.
Кстати, в «Словохвате» можно использовать ещё и названия городов, а в моём словаре их нет. Но ничего не мешает использовать два и более словаря. Например, я скачал первый попавшийся словарь российских городов (он там в формате Экселя) и теперь использую и его:
cat <(unzip -p /Users/bolk/Downloads/spisokl-gorodov.xlsx xl/sharedStrings.xml |
awk -v RS=t '/^>.*<\/$/ {gsub("[<>/]", ""); print $0}' |
tr "[:upper:]" "[:lower:]" |
iconv -f utf8 -t cp1251) ~/Downloads/lop2v2/lop2v2.txt |
pypy slovohod.py /dev/stdin моибуквы
Комментарии 10
что нужно курить, чтобы такое написать? огурец?
Если человек один раз пишет «словарь» и один «словоря», логично же, что это описка и человек просто её не заметил.
аааа…
Молодец, не обязательно было об этом сообщать в мой блог.